

昨天改了落地頁標題,今天營運問:「那個關鍵字漲了嗎?」你打開搜尋頁,找了半天,又開始懷疑是不是地區、語言或者搜尋時間不同。手動查一次不難,難的是每天用同一個口徑查,留下記錄,還能解釋某天為什麼沒資料。
自己抓搜尋頁面也能做,但你原本想監測排名,最後卻在維護頁面選擇器、代理和異常重試。對只有幾十個關鍵字的小團隊,更合適的起點可能是:把搜尋結果交給 SERP API,自己只維護監測規則和歷史記錄。

AI 生成示意,不代表真實排名資料。
¶ 先說清楚,你到底在監測哪個排名
這裡做的是「在指定國家、語言和本次返回的自然搜尋結果裡,目標網域排在哪裡」。不是所有使用者都會看到的唯一排名,也不是廣告位、地圖位或整張頁面的像素位置。
AceDataCloud 的 Google SERP 介面使用 POST https://api.acedata.cloud/serp/google。自然搜尋結果在 organic 中,項目包含 link 和 position。請求可指定查詢詞、國家、語言及分頁等條件。欄位應以目前介面文件為準。Google SERP API
本例固定 type=search、country=us、language=en、page=1、number=10。這樣範圍夠小,容易覆核。不要今天查美國英語,明天查英國英語,卻把兩天的值連成一條趨勢線。
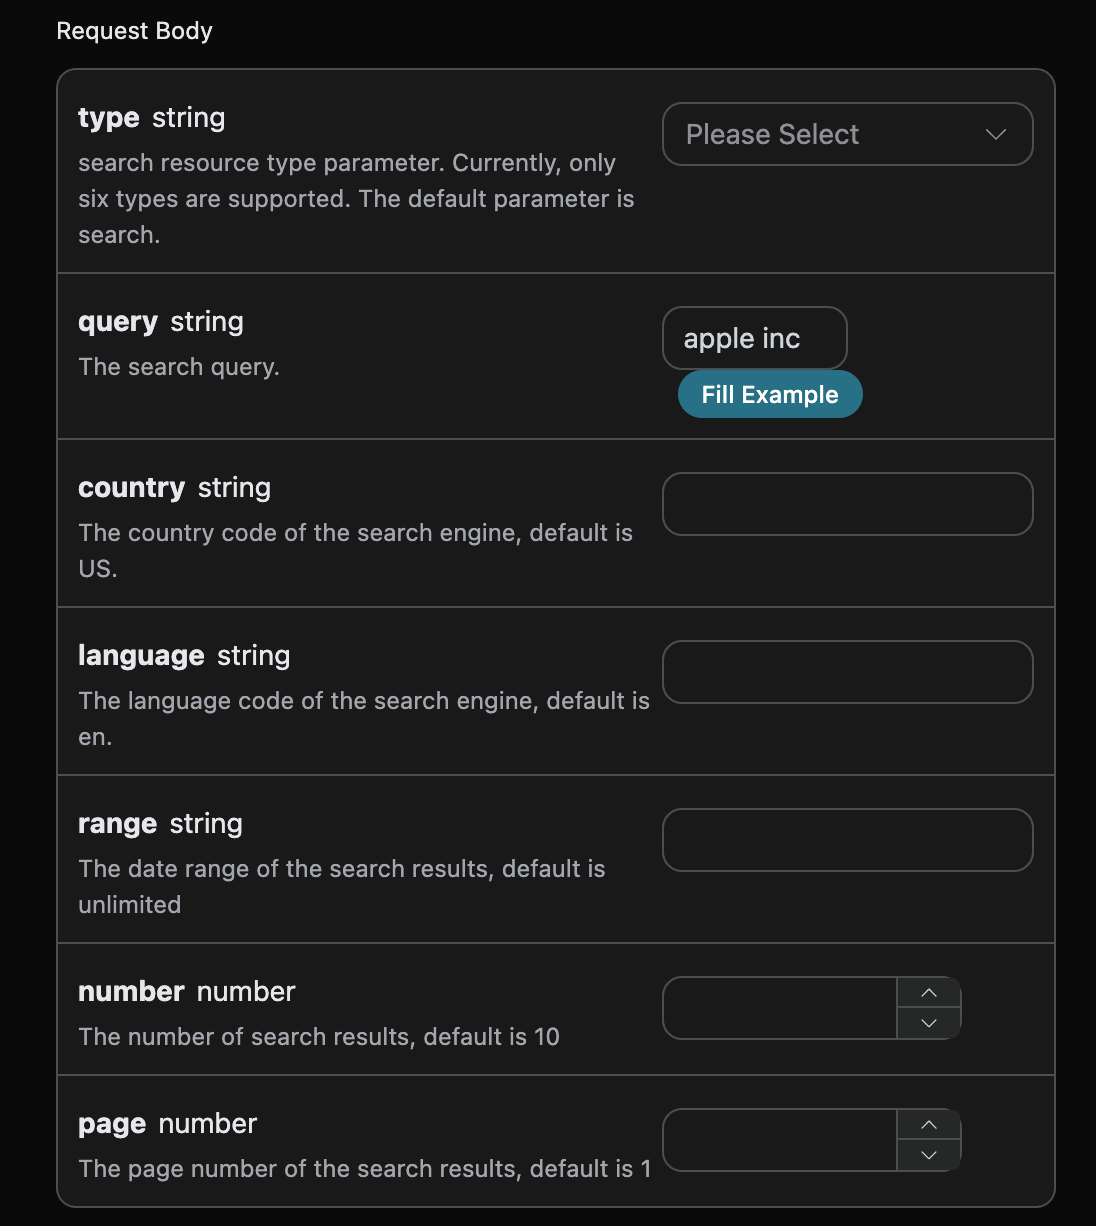
官方參數表單截圖;目前欄位以文件為準。
還有一個特別容易做錯的地方:返回十條結果,卻沒找到自己的網域,不能記成「介面失敗」,也不能直接補成第十一名。你只知道它沒有出現在這次返回的集合裡,不知道它在集合之外排在哪裡。
建議儲存三種狀態:found 表示找到並記錄位置;not_found_in_response 表示介面正常返回但未命中;error 表示請求、解碼或結構驗證出了問題。位置未知時寫空值,不寫 0、999,也不拿它算平均排名。
¶ 用一個腳本,把請求和結果留下來
下面的完整範例依賴 Python 3 和 requests,使用 Python 內建的 SQLite 儲存結果。將腳本儲存為 seo_monitor.py,在同目錄建立 keywords.json,把佔位網域換成要監測的網域,而不是帶路徑的頁面網址:
[
  {"query":"reusable travel tumbler","target":"example.com","country":"us","language":"en"}
]
API Key 從自己的應用程式裡取得,透過 ACEDATACLOUD_API_KEY 環境變數提供;不要寫進 JSON、腳本或截圖。安裝依賴後執行腳本:
python -m pip install 'requests>=2.31,<3'
python seo_monitor.py
首次使用應先用一個關鍵字做真實聯調,再擴大範圍。
import json
import os
import sqlite3
from datetime import datetime, timezone
from pathlib import Path
from urllib.parse import urlparse
import requests

ROOT = Path(__file__).resolve().parent

def host(value):
    parsed = urlparse(value if "://" in value else "https://" + value)
    return (parsed.hostname or "").lower().rstrip(".").encode("idna").decode("ascii")

def match(url, target):
    h = host(url)
    return h == target or h.endswith("." + target)

def rank(data, target):
    if not isinstance(data, dict) or data.get("error") or data.get("success") is False:
        raise ValueError("API failure")
    rows = data.get("organic")
    if not isinstance(rows, list):
        raise ValueError("organic missing or invalid")
    hits = []
    for row in rows:
        if not isinstance(row, dict):
            raise ValueError("invalid organic item")
        p, link = row.get("position"), row.get("link")
        if type(p) is not int or p < 1 or not isinstance(link, str):
            raise ValueError("invalid position/link")
        parsed = urlparse(link)
        if parsed.scheme not in ("http", "https") or not parsed.hostname:
            raise ValueError("invalid result URL")
        if match(link, target):
            hits.append((p, link))
    return min(hits) if hits else (None, None)

def main():
    token = os.environ["ACEDATACLOUD_API_KEY"]
    tasks = json.loads((ROOT / "keywords.json").read_text(encoding="utf-8"))
    db = sqlite3.connect(ROOT / "rankings.sqlite3")
    db.execute("""CREATE TABLE IF NOT EXISTS checks (
        checked_at TEXT, keyword TEXT, target TEXT, country TEXT,
        language TEXT, page INTEGER, requested_number INTEGER,
        returned_number INTEGER, status TEXT, position INTEGER,
        landing_url TEXT, error TEXT, raw_json TEXT)""")
    failures = 0
    with requests.Session() as session:
        session.headers.update({"Authorization": "Bearer " + token})
        for task in tasks:
            target = host(task["target"])
            if not target:
                raise ValueError("target must be a domain")
            payload = {"type": "search", "query": task["query"],
                       "country": task["country"], "language": task["language"],
                       "number": 10, "page": 1}
            stamp = datetime.now(timezone.utc).isoformat()
            status, p, link, error, raw, count = "error", None, None, None, None, None
            try:
                r = session.post("https://api.acedata.cloud/serp/google",
                                 json=payload, timeout=(10, 60))
                r.raise_for_status()
                data = r.json()
                raw = json.dumps(data, ensure_ascii=False)
                p, link = rank(data, target)
                count = len(data["organic"])
                status = "found" if p is not None else "not_found_in_response"
            except (requests.RequestException, ValueError) as exc:
                error = type(exc).__name__
                if isinstance(exc, requests.HTTPError) and exc.response is not None:
                    error += ": HTTP " + str(exc.response.status_code)
                failures += 1
            db.execute("INSERT INTO checks VALUES (?,?,?,?,?,?,?,?,?,?,?,?,?)",
                       (stamp, task["query"], target, task["country"], task["language"],
                        1, 10, count, status, p, link, error, raw))
            db.commit()
            print(task["query"], status, p if p is not None else "-")
    db.close()
    raise SystemExit(1 if failures else 0)

if __name__ == "__main__":
    main()
rank 內部會檢查資料類型、網址和位置欄位。缺少 organic 的回應被當作異常;空陣列則是正常的空結果。網域比對使用 URL 的 hostname,不做字串包含判斷,否則 notexample.com 也可能被誤認為 example.com。
本例包含子網域:shop.example.com 可以命中 example.com。如果你只關心主站,改為嚴格相等;如果關注某一篇文章,再增加路徑正規化規則。不要沒商量口徑,就把全站最佳位置當成某個頁面的位置。
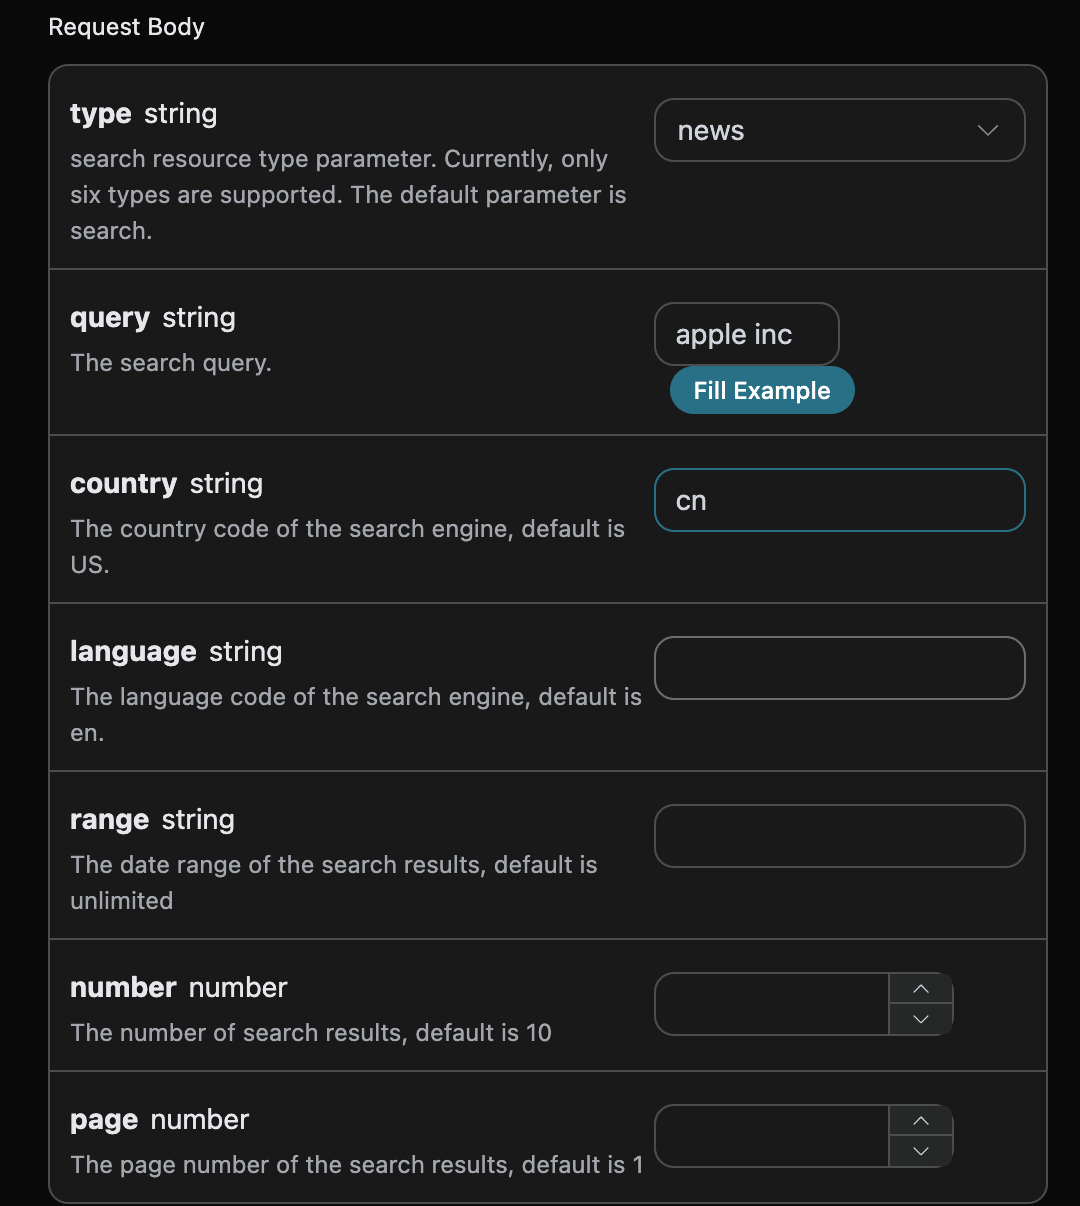
地區、語言等搜尋條件應隨監測記錄一同儲存。
每次檢查都會寫入時間、關鍵字、網域、國家、語言、頁碼、請求數量、實際回傳數量、狀態、位置、到達頁、錯誤類別和原始 JSON。記錄使用 UTC 時間,報表展示時再統一轉換成本地時區。原始回應留在自己的儲存空間裡,便於追溯,不要直接公開整個資料庫。
指令碼不會列印請求標頭。HTTP 例外只記錄錯誤類別和狀態碼;任一關鍵字失敗,程序最終回傳非零結束碼,方便排程器告警。它沒有自動重試,這是刻意的:先讓失敗被看見,再根據服務限流規則加入有上限的退避,比無限重複請求更可控。
¶ 每天自動執行,不等於每天自動下結論
在自己的常開伺服器上,可以用 cron 或現有工作排程器每天觸發一次。以下是 Linux cron 範例,不是已經替你設定好的工作:
0 9 * * * /opt/seo/.venv/bin/python /opt/seo/seo_monitor.py >> /opt/seo/run.log 2>&1
執行時間依伺服器的 cron 時區解讀。Python 路徑、指令碼路徑要換成實際部署位置;憑證需要在排程程序的受保護環境中設定。互動式終端機裡有環境變數,不代表 cron 會自動繼承。上線前請使用相同執行使用者測試,並限制日誌權限、設定輪替,防止工作重疊。
查看結果時,先看成功率,再看排名。兩次都命中、搜尋條件相同,才比較位置差。昨天第八、今天第五,可以說這兩次觀測上升三位;今天沒命中,只能說本次結果未檢出。若回傳數量突然從十筆變成兩筆,還要先排除回傳集合變化的影響。
需要多頁監測時,儲存每頁原始結果,核對介面 position 的實際語意,再設計跨頁去重。別未經驗證就用「頁碼乘十」拼出全域排名。本例刻意只查首屏,就是為了不給讀者一個看似完整、實際口徑錯誤的排行榜。
請求預算可以按「關鍵字數 × 搜尋條件組合數 × 頁數 × 每日次數」估算。它是請求量,不直接等於帳單;單次費用、回傳數量級距及失敗計費規則仍需以服務當時的說明和用量記錄核對。
¶ 真正省下來的,是維護搜尋頁面的時間
這個指令碼不承諾改善 SEO,也不推斷某次頁面修改導致了排名變化。它提供的是一個能追溯、能區分失敗與未命中的觀察基礎。需要更長期的判斷,再把內容改動、網站指標和連續觀測放在一起分析。
先挑幾個業務最關心的詞跑一週,核對每種狀態有沒有被正確記錄,比第一天做一個漂亮的大螢幕更重要。SERP API 接管結果取得,你把精力留給關鍵字和頁面本身。
**驗證範圍:**範例程式碼完成離線編譯檢查及網域比對、命中、空結果、例外結構斷言;沒有執行真實付費 SERP 請求,沒有部署伺服器或定時工作。文中沒有真實排名或效果資料。