

Вчера изменили заголовок лендинга, сегодня операционный менеджер спрашивает: «Тот ключевой запрос вырос?» Вы открываете страницу поиска, долго ищете и снова начинаете сомневаться, не отличаются ли регион, язык или время поиска. Проверить вручную один раз несложно, сложно каждый день проверять по одним и тем же критериям, оставлять записи и ещё объяснять, почему в какой-то день нет данных.
Можно и самостоятельно парсить страницы поиска, но изначально вы хотели отслеживать позиции, а в итоге поддерживаете селекторы страницы, прокси и повторные попытки при ошибках. Для небольшой команды с несколькими десятками ключевых слов более подходящей отправной точкой может быть следующее: передать результаты поиска SERP API, а самостоятельно поддерживать только правила мониторинга и историю записей.

Иллюстрация, сгенерированная ИИ, не представляет реальные данные о позициях.
¶ Сначала уточните, какую именно позицию вы отслеживаете
Здесь отслеживается «на каком месте находится целевой домен среди органических результатов поиска, возвращённых в этот раз для указанной страны и языка». Это не единственная позиция, которую видят все пользователи, и не рекламные блоки, блоки карт или пиксельная позиция на всей странице.
Google SERP API от AceDataCloud использует POST https://api.acedata.cloud/serp/google. Органические результаты поиска находятся в organic, а элементы содержат link и position. В запросе можно указать ключевой запрос, страну, язык и условия пагинации и т. д. Поля следует сверять с текущей документацией интерфейса. Google SERP API
В этом примере фиксируются type=search, country=us, language=en, page=1, number=10. Так область достаточно мала и её легко перепроверить. Не проверяйте сегодня английский язык США, а завтра английский язык Великобритании, а затем не соединяйте значения за эти два дня в одну линию тренда.
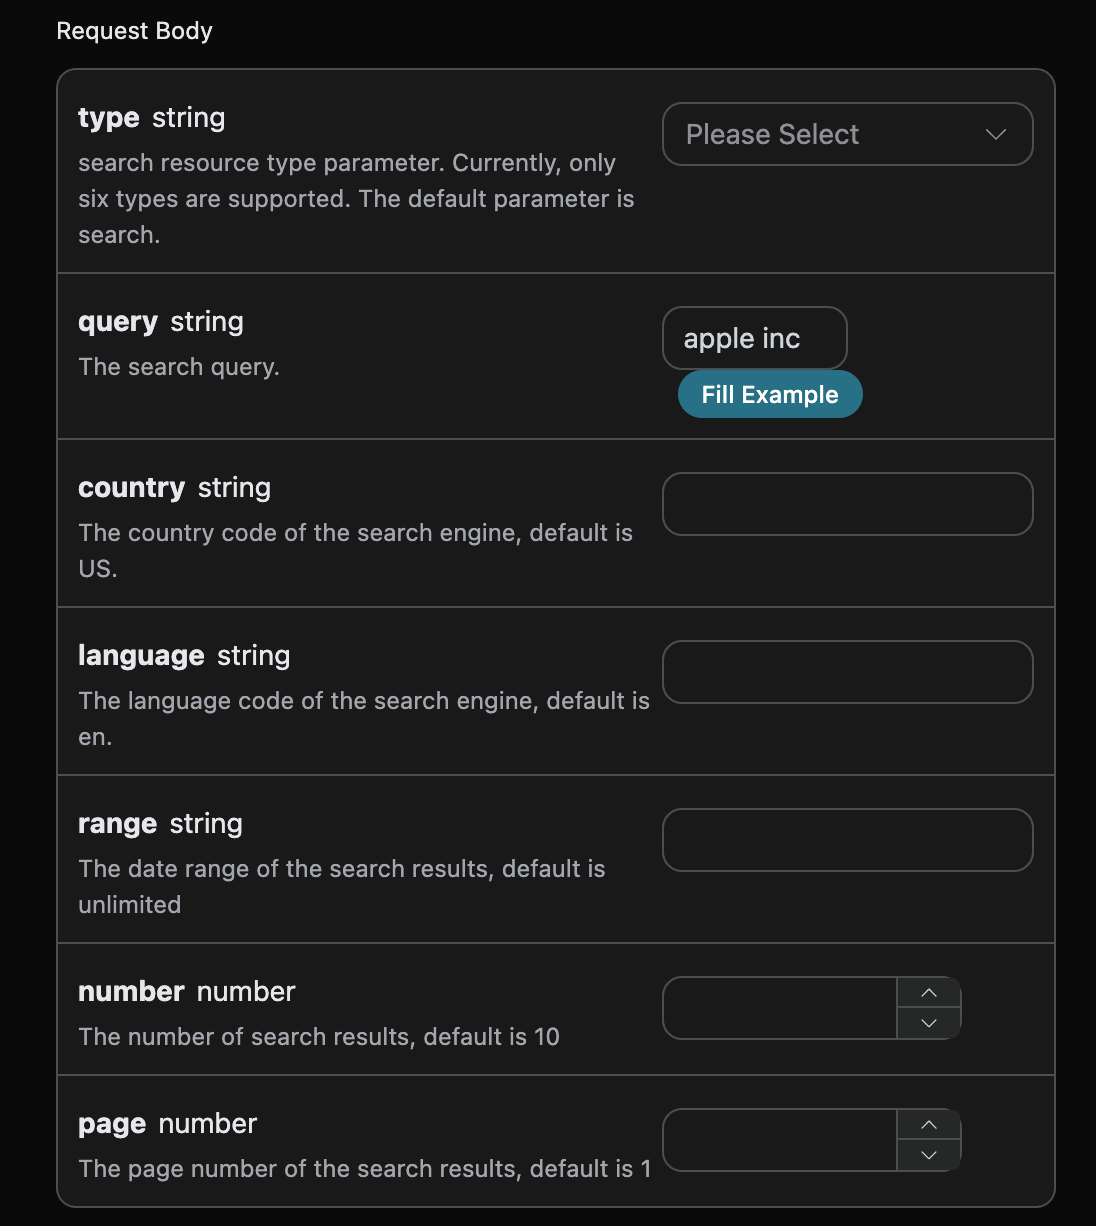
Скриншот официальной формы параметров; актуальные поля следует сверять с документацией.
Есть ещё один момент, в котором особенно легко ошибиться: если вернулось десять результатов, но ваш домен не найден, это нельзя записывать как «сбой интерфейса» и нельзя сразу подставлять одиннадцатое место. Вы знаете только, что он не появился в наборе, возвращённом в этот раз, но не знаете, какое место он занимает за пределами этого набора.
Рекомендуется сохранять три статуса: found означает, что результат найден и позиция записана; not_found_in_response означает, что интерфейс нормально ответил, но совпадение не найдено; error означает, что произошла проблема с запросом, декодированием или проверкой структуры. Когда позиция неизвестна, записывайте пустое значение, не пишите 0 или 999 и не используйте его для расчёта средней позиции.
¶ Одним скриптом сохраняйте запросы и результаты
Приведённый ниже полный пример зависит от Python 3 и requests, для сохранения результатов используется встроенный в Python SQLite. Сохраните скрипт как seo_monitor.py, создайте в той же директории keywords.json, замените домен-заполнитель на домен, который нужно отслеживать, а не на адрес страницы с путём:
[
  {"query":"reusable travel tumbler","target":"example.com","country":"us","language":"en"}
]
API Key получите из собственного приложения и передавайте через переменную окружения ACEDATACLOUD_API_KEY; не записывайте его в JSON, скрипт или скриншоты. После установки зависимостей запустите скрипт:
python -m pip install 'requests>=2.31,<3'
python seo_monitor.py
При первом использовании сначала следует провести реальную интеграционную проверку с одним ключевым словом, а затем расширять охват.
import json
import os
import sqlite3
from datetime import datetime, timezone
from pathlib import Path
from urllib.parse import urlparse
import requests

ROOT = Path(__file__).resolve().parent

def host(value):
    parsed = urlparse(value if "://" in value else "https://" + value)
    return (parsed.hostname or "").lower().rstrip(".").encode("idna").decode("ascii")

def match(url, target):
    h = host(url)
    return h == target or h.endswith("." + target)

def rank(data, target):
    if not isinstance(data, dict) or data.get("error") or data.get("success") is False:
        raise ValueError("API failure")
    rows = data.get("organic")
    if not isinstance(rows, list):
        raise ValueError("organic missing or invalid")
    hits = []
    for row in rows:
        if not isinstance(row, dict):
            raise ValueError("invalid organic item")
        p, link = row.get("position"), row.get("link")
        if type(p) is not int or p < 1 or not isinstance(link, str):
            raise ValueError("invalid position/link")
        parsed = urlparse(link)
        if parsed.scheme not in ("http", "https") or not parsed.hostname:
            raise ValueError("invalid result URL")
        if match(link, target):
            hits.append((p, link))
    return min(hits) if hits else (None, None)

def main():
    token = os.environ["ACEDATACLOUD_API_KEY"]
    tasks = json.loads((ROOT / "keywords.json").read_text(encoding="utf-8"))
    db = sqlite3.connect(ROOT / "rankings.sqlite3")
    db.execute("""CREATE TABLE IF NOT EXISTS checks (
        checked_at TEXT, keyword TEXT, target TEXT, country TEXT,
        language TEXT, page INTEGER, requested_number INTEGER,
        returned_number INTEGER, status TEXT, position INTEGER,
        landing_url TEXT, error TEXT, raw_json TEXT)""")
    failures = 0
    with requests.Session() as session:
        session.headers.update({"Authorization": "Bearer " + token})
        for task in tasks:
            target = host(task["target"])
            if not target:
                raise ValueError("target must be a domain")
            payload = {"type": "search", "query": task["query"],
                       "country": task["country"], "language": task["language"],
                       "number": 10, "page": 1}
            stamp = datetime.now(timezone.utc).isoformat()
            status, p, link, error, raw, count = "error", None, None, None, None, None
            try:
                r = session.post("https://api.acedata.cloud/serp/google",
                                 json=payload, timeout=(10, 60))
                r.raise_for_status()
                data = r.json()
                raw = json.dumps(data, ensure_ascii=False)
                p, link = rank(data, target)
                count = len(data["organic"])
                status = "found" if p is not None else "not_found_in_response"
            except (requests.RequestException, ValueError) as exc:
                error = type(exc).__name__
                if isinstance(exc, requests.HTTPError) and exc.response is not None:
                    error += ": HTTP " + str(exc.response.status_code)
                failures += 1
            db.execute("INSERT INTO checks VALUES (?,?,?,?,?,?,?,?,?,?,?,?,?)",
                       (stamp, task["query"], target, task["country"], task["language"],
                        1, 10, count, status, p, link, error, raw))
            db.commit()
            print(task["query"], status, p if p is not None else "-")
    db.close()
    raise SystemExit(1 if failures else 0)

if __name__ == "__main__":
    main()
Внутри rank проверяются типы данных, URL и поле позиции. Ответ без organic считается исключением; пустой массив, напротив, является нормальным пустым результатом. Для сопоставления доменов используется hostname из URL, а не проверка вхождения строки, иначе notexample.com тоже может быть ошибочно принят за example.com.
Этот пример включает поддомены: shop.example.com может совпасть с example.com. Если вас интересует только основной сайт, замените условие на строгое равенство; если отслеживается конкретная статья, дополнительно добавьте правила нормализации пути. Не согласовав критерии, не принимайте лучшую позицию по всему сайту за позицию конкретной страницы.
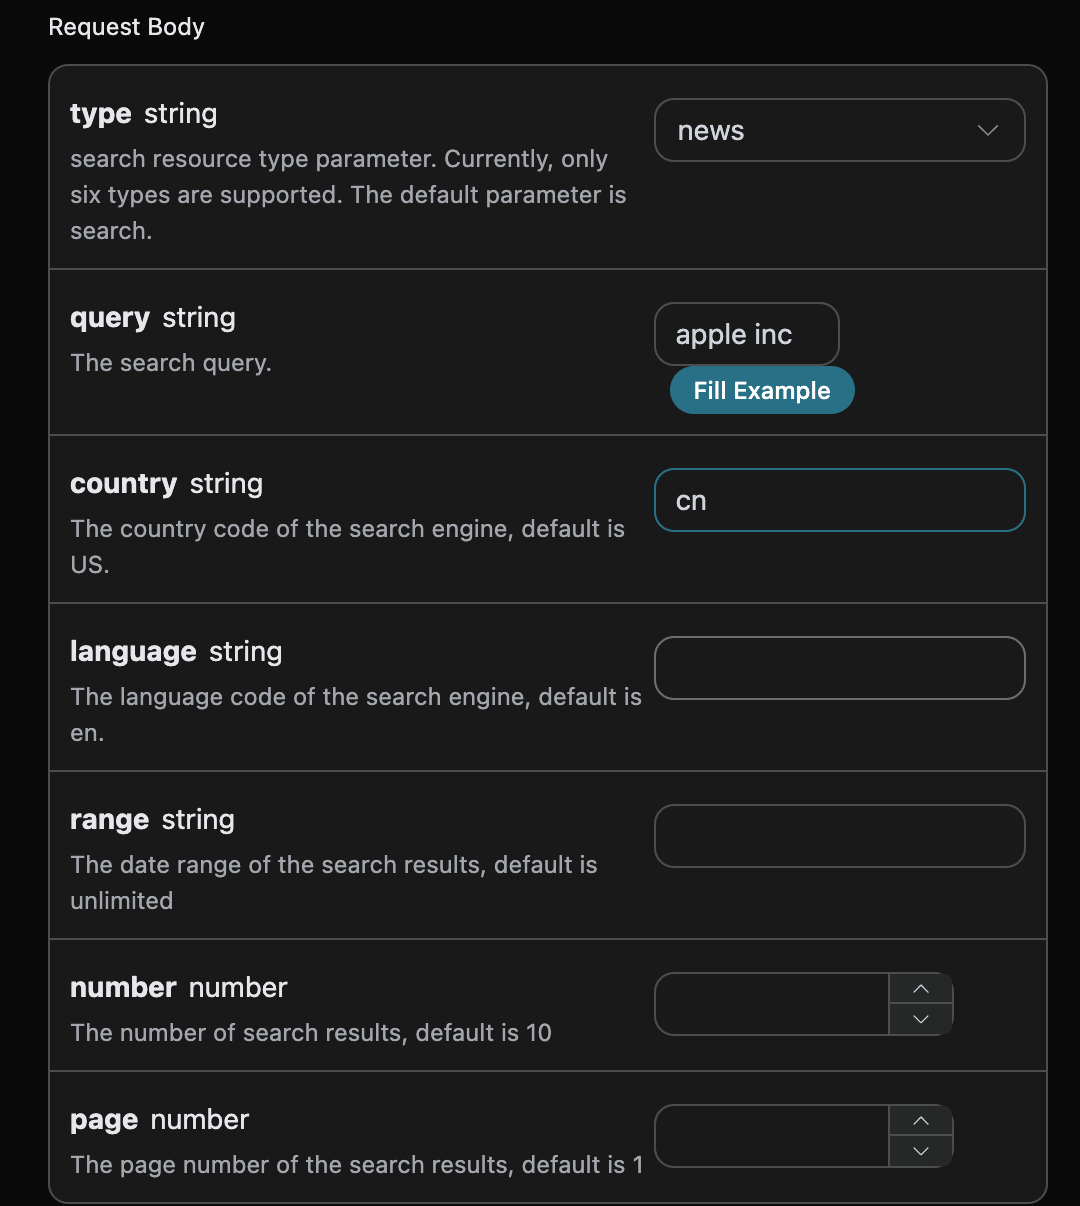
Условия поиска, такие как регион и язык, следует сохранять вместе с записями мониторинга.
Каждая проверка записывает время, ключевое слово, домен, страну, язык, номер страницы, количество запросов, фактическое количество возвращённых результатов, статус, позицию, целевую страницу, категорию ошибки и исходный JSON. Записи ведутся по времени UTC, а при отображении в отчётах затем единообразно переводятся в локальный часовой пояс. Исходные ответы остаются в собственном хранилище для возможности отслеживания; не публикуйте напрямую всю базу данных.
Скрипт не выводит заголовки запросов. При HTTP-исключениях записываются только категория ошибки и код статуса; если хотя бы одно ключевое слово завершается сбоем, процесс в итоге возвращает ненулевой код выхода, чтобы планировщик мог отправить предупреждение. В нём нет автоматических повторных попыток, и это намеренно: сначала нужно увидеть сбой, а затем добавлять ограниченную задержку в соответствии с правилами ограничения сервиса — это более управляемо, чем бесконечно повторять запросы.
¶ Автоматический ежедневный запуск не означает автоматических ежедневных выводов
На собственном постоянно работающем сервере можно настроить ежедневный запуск через cron или существующий планировщик задач. Ниже приведён пример Linux cron, а не уже настроенная за вас задача:
0 9 * * * /opt/seo/.venv/bin/python /opt/seo/seo_monitor.py >> /opt/seo/run.log 2>&1
Время выполнения интерпретируется в соответствии с часовым поясом cron на сервере. Путь к Python и путь к скрипту нужно заменить на реальные места развёртывания; учётные данные должны быть настроены в защищённом окружении процесса планировщика. Наличие переменных окружения в интерактивном терминале не означает, что cron унаследует их автоматически. Перед запуском в эксплуатацию протестируйте от имени того же пользователя выполнения, ограничьте права на журналы, настройте ротацию и предотвратите перекрытие задач.
При просмотре результатов сначала смотрите на долю успеха, а затем на позиции. Только если оба раза было попадание и условия поиска одинаковы, можно сравнивать разницу в позициях. Вчера восьмое место, сегодня пятое — можно сказать, что в этих двух наблюдениях позиция выросла на три места; если сегодня попадания нет, можно лишь сказать, что в этом результате не обнаружено. Если количество возвращённых результатов внезапно изменилось с десяти до двух, сначала также нужно исключить влияние изменения набора возвращённых результатов.
Если требуется мониторинг нескольких страниц, сохраняйте исходные результаты каждой страницы, проверяйте фактическую семантику position в API, а затем проектируйте дедупликацию между страницами. Не составляйте глобальный рейтинг по принципу «номер страницы умножить на десять» без проверки. В этом примере намеренно проверяется только первый экран, чтобы не дать читателю таблицу рейтингов, которая выглядит полной, но фактически использует неверную методику.
Бюджет запросов можно оценить как «количество ключевых слов × количество комбинаций условий поиска × количество страниц × количество запусков в день». Это объём запросов, а не прямой эквивалент счёта; стоимость одного запроса, тарифы по количеству возвращённых результатов и правила тарификации сбоев всё равно необходимо сверять с актуальным описанием сервиса и записями об использовании.
¶ По-настоящему экономится время на поддержке поисковых страниц
Этот скрипт не обещает улучшить SEO и не делает выводов о том, что определённое изменение страницы привело к изменению позиций. Он предоставляет основу для наблюдений, которую можно отслеживать и в которой можно различать сбои и отсутствие попаданий. Для более долгосрочных выводов затем нужно анализировать вместе изменения контента, показатели сайта и непрерывные наблюдения.
Сначала выберите несколько наиболее важных для бизнеса запросов и запускайте их в течение недели; убедиться, что каждый статус записывается корректно, важнее, чем в первый день сделать красивую большую панель. SERP API берёт на себя получение результатов, а вы оставляете свои усилия для ключевых слов и самих страниц.
Область проверки: пример кода прошёл офлайн-проверку компиляции и проверки утверждений для соответствия домена, попадания, пустых результатов и аномальной структуры; реальные платные SERP-запросы не выполнялись, сервер или задача по расписанию не развёртывались. В тексте нет реальных данных о позициях или результатах.