

Ontem você alterou o título da landing page, e hoje a equipe de operações perguntou: “Aquela palavra-chave subiu?” Você abre a página de busca, procura por bastante tempo e começa novamente a suspeitar se a região, o idioma ou o horário da busca são diferentes. Consultar manualmente uma vez não é difícil; o difícil é consultar todos os dias com o mesmo critério, manter registros e ainda conseguir explicar por que não houve dados em determinado dia.
Também é possível capturar as páginas de busca por conta própria, mas você originalmente queria monitorar rankings e, no fim, está mantendo seletores de página, proxies e tentativas de repetição em caso de exceção. Para uma equipe pequena com apenas algumas dezenas de palavras-chave, um ponto de partida mais adequado talvez seja: entregar os resultados de busca a uma API de SERP e manter por conta própria apenas as regras de monitoramento e os registros históricos.

Ilustração gerada por IA, não representa dados reais de ranking.
¶ Primeiro, deixe claro qual ranking você está monitorando
Aqui, o que se faz é “em qual posição o domínio-alvo está nos resultados de busca orgânica retornados desta vez, no país e idioma especificados”. Não é o único ranking que todos os usuários verão, nem posições de anúncios, mapas ou a posição em pixels de toda a página.
A interface Google SERP da AceDataCloud usa POST https://api.acedata.cloud/serp/google. Os resultados de busca orgânica estão em organic, e os itens incluem link e position. A solicitação pode especificar condições como termo de busca, país, idioma e paginação. Os campos devem seguir a documentação atual da interface. Google SERP API
Este exemplo fixa type=search, country=us, language=en, page=1, number=10. Assim, o escopo é pequeno o suficiente e fácil de verificar. Não consulte hoje em inglês dos Estados Unidos e amanhã em inglês do Reino Unido, mas conecte os valores dos dois dias como uma única linha de tendência.
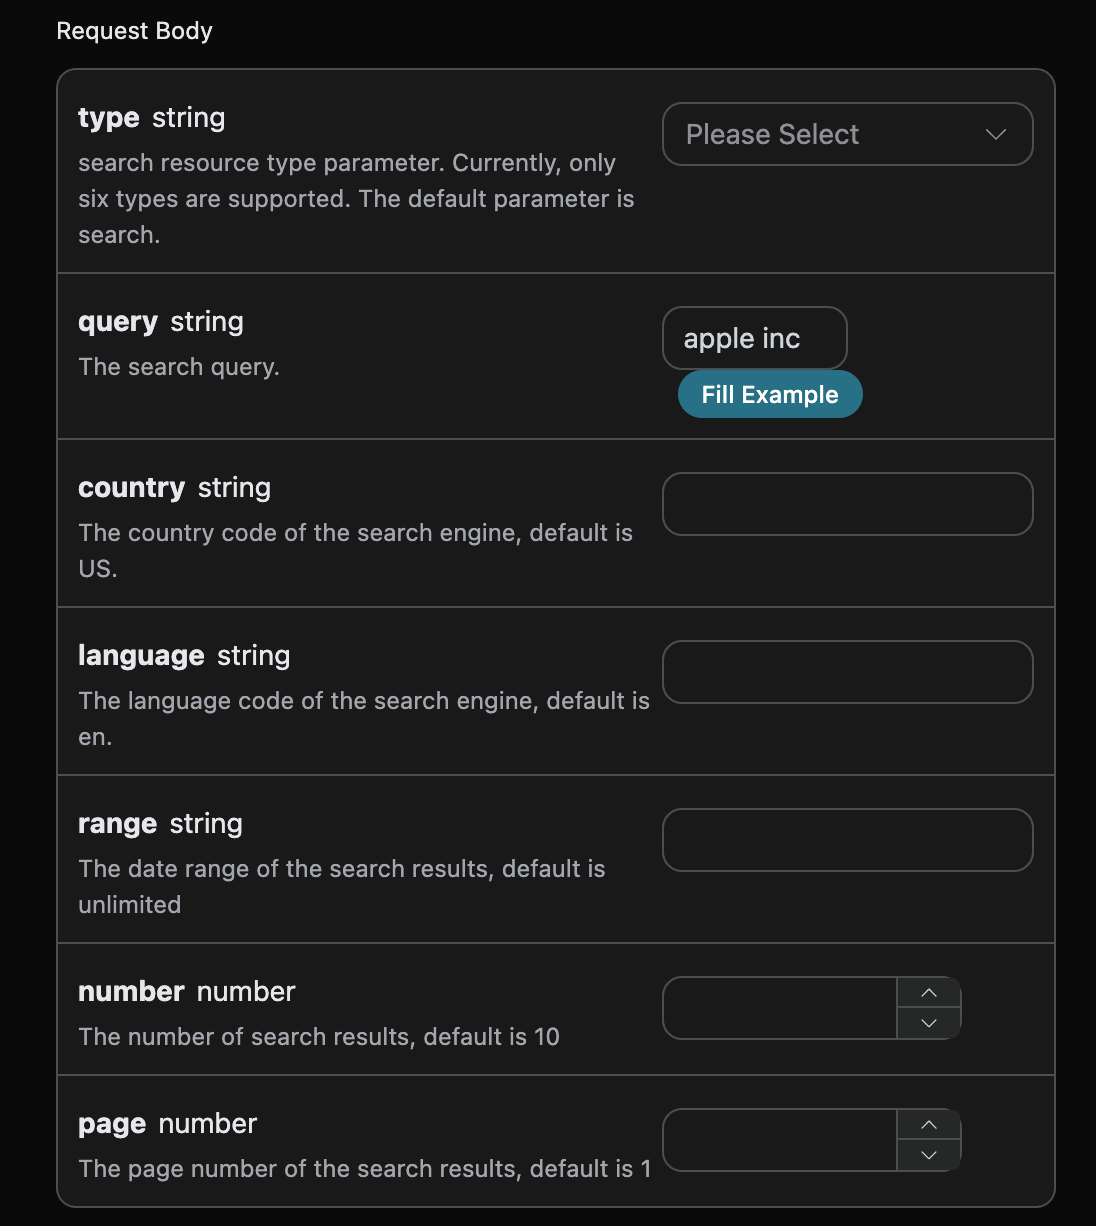
Captura de tela do formulário oficial de parâmetros; os campos atuais devem seguir a documentação.
Há ainda um ponto especialmente fácil de errar: se forem retornados dez resultados, mas seu domínio não for encontrado, isso não pode ser registrado como “falha da interface”, nem preenchido diretamente como décima primeira posição. Você só sabe que ele não apareceu no conjunto retornado desta vez, mas não sabe em qual posição ele está fora desse conjunto.
Recomenda-se salvar três estados: found indica que foi encontrado e a posição foi registrada; not_found_in_response indica que a interface retornou normalmente, mas não houve correspondência; error indica que houve um problema na solicitação, decodificação ou validação da estrutura. Quando a posição for desconhecida, escreva um valor vazio; não escreva 0 ou 999, nem use isso para calcular a posição média.
¶ Use um script para manter a solicitação e os resultados
O exemplo completo abaixo depende de Python 3 e requests, e usa o SQLite integrado ao Python para salvar os resultados. Salve o script como seo_monitor.py, crie keywords.json no mesmo diretório e substitua o domínio de exemplo pelo domínio a ser monitorado, em vez de um endereço de página com caminho:
[
  {"query":"reusable travel tumbler","target":"example.com","country":"us","language":"en"}
]
Obtenha a API Key no seu próprio aplicativo e forneça-a pela variável de ambiente ACEDATACLOUD_API_KEY; não a escreva no JSON, no script ou em capturas de tela. Após instalar as dependências, execute o script:
python -m pip install 'requests>=2.31,<3'
python seo_monitor.py
No primeiro uso, você deve primeiro realizar uma integração real com uma palavra-chave antes de ampliar o escopo.
import json
import os
import sqlite3
from datetime import datetime, timezone
from pathlib import Path
from urllib.parse import urlparse
import requests

ROOT = Path(__file__).resolve().parent

def host(value):
    parsed = urlparse(value if "://" in value else "https://" + value)
    return (parsed.hostname or "").lower().rstrip(".").encode("idna").decode("ascii")

def match(url, target):
    h = host(url)
    return h == target or h.endswith("." + target)

def rank(data, target):
    if not isinstance(data, dict) or data.get("error") or data.get("success") is False:
        raise ValueError("API failure")
    rows = data.get("organic")
    if not isinstance(rows, list):
        raise ValueError("organic missing or invalid")
    hits = []
    for row in rows:
        if not isinstance(row, dict):
            raise ValueError("invalid organic item")
        p, link = row.get("position"), row.get("link")
        if type(p) is not int or p < 1 or not isinstance(link, str):
            raise ValueError("invalid position/link")
        parsed = urlparse(link)
        if parsed.scheme not in ("http", "https") or not parsed.hostname:
            raise ValueError("invalid result URL")
        if match(link, target):
            hits.append((p, link))
    return min(hits) if hits else (None, None)

def main():
    token = os.environ["ACEDATACLOUD_API_KEY"]
    tasks = json.loads((ROOT / "keywords.json").read_text(encoding="utf-8"))
    db = sqlite3.connect(ROOT / "rankings.sqlite3")
    db.execute("""CREATE TABLE IF NOT EXISTS checks (
        checked_at TEXT, keyword TEXT, target TEXT, country TEXT,
        language TEXT, page INTEGER, requested_number INTEGER,
        returned_number INTEGER, status TEXT, position INTEGER,
        landing_url TEXT, error TEXT, raw_json TEXT)""")
    failures = 0
    with requests.Session() as session:
        session.headers.update({"Authorization": "Bearer " + token})
        for task in tasks:
            target = host(task["target"])
            if not target:
                raise ValueError("target must be a domain")
            payload = {"type": "search", "query": task["query"],
                       "country": task["country"], "language": task["language"],
                       "number": 10, "page": 1}
            stamp = datetime.now(timezone.utc).isoformat()
            status, p, link, error, raw, count = "error", None, None, None, None, None
            try:
                r = session.post("https://api.acedata.cloud/serp/google",
                                 json=payload, timeout=(10, 60))
                r.raise_for_status()
                data = r.json()
                raw = json.dumps(data, ensure_ascii=False)
                p, link = rank(data, target)
                count = len(data["organic"])
                status = "found" if p is not None else "not_found_in_response"
            except (requests.RequestException, ValueError) as exc:
                error = type(exc).__name__
                if isinstance(exc, requests.HTTPError) and exc.response is not None:
                    error += ": HTTP " + str(exc.response.status_code)
                failures += 1
            db.execute("INSERT INTO checks VALUES (?,?,?,?,?,?,?,?,?,?,?,?,?)",
                       (stamp, task["query"], target, task["country"], task["language"],
                        1, 10, count, status, p, link, error, raw))
            db.commit()
            print(task["query"], status, p if p is not None else "-")
    db.close()
    raise SystemExit(1 if failures else 0)

if __name__ == "__main__":
    main()
Dentro de rank, os tipos de dados, URLs e campos de posição são verificados. Uma resposta sem organic é tratada como exceção; já um array vazio é um resultado vazio normal. A correspondência de domínio usa o hostname da URL e não faz uma verificação de inclusão de string; caso contrário, notexample.com também poderia ser identificado por engano como example.com.
Este exemplo inclui subdomínios: shop.example.com pode corresponder a example.com. Se você se importa apenas com o site principal, altere para igualdade estrita; se acompanha um artigo específico, adicione regras de normalização de caminho. Não tome a melhor posição de todo o site como a posição de uma determinada página sem alinhar o critério.
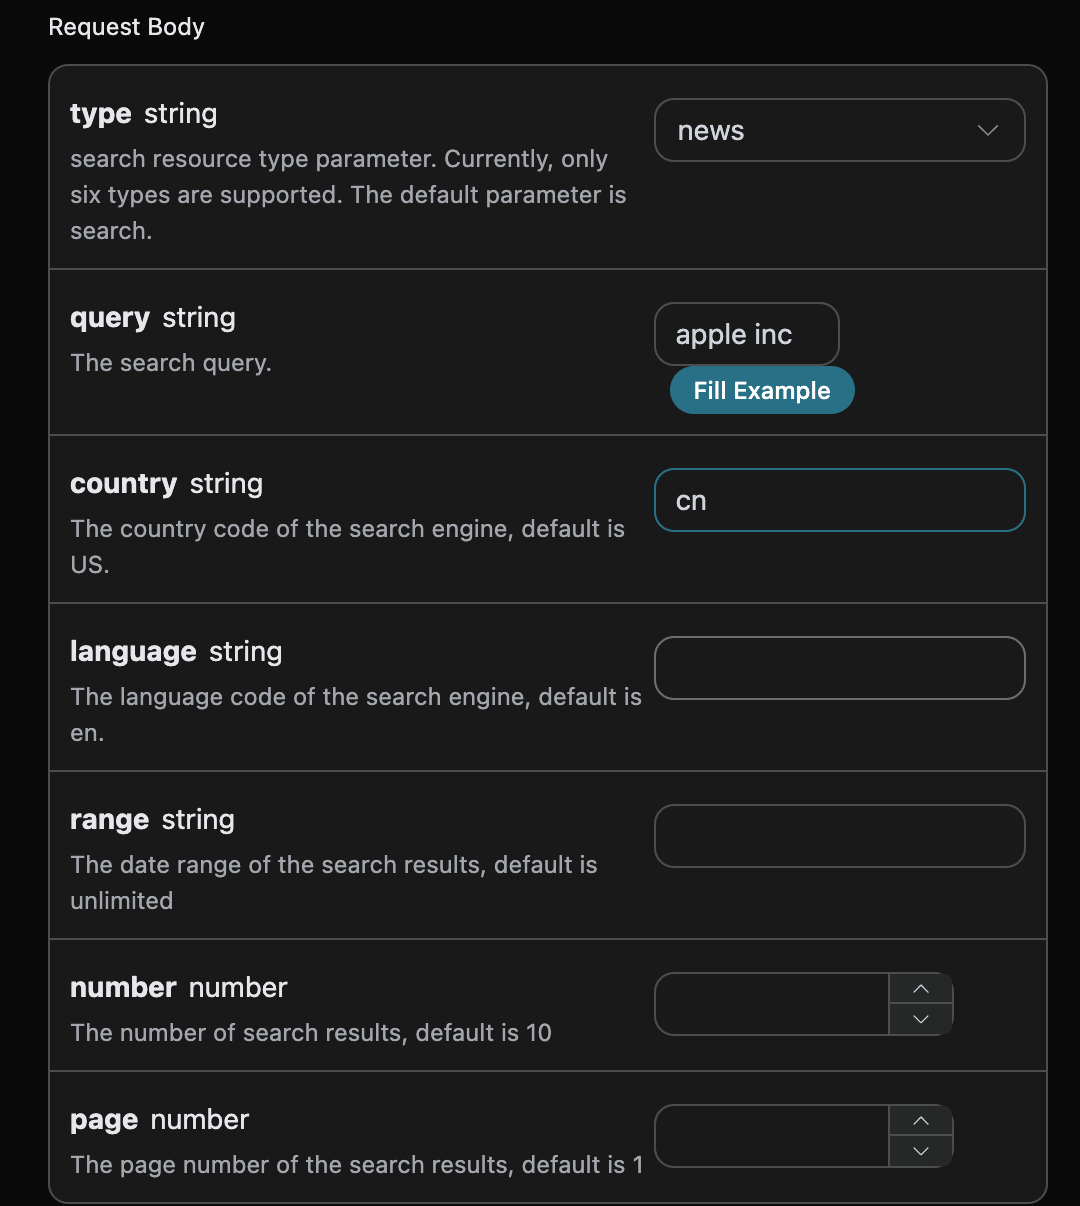
As condições de busca, como região e idioma, devem ser salvas junto com os registros de monitoramento.
Cada verificação registrará horário, palavra-chave, domínio, país, idioma, página, quantidade de solicitações, quantidade efetivamente retornada, status, posição, página de destino, categoria de erro e JSON bruto. Os registros usam horário UTC e são convertidos uniformemente para o fuso horário local apenas na exibição dos relatórios. Mantenha as respostas brutas em seu próprio armazenamento para facilitar a rastreabilidade; não publique diretamente todo o banco de dados.
O script não imprime os cabeçalhos das solicitações. Exceções HTTP registram apenas a categoria do erro e o código de status; se qualquer palavra-chave falhar, o processo retornará ao final um código de saída diferente de zero, facilitando alertas do agendador. Ele não possui tentativas automáticas de repetição, e isso é intencional: primeiro torne as falhas visíveis e, depois, adicione uma espera progressiva com limite de acordo com as regras de limitação do serviço, o que é mais controlável do que repetir solicitações infinitamente.
¶ Executar automaticamente todos os dias não significa chegar automaticamente a conclusões todos os dias
Em seu próprio servidor sempre ativo, você pode usar cron ou o agendador de tarefas existente para acionar uma vez por dia. Abaixo está um exemplo de cron no Linux; não é uma tarefa já configurada para você:
0 9 * * * /opt/seo/.venv/bin/python /opt/seo/seo_monitor.py >> /opt/seo/run.log 2>&1
O horário de execução é interpretado de acordo com o fuso horário do cron do servidor. O caminho do Python e o caminho do script devem ser substituídos pelos locais reais de implantação; as credenciais precisam ser configuradas no ambiente protegido do processo agendado. Ter variáveis de ambiente no terminal interativo não significa que o cron as herdará automaticamente. Antes de entrar em produção, teste com o mesmo usuário de execução, limite as permissões dos logs, configure a rotação e evite sobreposição de tarefas.
Ao consultar os resultados, veja primeiro a taxa de sucesso e depois o ranking. Compare a diferença de posição apenas quando ambas as vezes houverem encontrado resultados e as condições de busca forem iguais. Se ontem estava em oitavo e hoje em quinto, pode-se dizer que subiu três posições nessas duas observações; se hoje não foi encontrado, só se pode dizer que não foi detectado nos resultados desta vez. Se a quantidade retornada cair repentinamente de dez para duas, também é necessário primeiro excluir o impacto da mudança no conjunto retornado.
Quando for necessário monitorar várias páginas, salve os resultados brutos de cada página, verifique o significado real de position na API e, então, projete a deduplicação entre páginas. Não monte um ranking global usando “número da página multiplicado por dez” sem validação. Este exemplo consulta deliberadamente apenas a primeira tela, justamente para não dar ao leitor uma classificação que parece completa, mas cujo critério está incorreto na prática.
O orçamento de solicitações pode ser estimado como “número de palavras-chave × número de combinações de condições de busca × número de páginas × número de execuções diárias”. Trata-se de volume de solicitações, não equivale diretamente à cobrança; o custo por solicitação, as faixas de quantidade retornada e as regras de cobrança por falha ainda precisam ser verificados com as instruções do serviço naquele momento e os registros de uso.
¶ O que realmente se economiza é o tempo de manutenção das páginas de busca
Este script não promete melhorar o SEO nem infere que alguma alteração de página tenha causado uma mudança no ranking. O que ele fornece é uma base de observação rastreável, capaz de distinguir falhas de não encontrados. Para avaliações de prazo mais longo, analise conjuntamente alterações de conteúdo, métricas do site e observações contínuas.
Primeiro, escolha algumas palavras que mais importam para o negócio e execute por uma semana; verificar se cada status foi registrado corretamente é mais importante do que criar um belo painel no primeiro dia. A SERP API assume a obtenção dos resultados, e você mantém sua energia nas palavras-chave e nas próprias páginas.
Escopo de validação: o código de exemplo concluiu verificações de compilação offline e asserções de correspondência de domínio, resultado encontrado, resultado vazio e estrutura anormal; não foram executadas solicitações SERP pagas reais, nem implantados servidor ou tarefa agendada. O texto não contém dados reais de ranking ou resultados.