

昨日ランディングページのタイトルを変更し、今日になって運用担当が尋ねた:「あのキーワードは上がりましたか?」検索ページを開き、長い間探した後、地域、言語、または検索時間が違うのではないかと再び疑い始める。手作業で一度確認するのは難しくないが、難しいのは毎日同じ基準で確認し、記録を残し、ある日にデータがない理由も説明できるようにすることだ。
自分で検索ページを取得することもできるが、本来は順位を監視したかったのに、最終的にはページセレクター、プロキシ、例外リトライの保守に追われる。数十個のキーワードしかない小規模チームにとって、より適した出発点はおそらく:検索結果を SERP API に任せ、自分たちは監視ルールと履歴記録だけを保守することだ。

AI による生成イメージであり、実際の順位データを示すものではありません。
¶ まず明確にしよう、いったいどの順位を監視しているのか
ここで行うのは「指定した国、言語、および今回返されたオーガニック検索結果の中で、対象ドメインが何位にあるか」の監視だ。すべてのユーザーが見る唯一の順位でもなければ、広告枠、地図枠、またはページ全体におけるピクセル単位の位置でもない。
AceDataCloud の Google SERP インターフェースは POST https://api.acedata.cloud/serp/google を使用する。オーガニック検索結果は organic にあり、項目には link と position が含まれる。リクエストでは、クエリ語、国、言語、ページネーションなどの条件を指定できる。フィールドは現在のインターフェースドキュメントを基準とする。Google SERP API
本例では type=search、country=us、language=en、page=1、number=10 を固定する。これにより範囲が十分に小さくなり、確認しやすい。今日アメリカ英語で確認し、明日イギリス英語で確認して、その2日間の値を1本のトレンドラインとしてつなげてはいけない。
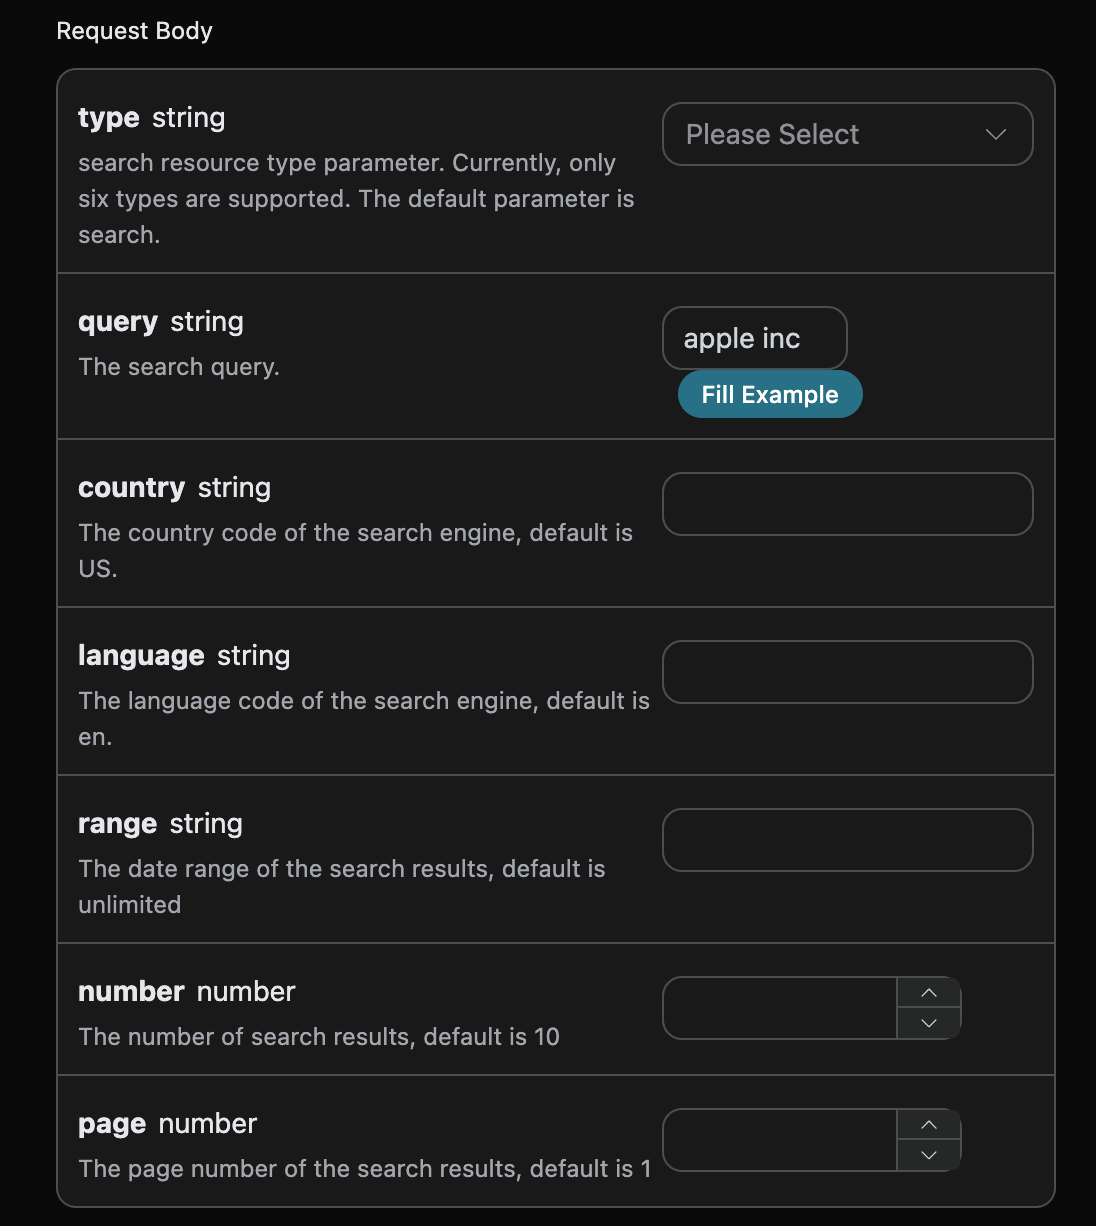
公式パラメータフォームのスクリーンショット;現在のフィールドはドキュメントを基準とします。
もう1つ特に間違えやすい点がある:10件の結果が返されても、自分のドメインが見つからなかった場合、それを「インターフェースの失敗」として記録してはならず、直接11位として補完してもならない。分かるのは、それが今回返された集合に現れなかったことだけであり、集合の外で何位なのかは分からない。
3種類の状態を保存することを推奨する:found は見つかり位置を記録したことを示す;not_found_in_response はインターフェースが正常に返されたがヒットしなかったことを示す;error はリクエスト、デコード、または構造検証で問題が発生したことを示す。位置が不明な場合は空値を書き、0 や 999 を書かず、それを平均順位の計算にも使わない。
¶ 1つのスクリプトで、リクエストと結果を残す
以下の完全な例は Python 3 と requests に依存し、Python 標準の SQLite を使用して結果を保存する。スクリプトを seo_monitor.py として保存し、同じディレクトリに keywords.json を作成し、プレースホルダーのドメインを監視対象のドメインに置き換える。パス付きのページアドレスではない:
[
  {"query":"reusable travel tumbler","target":"example.com","country":"us","language":"en"}
]
API Key は自分のアプリケーションから取得し、ACEDATACLOUD_API_KEY 環境変数を通じて提供する;JSON、スクリプト、またはスクリーンショットに書き込んではならない。依存関係をインストールした後、スクリプトを実行する:
python -m pip install 'requests>=2.31,<3'
python seo_monitor.py
初回使用時は、まず1つのキーワードで実際の連携テストを行ってから、範囲を広げるべきだ。
import json
import os
import sqlite3
from datetime import datetime, timezone
from pathlib import Path
from urllib.parse import urlparse
import requests

ROOT = Path(__file__).resolve().parent

def host(value):
    parsed = urlparse(value if "://" in value else "https://" + value)
    return (parsed.hostname or "").lower().rstrip(".").encode("idna").decode("ascii")

def match(url, target):
    h = host(url)
    return h == target or h.endswith("." + target)

def rank(data, target):
    if not isinstance(data, dict) or data.get("error") or data.get("success") is False:
        raise ValueError("API failure")
    rows = data.get("organic")
    if not isinstance(rows, list):
        raise ValueError("organic missing or invalid")
    hits = []
    for row in rows:
        if not isinstance(row, dict):
            raise ValueError("invalid organic item")
        p, link = row.get("position"), row.get("link")
        if type(p) is not int or p < 1 or not isinstance(link, str):
            raise ValueError("invalid position/link")
        parsed = urlparse(link)
        if parsed.scheme not in ("http", "https") or not parsed.hostname:
            raise ValueError("invalid result URL")
        if match(link, target):
            hits.append((p, link))
    return min(hits) if hits else (None, None)

def main():
    token = os.environ["ACEDATACLOUD_API_KEY"]
    tasks = json.loads((ROOT / "keywords.json").read_text(encoding="utf-8"))
    db = sqlite3.connect(ROOT / "rankings.sqlite3")
    db.execute("""CREATE TABLE IF NOT EXISTS checks (
        checked_at TEXT, keyword TEXT, target TEXT, country TEXT,
        language TEXT, page INTEGER, requested_number INTEGER,
        returned_number INTEGER, status TEXT, position INTEGER,
        landing_url TEXT, error TEXT, raw_json TEXT)""")
    failures = 0
    with requests.Session() as session:
        session.headers.update({"Authorization": "Bearer " + token})
        for task in tasks:
            target = host(task["target"])
            if not target:
                raise ValueError("target must be a domain")
            payload = {"type": "search", "query": task["query"],
                       "country": task["country"], "language": task["language"],
                       "number": 10, "page": 1}
            stamp = datetime.now(timezone.utc).isoformat()
            status, p, link, error, raw, count = "error", None, None, None, None, None
            try:
                r = session.post("https://api.acedata.cloud/serp/google",
                                 json=payload, timeout=(10, 60))
                r.raise_for_status()
                data = r.json()
                raw = json.dumps(data, ensure_ascii=False)
                p, link = rank(data, target)
                count = len(data["organic"])
                status = "found" if p is not None else "not_found_in_response"
            except (requests.RequestException, ValueError) as exc:
                error = type(exc).__name__
                if isinstance(exc, requests.HTTPError) and exc.response is not None:
                    error += ": HTTP " + str(exc.response.status_code)
                failures += 1
            db.execute("INSERT INTO checks VALUES (?,?,?,?,?,?,?,?,?,?,?,?,?)",
                       (stamp, task["query"], target, task["country"], task["language"],
                        1, 10, count, status, p, link, error, raw))
            db.commit()
            print(task["query"], status, p if p is not None else "-")
    db.close()
    raise SystemExit(1 if failures else 0)

if __name__ == "__main__":
    main()
rank の内部では、データ型、URL、および順位フィールドを検査する。organic がないレスポンスは例外として扱われる;空配列は正常な空の結果である。ドメイン照合には文字列の包含判定ではなく URL の hostname を使用する。そうしなければ、notexample.com も example.com と誤認される可能性がある。
本例にはサブドメインが含まれる:shop.example.com は example.com にヒットできる。メインサイトだけを気にする場合は、厳密な一致に変更する;特定の記事に注目する場合は、さらにパスの正規化ルールを追加する。基準をすり合わせないまま、サイト全体で最も良い順位を特定ページの順位として扱ってはいけない。
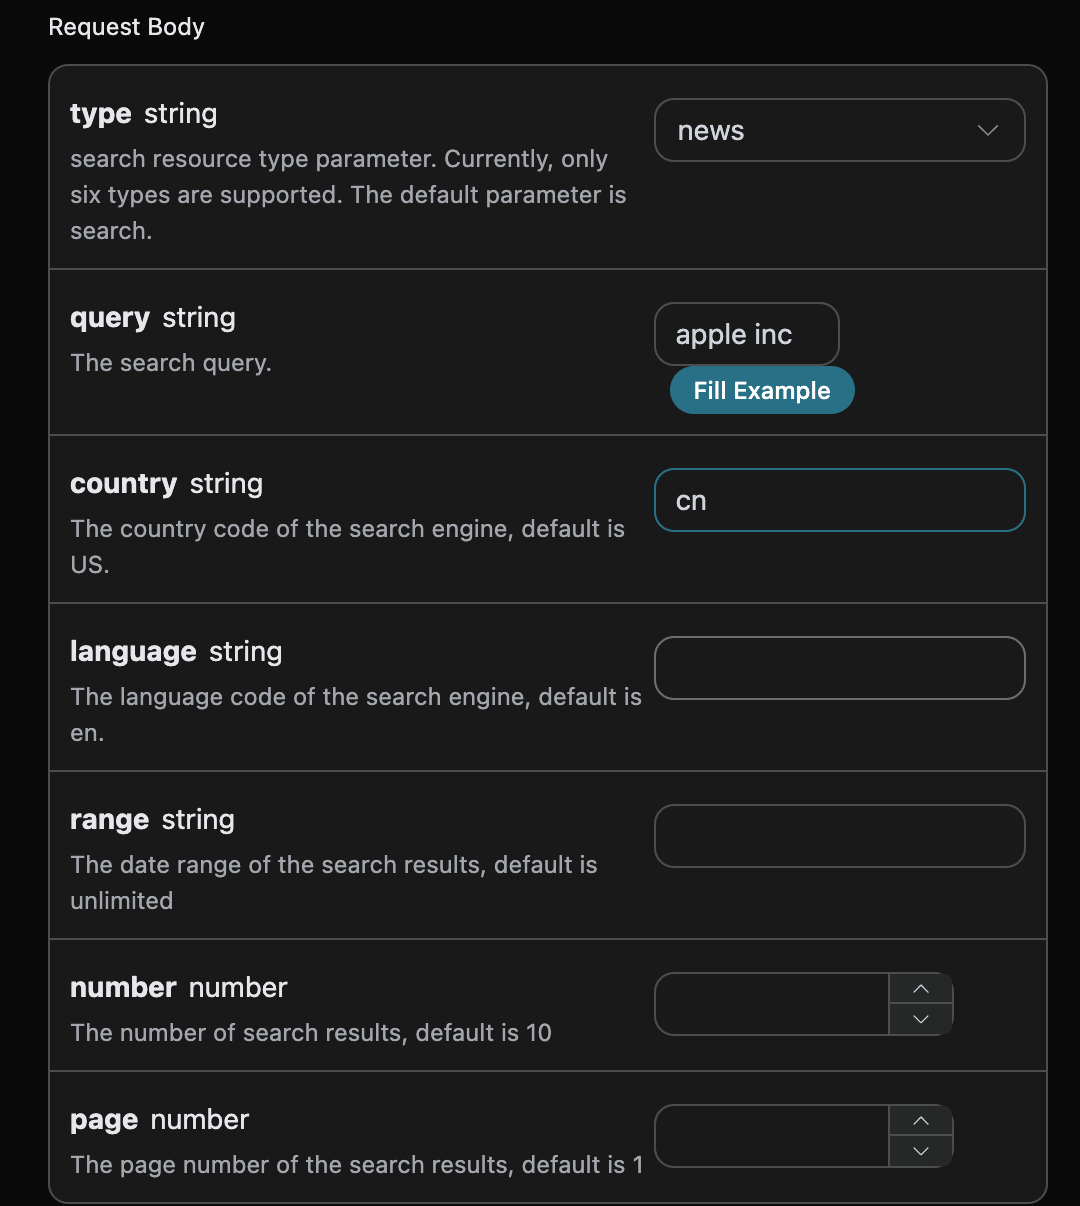
地域、言語などの検索条件は監視記録とともに保存すべきです。
各チェックでは、時刻、キーワード、ドメイン、国、言語、ページ番号、リクエスト数、実際の返却数、ステータス、順位、ランディングページ、エラー分類、および生 JSON を記録します。記録には UTC 時間を使用し、レポート表示時に統一してローカルタイムゾーンへ変換します。元のレスポンスは追跡しやすいよう自分のストレージに保管し、データベース全体を直接公開しないでください。
スクリプトはリクエストヘッダーを出力しません。HTTP 例外ではエラー分類とステータスコードのみを記録します。いずれかのキーワードが失敗した場合、プロセスは最終的に非ゼロの終了コードを返すため、スケジューラがアラートを出せます。自動リトライがないのは意図的です。まず失敗を把握し、その後サービスのレート制限ルールに従って上限付きのバックオフを追加するほうが、無限にリクエストを繰り返すより制御しやすいためです。
¶ 毎日自動実行することは、毎日自動で結論を出すことではない
自分の常時稼働サーバーでは、cron または既存のタスクスケジューラで毎日一度起動できます。以下は Linux cron の例であり、すでにあなたのために設定済みのタスクではありません。
0 9 * * * /opt/seo/.venv/bin/python /opt/seo/seo_monitor.py >> /opt/seo/run.log 2>&1
実行時刻はサーバーの cron タイムゾーンに従って解釈されます。Python のパスとスクリプトのパスは実際のデプロイ先に置き換える必要があります。認証情報は、スケジューリングプロセスの保護された環境で設定する必要があります。対話型ターミナルに環境変数があるからといって、cron が自動的に継承するわけではありません。本番投入前に同じ実行ユーザーでテストし、ログの権限を制限してローテーションを設定し、タスクの重複実行を防いでください。
結果を確認するときは、まず成功率を見てから順位を確認します。両方ともヒットし、検索条件が同じ場合にのみ、順位差を比較します。昨日は8位、今日は5位であれば、この2回の観測では3位上昇したと言えます。今日ヒットしなかった場合は、今回の結果では検出されなかったとしか言えません。返却数が突然10件から2件になった場合は、まず返却集合の変化による影響を除外する必要があります。
複数ページを監視する必要がある場合は、各ページの元の結果を保存し、API の position の実際の意味を確認してから、ページ横断の重複排除を設計してください。検証せずに「ページ番号に10を掛ける」ことでグローバル順位を組み立ててはいけません。この例が意図的に最初のページだけを検索するのは、一見完全に見えても、実際には基準が誤ったランキング表を読者に与えないためです。
リクエスト予算は「キーワード数 × 検索条件の組み合わせ数 × ページ数 × 1日あたりの実行回数」で見積もることができます。これはリクエスト量であり、請求額と直接同じではありません。1回あたりの料金、返却数の料金帯、失敗時の課金ルールは、引き続きサービスのその時点の説明と利用記録に照らして確認する必要があります。
¶ 本当に節約できるのは、検索ページを維持する時間です
このスクリプトは SEO の改善を約束するものではなく、あるページ変更が順位変動を引き起こしたと推論するものでもありません。提供するのは、追跡可能で、失敗と未ヒットを区別できる観測の基盤です。より長期的な判断が必要な場合は、コンテンツの変更、サイト指標、継続的な観測をまとめて分析してください。
まずは事業で最も重視するいくつかのキーワードを選んで1週間実行し、各ステータスが正しく記録されているかを確認することのほうが、初日に見栄えのよいダッシュボードを作ることより重要です。SERP API に結果取得を任せ、あなたの力はキーワードとページそのものに注いでください。
**検証範囲:**サンプルコードはオフラインのコンパイルチェック、およびドメイン一致、ヒット、空結果、異常構造のアサーションを完了しています。実際の有料 SERP リクエストは実行しておらず、サーバーや定期タスクもデプロイしていません。本文には実際の順位データや効果データはありません。