

昨天修改了落地页标题,今天运营问:“那个关键词涨了吗?”你打开搜索页,找了半天,又开始怀疑是不是地区、语言或者搜索时间不同。手工查一次不难,难的是每天用同一个口径查,留下记录,还能解释某天为什么没数据。
自己抓取搜索页面也能做,但你原本想监测排名,最后却在维护页面选择器、代理和异常重试。对只有几十个关键词的小团队,更合适的起点可能是:把搜索结果交给 SERP API,自己只维护监测规则和历史记录。

Illustrazione generata dall'IA, non rappresenta dati reali di ranking.
¶ Prima chiarisci quale ranking stai effettivamente monitorando
Qui si monitora “in quale posizione si trova il dominio target nei risultati di ricerca organici restituiti questa volta, per il paese e la lingua specificati”. Non è l'unico ranking che tutti gli utenti vedranno, né una posizione pubblicitaria, una posizione nella mappa o la posizione in pixel dell'intera pagina.
L'interfaccia Google SERP di AceDataCloud utilizza POST https://api.acedata.cloud/serp/google. I risultati di ricerca organici si trovano in organic, e le voci includono link e position. La richiesta può specificare condizioni quali query, paese, lingua e paginazione. I campi devono fare riferimento alla documentazione attuale dell'interfaccia. Google SERP API
In questo esempio vengono fissati type=search, country=us, language=en, page=1, number=10. In questo modo l'ambito è abbastanza ristretto ed è facile da verificare. Non controllare oggi l'inglese degli Stati Uniti e domani l'inglese del Regno Unito, collegando poi i valori dei due giorni in una stessa linea di tendenza.
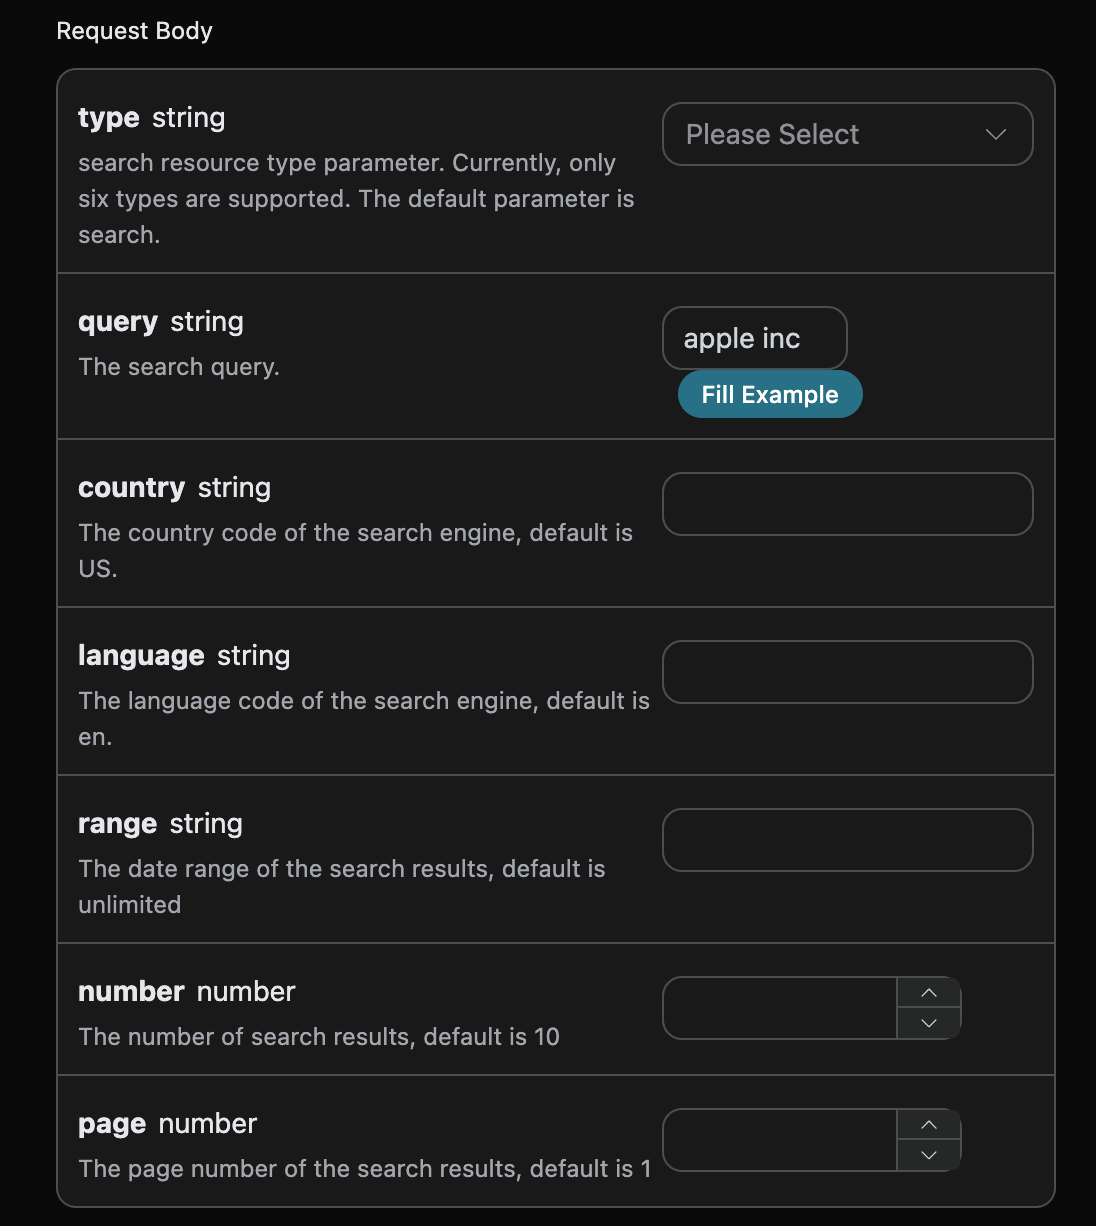
Screenshot del modulo ufficiale dei parametri; fare riferimento alla documentazione per i campi attuali.
C'è anche un punto particolarmente facile da sbagliare: se vengono restituiti dieci risultati ma il proprio dominio non viene trovato, non può essere registrato come “errore dell'interfaccia”, né può essere direttamente considerato come undicesimo. Sai solo che non è comparso nell'insieme restituito questa volta, non sai quale posizione occupi al di fuori di quell'insieme.
Si consiglia di salvare tre stati: found indica che è stato trovato e la posizione è stata registrata; not_found_in_response indica che l'interfaccia ha restituito normalmente una risposta ma non c'è stata corrispondenza; error indica che si è verificato un problema nella richiesta, nella decodifica o nella verifica della struttura. Quando la posizione è sconosciuta, scrivi un valore vuoto, non 0 o 999, e non usarla per calcolare il ranking medio.
¶ Usa uno script per conservare richieste e risultati
L'esempio completo seguente dipende da Python 3 e requests, e utilizza SQLite incluso in Python per salvare i risultati. Salva lo script come seo_monitor.py, crea keywords.json nella stessa directory e sostituisci il dominio segnaposto con il dominio da monitorare, anziché con l'indirizzo di una pagina che include il percorso:
[
  {"query":"reusable travel tumbler","target":"example.com","country":"us","language":"en"}
]
Recupera la API Key dalla tua applicazione e forniscila tramite la variabile d'ambiente ACEDATACLOUD_API_KEY; non inserirla in JSON, script o screenshot. Dopo aver installato la dipendenza, esegui lo script:
python -m pip install 'requests>=2.31,<3'
python seo_monitor.py
Al primo utilizzo, dovresti prima effettuare un test di integrazione reale con una parola chiave, quindi ampliare l'ambito.
import json
import os
import sqlite3
from datetime import datetime, timezone
from pathlib import Path
from urllib.parse import urlparse
import requests

ROOT = Path(__file__).resolve().parent

def host(value):
    parsed = urlparse(value if "://" in value else "https://" + value)
    return (parsed.hostname or "").lower().rstrip(".").encode("idna").decode("ascii")

def match(url, target):
    h = host(url)
    return h == target or h.endswith("." + target)

def rank(data, target):
    if not isinstance(data, dict) or data.get("error") or data.get("success") is False:
        raise ValueError("API failure")
    rows = data.get("organic")
    if not isinstance(rows, list):
        raise ValueError("organic missing or invalid")
    hits = []
    for row in rows:
        if not isinstance(row, dict):
            raise ValueError("invalid organic item")
        p, link = row.get("position"), row.get("link")
        if type(p) is not int or p < 1 or not isinstance(link, str):
            raise ValueError("invalid position/link")
        parsed = urlparse(link)
        if parsed.scheme not in ("http", "https") or not parsed.hostname:
            raise ValueError("invalid result URL")
        if match(link, target):
            hits.append((p, link))
    return min(hits) if hits else (None, None)

def main():
    token = os.environ["ACEDATACLOUD_API_KEY"]
    tasks = json.loads((ROOT / "keywords.json").read_text(encoding="utf-8"))
    db = sqlite3.connect(ROOT / "rankings.sqlite3")
    db.execute("""CREATE TABLE IF NOT EXISTS checks (
        checked_at TEXT, keyword TEXT, target TEXT, country TEXT,
        language TEXT, page INTEGER, requested_number INTEGER,
        returned_number INTEGER, status TEXT, position INTEGER,
        landing_url TEXT, error TEXT, raw_json TEXT)""")
    failures = 0
    with requests.Session() as session:
        session.headers.update({"Authorization": "Bearer " + token})
        for task in tasks:
            target = host(task["target"])
            if not target:
                raise ValueError("target must be a domain")
            payload = {"type": "search", "query": task["query"],
                       "country": task["country"], "language": task["language"],
                       "number": 10, "page": 1}
            stamp = datetime.now(timezone.utc).isoformat()
            status, p, link, error, raw, count = "error", None, None, None, None, None
            try:
                r = session.post("https://api.acedata.cloud/serp/google",
                                 json=payload, timeout=(10, 60))
                r.raise_for_status()
                data = r.json()
                raw = json.dumps(data, ensure_ascii=False)
                p, link = rank(data, target)
                count = len(data["organic"])
                status = "found" if p is not None else "not_found_in_response"
            except (requests.RequestException, ValueError) as exc:
                error = type(exc).__name__
                if isinstance(exc, requests.HTTPError) and exc.response is not None:
                    error += ": HTTP " + str(exc.response.status_code)
                failures += 1
            db.execute("INSERT INTO checks VALUES (?,?,?,?,?,?,?,?,?,?,?,?,?)",
                       (stamp, task["query"], target, task["country"], task["language"],
                        1, 10, count, status, p, link, error, raw))
            db.commit()
            print(task["query"], status, p if p is not None else "-")
    db.close()
    raise SystemExit(1 if failures else 0)

if __name__ == "__main__":
    main()
All'interno di rank vengono controllati i tipi di dati, gli URL e i campi di posizione. Una risposta priva di organic viene trattata come un'eccezione; un array vuoto, invece, è un normale risultato vuoto. La corrispondenza del dominio utilizza l'hostname dell'URL, senza effettuare un controllo di inclusione di stringhe, altrimenti anche notexample.com potrebbe essere erroneamente riconosciuto come example.com.
Questo esempio include i sottodomini: shop.example.com può corrispondere a example.com. Se ti interessa solo il sito principale, modifica in modo che sia strettamente uguale; se monitori un singolo articolo, aggiungi ulteriormente regole di normalizzazione del percorso. Non considerare la migliore posizione dell'intero sito come la posizione di una determinata pagina senza aver prima concordato il criterio.
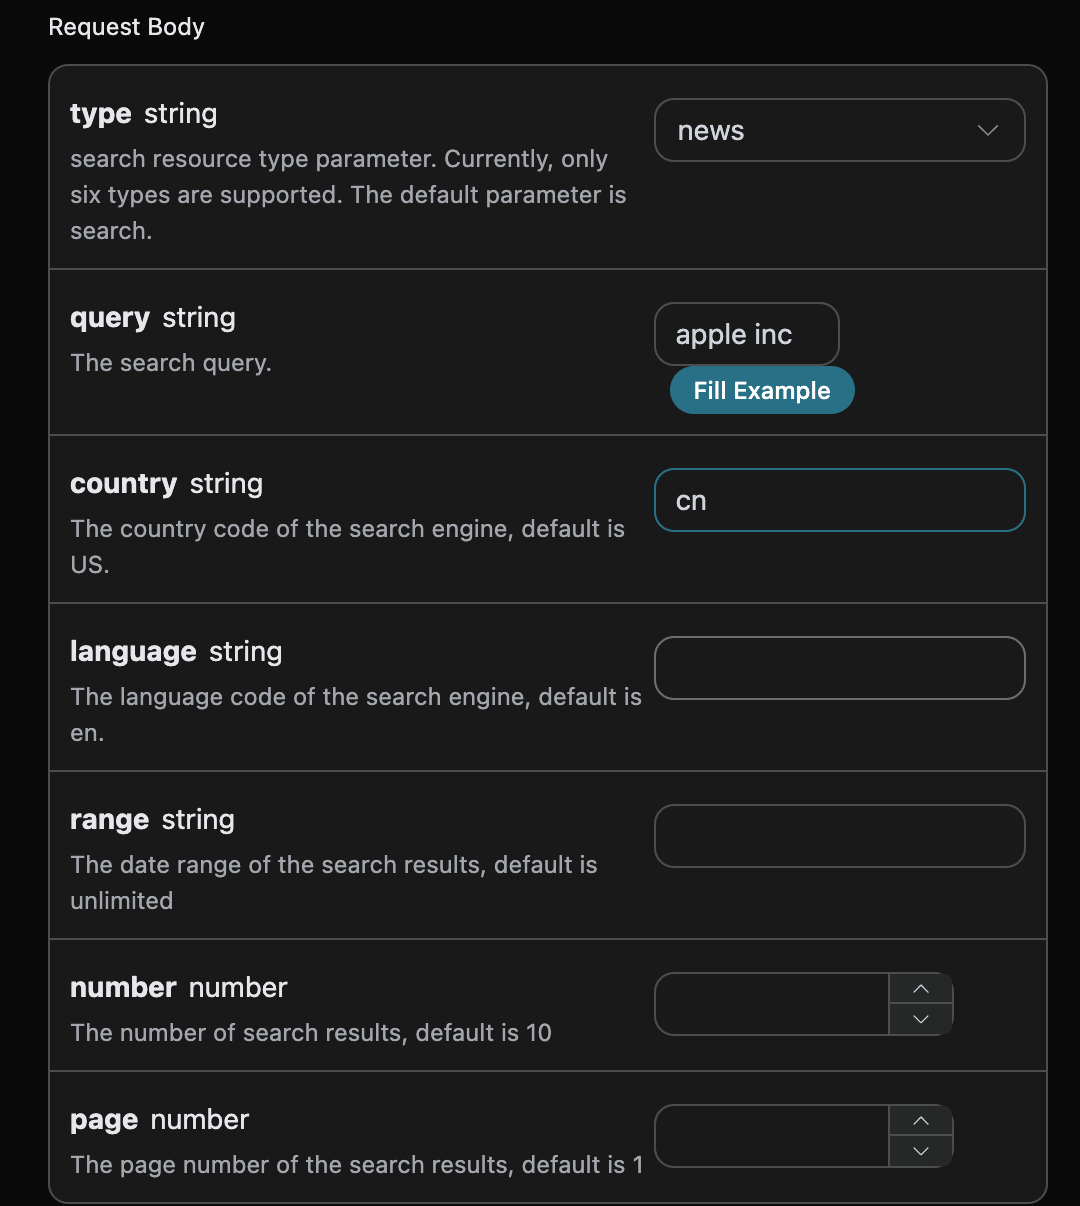
Le condizioni di ricerca come regione e lingua devono essere salvate insieme ai record di monitoraggio.
Ogni controllo scrive ora, parola chiave, dominio, paese, lingua, numero di pagina, quantità di richieste, quantità effettivamente restituita, stato, posizione, pagina di destinazione, categoria di errore e JSON originale. I record usano l'ora UTC e vengono poi convertiti uniformemente nel fuso orario locale durante la visualizzazione dei report. La risposta originale rimane nel proprio archivio, per facilitare la tracciabilità; non rendere pubblico direttamente l'intero database.
Lo script non stampa le intestazioni delle richieste. Le eccezioni HTTP registrano solo la categoria di errore e il codice di stato; se una qualsiasi parola chiave fallisce, il processo restituisce infine un codice di uscita diverso da zero, per facilitare gli avvisi del pianificatore. Non esegue tentativi automatici, ed è intenzionale: prima rendere visibili i fallimenti, poi aggiungere un backoff limitato in base alle regole di limitazione del servizio, è più controllabile che ripetere le richieste all'infinito.
¶ L'esecuzione automatica ogni giorno non equivale a trarre conclusioni automaticamente ogni giorno
Sul proprio server sempre acceso, è possibile attivarlo una volta al giorno con cron o con il pianificatore di attività esistente. Di seguito è riportato un esempio di cron Linux, non un'attività già configurata per te:
0 9 * * * /opt/seo/.venv/bin/python /opt/seo/seo_monitor.py >> /opt/seo/run.log 2>&1
L'orario di esecuzione viene interpretato secondo il fuso orario cron del server. Il percorso Python e il percorso dello script devono essere sostituiti con le posizioni di distribuzione effettive; le credenziali devono essere configurate nell'ambiente protetto del processo pianificato. Avere variabili d'ambiente nel terminale interattivo non significa che cron le erediti automaticamente. Prima della messa in produzione, eseguire il test con lo stesso utente di esecuzione e limitare i permessi dei log, configurare la rotazione e prevenire la sovrapposizione delle attività.
Quando si visualizzano i risultati, guardare prima il tasso di successo, poi il ranking. Solo se entrambe le volte viene trovato un risultato e le condizioni di ricerca sono identiche, si può confrontare la differenza di posizione. Ottavo ieri, quinto oggi: si può dire che in queste due osservazioni è salito di tre posizioni; se oggi non viene trovato, si può solo dire che non è stato rilevato nei risultati di questa volta. Se la quantità restituita passa improvvisamente da dieci risultati a due, occorre prima escludere l'impatto delle variazioni nell'insieme dei risultati.
Quando è necessario monitorare più pagine, salvare i risultati originali di ogni pagina, verificare il significato effettivo di position nell'interfaccia, quindi progettare la deduplicazione tra pagine. Non comporre un ranking globale con “numero di pagina per dieci” senza verifica. Questo esempio interroga intenzionalmente solo la prima schermata, proprio per non fornire al lettore una classifica apparentemente completa ma con criteri effettivamente errati.
Il budget delle richieste può essere stimato come “numero di parole chiave × numero di combinazioni di condizioni di ricerca × numero di pagine × numero di volte giornaliere”. È il volume di richieste e non equivale direttamente alla fattura; il costo della singola richiesta, le fasce di quantità restituita e le regole di fatturazione dei fallimenti devono comunque essere verificati in base alle istruzioni e ai record di utilizzo del servizio in quel momento.
¶ Ciò che si risparmia davvero è il tempo di manutenzione delle pagine di ricerca
Questo script non promette di migliorare la SEO, né deduce che una certa modifica alla pagina abbia causato un cambiamento nel ranking. Ciò che fornisce è una base di osservazione tracciabile, in grado di distinguere tra fallimenti e risultati non trovati. Per valutazioni più a lungo termine, occorre poi analizzare insieme le modifiche ai contenuti, le metriche del sito e le osservazioni continue.
Scegliere prima alcune parole più importanti per l'azienda e farle girare per una settimana, verificando che ogni stato sia registrato correttamente, è più importante che realizzare un bel grande schermo il primo giorno. La SERP API si occupa dell'acquisizione dei risultati, e tu puoi dedicare le tue energie alle parole chiave e alle pagine stesse.
Ambito di verifica: il codice di esempio completa i controlli di compilazione offline e le asserzioni su corrispondenza del dominio, risultato trovato, risultato vuoto e struttura anomala; non sono state eseguite richieste SERP a pagamento reali, né sono stati distribuiti server o attività pianificate. Nel testo non sono presenti dati reali di ranking o di risultati.