

Hier, vous avez modifié le titre de la page de destination, et aujourd’hui l’équipe opérationnelle demande : « Ce mot-clé a-t-il progressé ? » Vous ouvrez la page de recherche, cherchez longtemps, puis commencez à vous demander si la région, la langue ou l’heure de recherche sont différentes. Vérifier manuellement une fois n’est pas difficile ; ce qui est difficile, c’est de vérifier chaque jour avec le même référentiel, de conserver des traces, et de pouvoir expliquer pourquoi il n’y avait pas de données un certain jour.
Vous pouvez aussi récupérer vous-même les pages de recherche, mais vous vouliez initialement surveiller les classements, et vous finissez par maintenir des sélecteurs de pages, des proxys et des tentatives de réexécution après exception. Pour une petite équipe qui n’a que quelques dizaines de mots-clés, un point de départ plus adapté pourrait être : confier les résultats de recherche à une API SERP, et ne maintenir vous-même que les règles de surveillance et les historiques.

Illustration générée par IA, ne représente pas de véritables données de classement.
¶ Clarifiez d’abord quel classement vous surveillez exactement
Ici, il s’agit de « la position du domaine cible dans les résultats de recherche organiques renvoyés cette fois, pour le pays et la langue spécifiés ». Ce n’est pas le classement unique que voient tous les utilisateurs, ni les emplacements publicitaires, les emplacements cartographiques ou la position en pixels sur l’ensemble de la page.
L’interface Google SERP d’AceDataCloud utilise POST https://api.acedata.cloud/serp/google. Les résultats de recherche organiques se trouvent dans organic, et les entrées contiennent link et position. La requête peut spécifier des conditions telles que le terme de recherche, le pays, la langue et la pagination. Les champs doivent être conformes à la documentation actuelle de l’interface. Google SERP API
Cet exemple fixe type=search, country=us, language=en, page=1, number=10. Ainsi, le périmètre est suffisamment restreint et facile à vérifier. Ne recherchez pas aujourd’hui en anglais américain, demain en anglais britannique, puis ne reliez pas les valeurs des deux jours dans une même courbe de tendance.
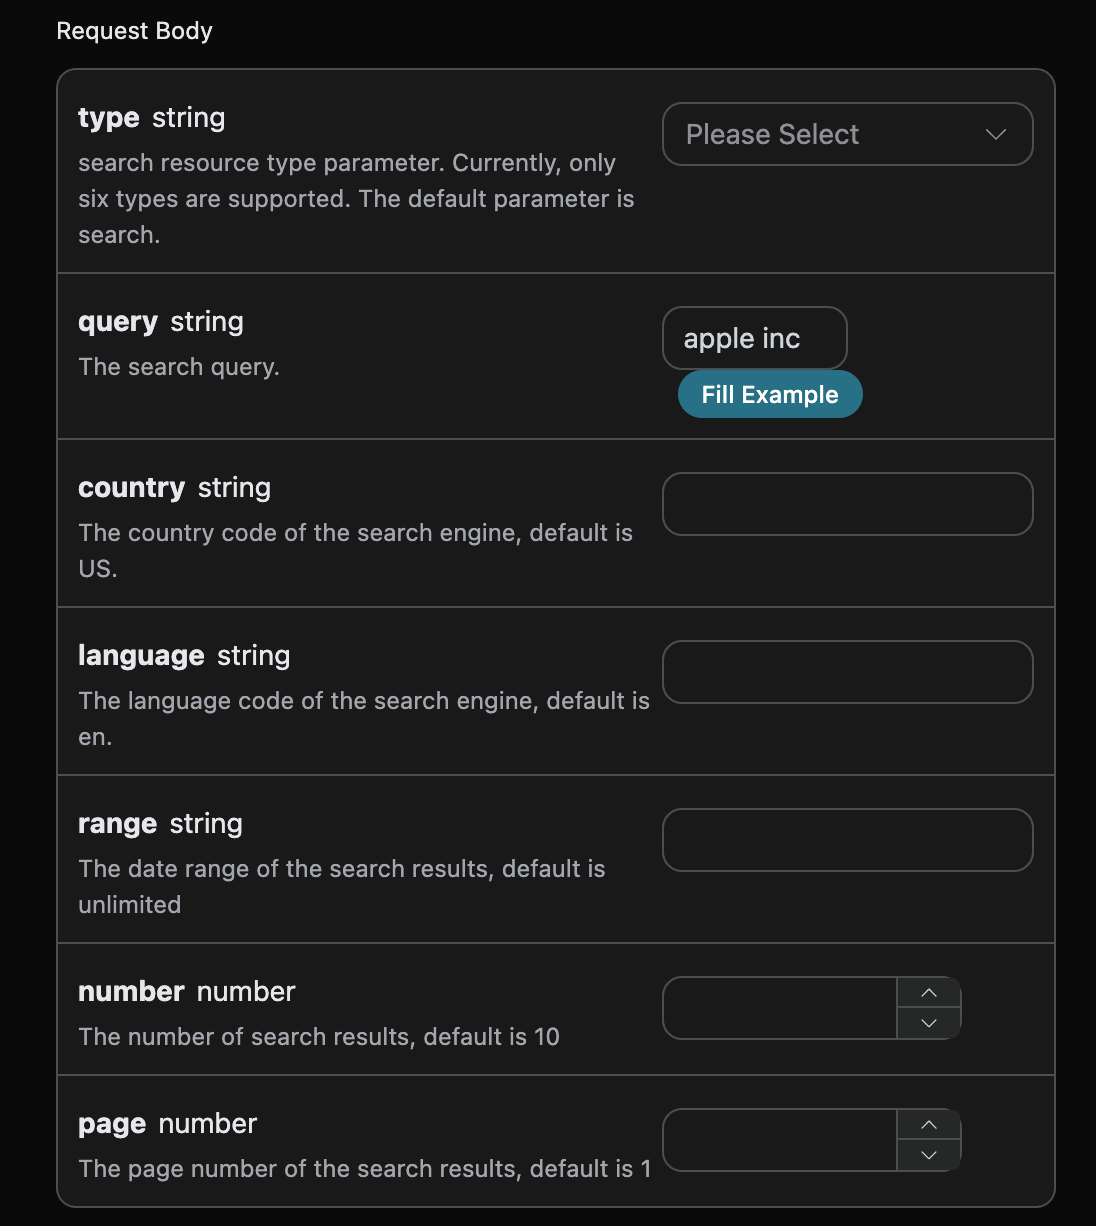
Capture d’écran du formulaire officiel des paramètres ; les champs actuels doivent être conformes à la documentation.
Il y a également un point particulièrement facile à mal faire : si dix résultats sont renvoyés, mais que votre domaine n’est pas trouvé, cela ne doit pas être enregistré comme un « échec de l’interface », et ne doit pas non plus être directement complété comme une onzième place. Vous savez seulement qu’il n’est pas apparu dans l’ensemble renvoyé cette fois-ci, mais vous ne savez pas où il se classe en dehors de cet ensemble.
Il est recommandé d’enregistrer trois statuts : found indique qu’il a été trouvé et que la position a été enregistrée ; not_found_in_response indique que l’interface a renvoyé une réponse normale mais qu’aucune correspondance n’a été trouvée ; error indique qu’un problème est survenu lors de la requête, du décodage ou de la validation de structure. Lorsque la position est inconnue, écrivez une valeur vide, et n’écrivez pas 0 ou 999, ni ne l’utilisez pour calculer la position moyenne.
¶ Utilisez un script pour conserver la requête et les résultats
L’exemple complet ci-dessous dépend de Python 3 et de requests, et utilise SQLite intégré à Python pour enregistrer les résultats. Enregistrez le script sous seo_monitor.py, créez keywords.json dans le même répertoire, et remplacez le domaine fictif par le domaine à surveiller, plutôt que par une adresse de page incluant un chemin :
[
  {"query":"reusable travel tumbler","target":"example.com","country":"us","language":"en"}
]
Récupérez la clé API depuis votre propre application et fournissez-la via la variable d’environnement ACEDATACLOUD_API_KEY ; ne l’écrivez pas dans le JSON, le script ou les captures d’écran. Exécutez le script après avoir installé les dépendances :
python -m pip install 'requests>=2.31,<3'
python seo_monitor.py
Lors de la première utilisation, vous devez d’abord effectuer une intégration réelle avec un mot-clé, puis élargir le périmètre.
import json
import os
import sqlite3
from datetime import datetime, timezone
from pathlib import Path
from urllib.parse import urlparse
import requests

ROOT = Path(__file__).resolve().parent

def host(value):
    parsed = urlparse(value if "://" in value else "https://" + value)
    return (parsed.hostname or "").lower().rstrip(".").encode("idna").decode("ascii")

def match(url, target):
    h = host(url)
    return h == target or h.endswith("." + target)

def rank(data, target):
    if not isinstance(data, dict) or data.get("error") or data.get("success") is False:
        raise ValueError("API failure")
    rows = data.get("organic")
    if not isinstance(rows, list):
        raise ValueError("organic missing or invalid")
    hits = []
    for row in rows:
        if not isinstance(row, dict):
            raise ValueError("invalid organic item")
        p, link = row.get("position"), row.get("link")
        if type(p) is not int or p < 1 or not isinstance(link, str):
            raise ValueError("invalid position/link")
        parsed = urlparse(link)
        if parsed.scheme not in ("http", "https") or not parsed.hostname:
            raise ValueError("invalid result URL")
        if match(link, target):
            hits.append((p, link))
    return min(hits) if hits else (None, None)

def main():
    token = os.environ["ACEDATACLOUD_API_KEY"]
    tasks = json.loads((ROOT / "keywords.json").read_text(encoding="utf-8"))
    db = sqlite3.connect(ROOT / "rankings.sqlite3")
    db.execute("""CREATE TABLE IF NOT EXISTS checks (
        checked_at TEXT, keyword TEXT, target TEXT, country TEXT,
        language TEXT, page INTEGER, requested_number INTEGER,
        returned_number INTEGER, status TEXT, position INTEGER,
        landing_url TEXT, error TEXT, raw_json TEXT)""")
    failures = 0
    with requests.Session() as session:
        session.headers.update({"Authorization": "Bearer " + token})
        for task in tasks:
            target = host(task["target"])
            if not target:
                raise ValueError("target must be a domain")
            payload = {"type": "search", "query": task["query"],
                       "country": task["country"], "language": task["language"],
                       "number": 10, "page": 1}
            stamp = datetime.now(timezone.utc).isoformat()
            status, p, link, error, raw, count = "error", None, None, None, None, None
            try:
                r = session.post("https://api.acedata.cloud/serp/google",
                                 json=payload, timeout=(10, 60))
                r.raise_for_status()
                data = r.json()
                raw = json.dumps(data, ensure_ascii=False)
                p, link = rank(data, target)
                count = len(data["organic"])
                status = "found" if p is not None else "not_found_in_response"
            except (requests.RequestException, ValueError) as exc:
                error = type(exc).__name__
                if isinstance(exc, requests.HTTPError) and exc.response is not None:
                    error += ": HTTP " + str(exc.response.status_code)
                failures += 1
            db.execute("INSERT INTO checks VALUES (?,?,?,?,?,?,?,?,?,?,?,?,?)",
                       (stamp, task["query"], target, task["country"], task["language"],
                        1, 10, count, status, p, link, error, raw))
            db.commit()
            print(task["query"], status, p if p is not None else "-")
    db.close()
    raise SystemExit(1 if failures else 0)

if __name__ == "__main__":
    main()
À l’intérieur de rank, les types de données, les URL et les champs de position sont vérifiés. Une réponse sans organic est traitée comme une exception ; un tableau vide est en revanche un résultat vide normal. La correspondance de domaine utilise le hostname de l’URL, sans effectuer de vérification par inclusion de chaîne, sinon notexample.com pourrait également être reconnu à tort comme example.com.
Cet exemple inclut les sous-domaines : shop.example.com peut correspondre à example.com. Si vous ne vous intéressez qu’au site principal, modifiez-le en égalité stricte ; si vous surveillez un article précis, ajoutez des règles de normalisation du chemin. Ne prenez pas la meilleure position de l’ensemble du site pour la position d’une certaine page sans avoir convenu du référentiel.
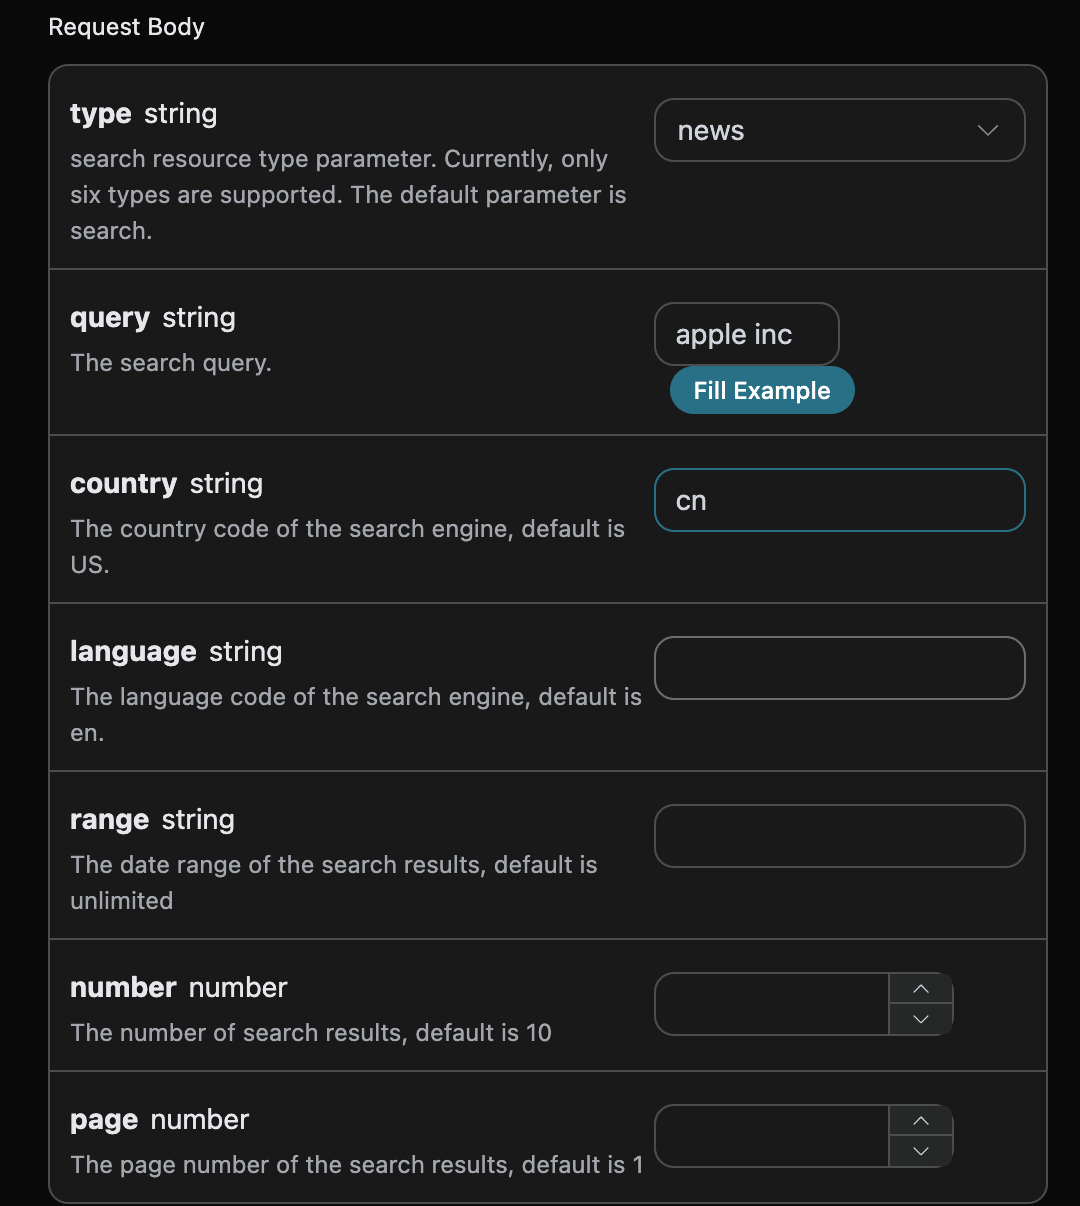
Les conditions de recherche telles que la région et la langue doivent être sauvegardées avec les enregistrements de surveillance.
Chaque vérification enregistre l’heure, le mot-clé, le domaine, le pays, la langue, le numéro de page, le nombre de requêtes, le nombre réellement retourné, le statut, la position, la page de destination, la catégorie d’erreur et le JSON brut. Les enregistrements utilisent l’heure UTC, puis sont uniformément convertis dans le fuseau horaire local lors de l’affichage des rapports. Conservez les réponses brutes dans votre propre stockage pour faciliter la traçabilité, ne publiez pas directement l’intégralité de la base de données.
Le script n’affiche pas les en-têtes de requête. Les exceptions HTTP n’enregistrent que la catégorie d’erreur et le code de statut ; si un mot-clé échoue, le processus renvoie finalement un code de sortie non nul, afin de faciliter les alertes du planificateur. Il n’effectue pas de nouvelles tentatives automatiques, c’est intentionnel : il vaut mieux d’abord voir les échecs, puis ajouter un recul plafonné selon les règles de limitation du service, ce qui est plus contrôlable que de répéter les requêtes à l’infini.
¶ Une exécution automatique quotidienne ne signifie pas une conclusion automatique quotidienne
Sur votre propre serveur toujours actif, vous pouvez utiliser cron ou votre planificateur de tâches existant pour déclencher une exécution quotidienne. Voici un exemple Linux cron, ce n’est pas une tâche déjà configurée pour vous :
0 9 * * * /opt/seo/.venv/bin/python /opt/seo/seo_monitor.py >> /opt/seo/run.log 2>&1
L’heure d’exécution est interprétée selon le fuseau horaire cron du serveur. Le chemin Python et le chemin du script doivent être remplacés par les emplacements réels de déploiement ; les identifiants doivent être configurés dans l’environnement protégé du processus planifié. Le fait que des variables d’environnement existent dans un terminal interactif ne signifie pas que cron les hérite automatiquement. Avant la mise en ligne, testez avec le même utilisateur d’exécution, et limitez les permissions des journaux, configurez leur rotation et empêchez le chevauchement des tâches.
Lors de la consultation des résultats, regardez d’abord le taux de réussite, puis le classement. Ne comparez les écarts de position que si les deux exécutions ont produit un résultat et que les conditions de recherche sont identiques. Huitième hier, cinquième aujourd’hui : vous pouvez dire que l’observation a progressé de trois places entre ces deux exécutions ; si aucun résultat n’est trouvé aujourd’hui, vous pouvez seulement dire que le résultat n’a pas été détecté cette fois-ci. Si le nombre retourné passe soudainement de dix à deux, il faut aussi d’abord exclure l’influence d’un changement dans l’ensemble retourné.
Lorsqu’une surveillance sur plusieurs pages est nécessaire, enregistrez les résultats bruts de chaque page, vérifiez la signification réelle de position dans l’interface, puis concevez la déduplication inter-pages. N’utilisez pas sans validation « numéro de page multiplié par dix » pour reconstituer un classement global. Cet exemple ne consulte intentionnellement que le premier écran, précisément pour ne pas donner au lecteur un classement qui semble complet mais dont le périmètre est en réalité erroné.
Le budget de requêtes peut être estimé selon « nombre de mots-clés × nombre de combinaisons de conditions de recherche × nombre de pages × nombre d’exécutions quotidiennes ». Il s’agit du volume de requêtes, pas directement de la facture ; le coût unitaire, les paliers de quantité retournée et les règles de facturation des échecs doivent toujours être vérifiés selon les informations du service à ce moment-là et les enregistrements d’utilisation.
¶ Ce qui est réellement économisé, c’est le temps de maintenance des pages de recherche
Ce script ne promet pas d’améliorer le SEO et ne déduit pas qu’une modification de page donnée a entraîné un changement de classement. Il fournit une base d’observation traçable, capable de distinguer les échecs des résultats non trouvés. Pour des conclusions à plus long terme, analysez ensemble les modifications de contenu, les indicateurs du site et les observations continues.
Commencez par exécuter pendant une semaine quelques mots les plus importants pour l’activité, et vérifiez que chaque statut est correctement enregistré : c’est plus important que de créer un beau grand écran dès le premier jour. L’API SERP prend en charge l’obtention des résultats, vous gardez votre énergie pour les mots-clés et les pages elles-mêmes.
**Périmètre de vérification :**le code d’exemple a effectué des contrôles de compilation hors ligne ainsi que des assertions sur la correspondance de domaine, les résultats trouvés, les résultats vides et les structures anormales ; aucune requête SERP payante réelle n’a été exécutée, et aucun serveur ni tâche planifiée n’a été déployé. L’article ne contient aucune donnée réelle de classement ou d’efficacité.