

Ayer se cambió el título de la página de destino, y hoy operaciones preguntó: “¿Subió esa palabra clave?” Abres la página de búsqueda, buscas durante mucho tiempo y empiezas de nuevo a dudar de si la región, el idioma o la hora de búsqueda son diferentes. Consultarlo manualmente una vez no es difícil; lo difícil es consultarlo cada día con el mismo criterio, dejar un registro y poder explicar por qué un día no hubo datos.
También se puede hacer scraping de la página de búsqueda por cuenta propia, pero originalmente querías monitorizar posiciones y al final terminas manteniendo selectores de página, proxies y reintentos ante excepciones. Para un equipo pequeño con solo unas decenas de palabras clave, un punto de partida más adecuado puede ser: entregar los resultados de búsqueda a una API de SERP y mantener por cuenta propia solo las reglas de monitorización y los registros históricos.

Ilustración generada por IA; no representa datos reales de posiciones.
¶ Primero aclara qué posición estás monitorizando exactamente
Aquí se mide “en los resultados de búsqueda orgánicos devueltos esta vez, para el país e idioma especificados, en qué posición aparece el dominio objetivo”. No es la única posición que verán todos los usuarios, ni los espacios publicitarios, los resultados de mapas o la posición en píxeles de toda la página.
La API de Google SERP de AceDataCloud utiliza POST https://api.acedata.cloud/serp/google. Los resultados de búsqueda orgánicos están en organic, y los elementos incluyen link y position. La solicitud puede especificar condiciones como la consulta, el país, el idioma y la paginación. Los campos deben ajustarse a la documentación actual de la API. Google SERP API
Este ejemplo fija type=search, country=us, language=en, page=1 y number=10. De esta forma el alcance es lo bastante pequeño y fácil de verificar. No consultes hoy inglés de Estados Unidos y mañana inglés del Reino Unido, para luego conectar los valores de ambos días como si fueran una misma línea de tendencia.
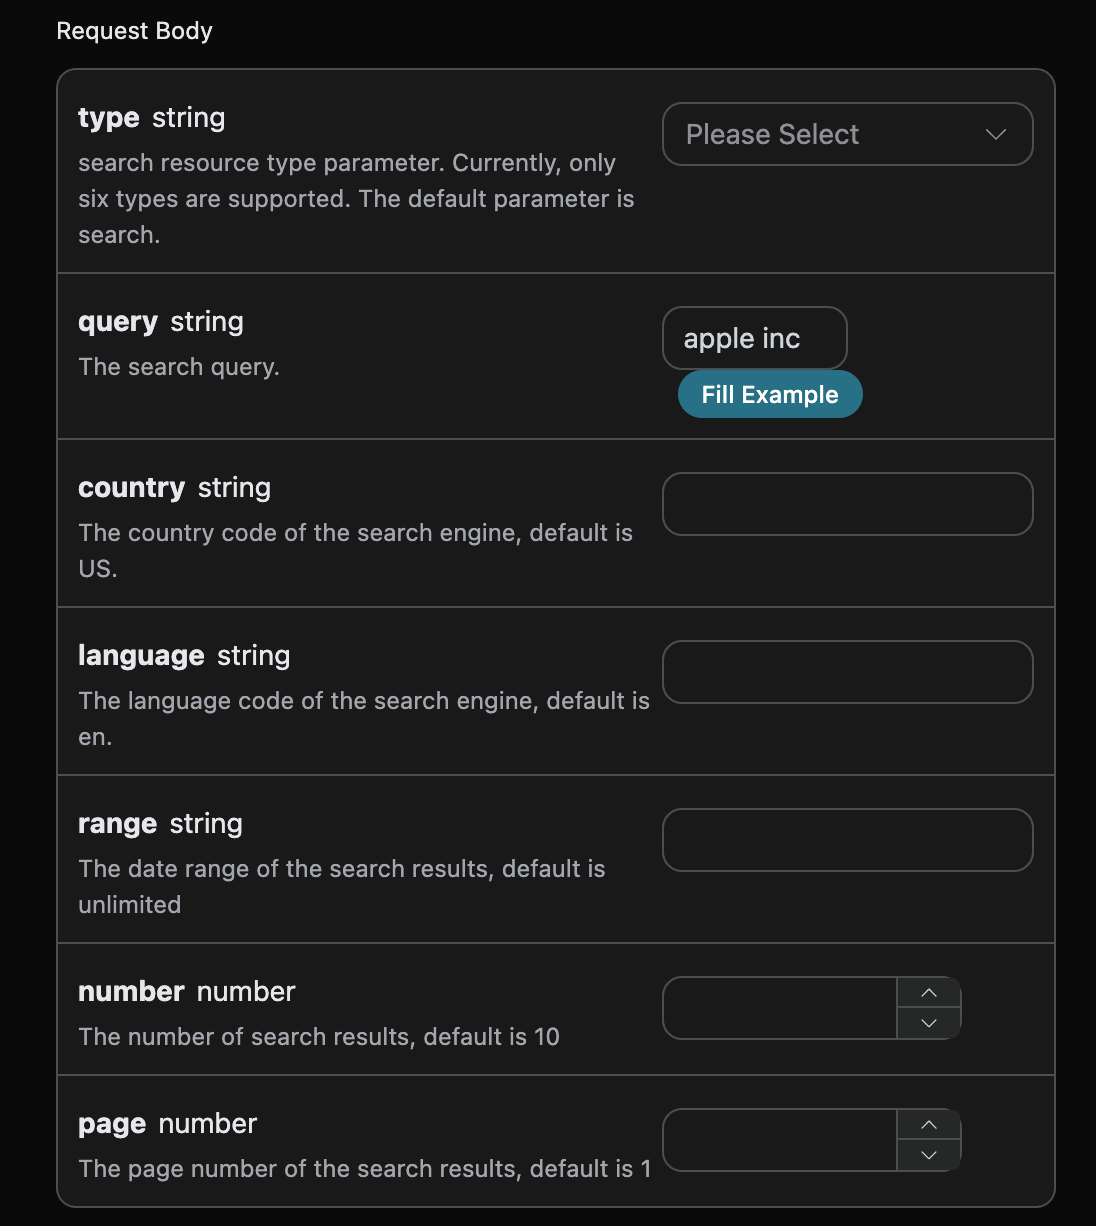
Captura de pantalla del formulario oficial de parámetros; los campos actuales se rigen por la documentación.
También hay un punto especialmente fácil de hacer mal: si se devuelven diez resultados pero no se encuentra tu dominio, no se puede registrar como “fallo de la API”, ni completar directamente como posición undécima. Solo sabes que no apareció en el conjunto devuelto esta vez; no sabes en qué posición está fuera de ese conjunto.
Se recomienda guardar tres estados: found indica que se encontró y se registró la posición; not_found_in_response indica que la API respondió correctamente pero no hubo coincidencia; error indica que hubo un problema con la solicitud, la decodificación o la validación de la estructura. Cuando la posición sea desconocida, deja un valor vacío; no escribas 0 ni 999, ni lo uses para calcular la posición media.
¶ Usa un script para conservar la solicitud y los resultados
El siguiente ejemplo completo depende de Python 3 y requests, y utiliza SQLite incluido en Python para guardar los resultados. Guarda el script como seo_monitor.py, crea keywords.json en el mismo directorio y sustituye el dominio de marcador de posición por el dominio que quieres monitorizar, no por una dirección de página con ruta:
[
  {"query":"reusable travel tumbler","target":"example.com","country":"us","language":"en"}
]
Obtén la API Key desde tu propia aplicación y proporciónala mediante la variable de entorno ACEDATACLOUD_API_KEY; no la escribas en JSON, scripts ni capturas de pantalla. Ejecuta el script después de instalar las dependencias:
python -m pip install 'requests>=2.31,<3'
python seo_monitor.py
La primera vez debes realizar primero una integración real con una sola palabra clave y luego ampliar el alcance.
import json
import os
import sqlite3
from datetime import datetime, timezone
from pathlib import Path
from urllib.parse import urlparse
import requests

ROOT = Path(__file__).resolve().parent

def host(value):
    parsed = urlparse(value if "://" in value else "https://" + value)
    return (parsed.hostname or "").lower().rstrip(".").encode("idna").decode("ascii")

def match(url, target):
    h = host(url)
    return h == target or h.endswith("." + target)

def rank(data, target):
    if not isinstance(data, dict) or data.get("error") or data.get("success") is False:
        raise ValueError("API failure")
    rows = data.get("organic")
    if not isinstance(rows, list):
        raise ValueError("organic missing or invalid")
    hits = []
    for row in rows:
        if not isinstance(row, dict):
            raise ValueError("invalid organic item")
        p, link = row.get("position"), row.get("link")
        if type(p) is not int or p < 1 or not isinstance(link, str):
            raise ValueError("invalid position/link")
        parsed = urlparse(link)
        if parsed.scheme not in ("http", "https") or not parsed.hostname:
            raise ValueError("invalid result URL")
        if match(link, target):
            hits.append((p, link))
    return min(hits) if hits else (None, None)

def main():
    token = os.environ["ACEDATACLOUD_API_KEY"]
    tasks = json.loads((ROOT / "keywords.json").read_text(encoding="utf-8"))
    db = sqlite3.connect(ROOT / "rankings.sqlite3")
    db.execute("""CREATE TABLE IF NOT EXISTS checks (
        checked_at TEXT, keyword TEXT, target TEXT, country TEXT,
        language TEXT, page INTEGER, requested_number INTEGER,
        returned_number INTEGER, status TEXT, position INTEGER,
        landing_url TEXT, error TEXT, raw_json TEXT)""")
    failures = 0
    with requests.Session() as session:
        session.headers.update({"Authorization": "Bearer " + token})
        for task in tasks:
            target = host(task["target"])
            if not target:
                raise ValueError("target must be a domain")
            payload = {"type": "search", "query": task["query"],
                       "country": task["country"], "language": task["language"],
                       "number": 10, "page": 1}
            stamp = datetime.now(timezone.utc).isoformat()
            status, p, link, error, raw, count = "error", None, None, None, None, None
            try:
                r = session.post("https://api.acedata.cloud/serp/google",
                                 json=payload, timeout=(10, 60))
                r.raise_for_status()
                data = r.json()
                raw = json.dumps(data, ensure_ascii=False)
                p, link = rank(data, target)
                count = len(data["organic"])
                status = "found" if p is not None else "not_found_in_response"
            except (requests.RequestException, ValueError) as exc:
                error = type(exc).__name__
                if isinstance(exc, requests.HTTPError) and exc.response is not None:
                    error += ": HTTP " + str(exc.response.status_code)
                failures += 1
            db.execute("INSERT INTO checks VALUES (?,?,?,?,?,?,?,?,?,?,?,?,?)",
                       (stamp, task["query"], target, task["country"], task["language"],
                        1, 10, count, status, p, link, error, raw))
            db.commit()
            print(task["query"], status, p if p is not None else "-")
    db.close()
    raise SystemExit(1 if failures else 0)

if __name__ == "__main__":
    main()
Dentro de rank se comprueban los tipos de datos, las URL y los campos de posición. Una respuesta sin organic se trata como una excepción; en cambio, un array vacío es un resultado vacío normal. La coincidencia de dominios utiliza el hostname de la URL y no hace una comprobación de inclusión de cadenas; de lo contrario, notexample.com también podría identificarse erróneamente como example.com.
Este ejemplo incluye subdominios: shop.example.com puede coincidir con example.com. Si solo te interesa el sitio principal, cámbialo a igualdad estricta; si te interesa un artículo concreto, añade reglas de normalización de rutas. No tomes la mejor posición de todo el sitio como la posición de una página concreta sin haber acordado el criterio.
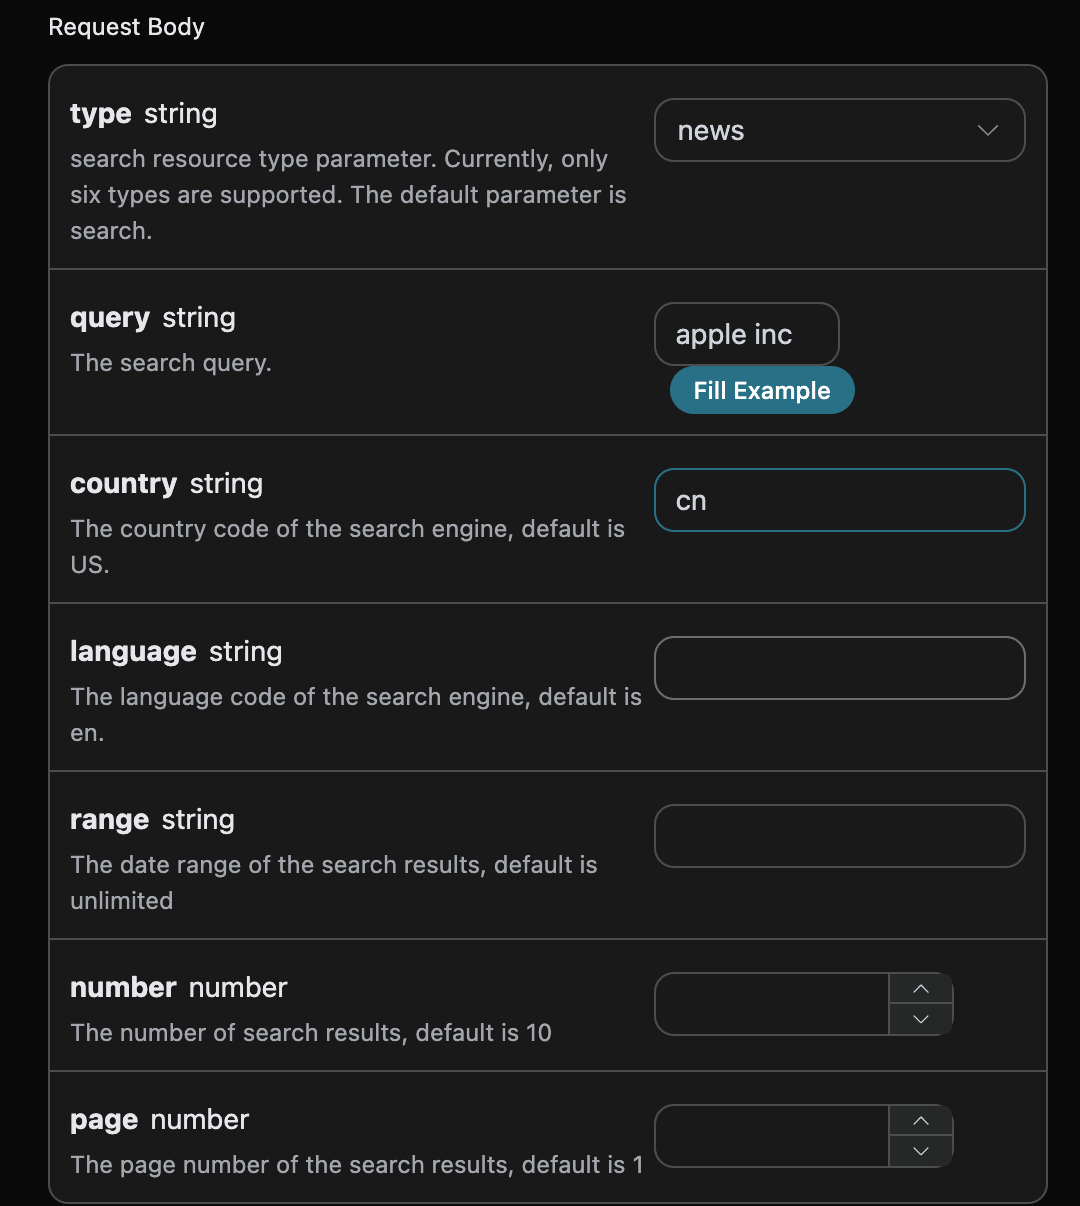
Las condiciones de búsqueda, como región e idioma, deben guardarse junto con los registros de monitoreo.
Cada comprobación registrará la hora, palabra clave, dominio, país, idioma, número de página, cantidad de solicitudes, cantidad realmente devuelta, estado, posición, página de destino, categoría de error y JSON original. Los registros usan hora UTC y se convierten uniformemente a la zona horaria local al mostrar los informes. La respuesta original debe permanecer en su propio almacenamiento para facilitar la trazabilidad; no expongas directamente toda la base de datos.
El script no imprime los encabezados de solicitud. Las excepciones HTTP solo registran la categoría de error y el código de estado; si falla cualquier palabra clave, el proceso finalmente devuelve un código de salida distinto de cero, lo que facilita las alertas del planificador. No tiene reintentos automáticos, y esto es intencional: primero hay que ver los fallos y luego añadir una espera exponencial limitada según las reglas de limitación del servicio; esto es más controlable que repetir solicitudes indefinidamente.
¶ Ejecutarlo automáticamente todos los días no equivale a sacar conclusiones automáticamente todos los días
En tu propio servidor siempre activo, puedes usar cron o un planificador de tareas existente para activarlo una vez al día. A continuación se muestra un ejemplo de cron de Linux; no es una tarea ya configurada para ti:
0 9 * * * /opt/seo/.venv/bin/python /opt/seo/seo_monitor.py >> /opt/seo/run.log 2>&1
La hora de ejecución se interpreta según la zona horaria de cron del servidor. La ruta de Python y la ruta del script deben cambiarse por las ubicaciones reales de implementación; las credenciales deben configurarse en el entorno protegido del proceso de planificación. Que haya variables de entorno en una terminal interactiva no significa que cron las herede automáticamente. Antes de ponerlo en producción, pruébalo con el mismo usuario de ejecución y limita los permisos de los registros, configura la rotación y evita la superposición de tareas.
Al revisar los resultados, mira primero la tasa de éxito y luego las posiciones. Solo compara la diferencia de posición cuando ambas veces haya coincidencia y las condiciones de búsqueda sean iguales. Si ayer estaba en octavo lugar y hoy en quinto, puedes decir que estas dos observaciones subieron tres puestos; si hoy no hay coincidencia, solo puedes decir que no se detectó en este resultado. Si la cantidad devuelta cae repentinamente de diez resultados a dos, también debes descartar primero el impacto de cambios en el conjunto devuelto.
Si necesitas monitoreo de varias páginas, guarda los resultados originales de cada página, verifica la semántica real de position en la interfaz y luego diseña la deduplicación entre páginas. No uses «número de página por diez» para construir una clasificación global sin verificarlo. Este ejemplo consulta deliberadamente solo la primera pantalla, precisamente para no dar a los lectores una clasificación que parece completa pero que en realidad usa criterios incorrectos.
El presupuesto de solicitudes puede estimarse como «número de palabras clave × número de combinaciones de condiciones de búsqueda × número de páginas × número de veces al día». Es volumen de solicitudes y no equivale directamente a la facturación; el costo por solicitud, los niveles de cantidad devuelta y las reglas de facturación por fallos aún deben verificarse según las indicaciones del servicio en ese momento y los registros de uso.
¶ Lo que realmente se ahorra es el tiempo de mantener las páginas de búsqueda
Este script no promete mejorar el SEO ni infiere que una modificación concreta de la página haya causado un cambio de posición. Lo que proporciona es una base de observación trazable que puede distinguir entre fallos y ausencia de coincidencias. Para realizar evaluaciones a más largo plazo, analiza conjuntamente los cambios de contenido, las métricas del sitio y las observaciones continuas.
Primero elige algunas palabras que más le importen al negocio y ejecútalo durante una semana; verificar si cada estado se registra correctamente es más importante que crear un bonito panel el primer día. La API SERP se encarga de obtener los resultados, y tú reservas tu energía para las palabras clave y las páginas mismas.
Alcance de la verificación: el código de ejemplo completó comprobaciones de compilación sin conexión y aserciones de coincidencia de dominio, acierto, resultados vacíos y estructuras anómalas; no se ejecutaron solicitudes SERP reales de pago ni se implementó un servidor o tarea programada. El texto no contiene datos reales de posiciones ni de resultados.