

Gestern hast du den Titel der Landingpage geändert, heute fragt das Betriebsteam: „Ist dieses Keyword gestiegen?“ Du öffnest die Suchseite, suchst lange und beginnst wieder zu zweifeln, ob vielleicht Region, Sprache oder Suchzeit unterschiedlich sind. Einmal manuell nachzusehen ist nicht schwer, schwierig ist es, jeden Tag nach demselben Maßstab zu prüfen, Aufzeichnungen zu hinterlassen und erklären zu können, warum an einem bestimmten Tag keine Daten vorhanden sind.
Die Suchseite selbst zu scrapen ist auch möglich, aber ursprünglich wolltest du Rankings überwachen und am Ende pflegst du Seitenselektoren, Proxys und Wiederholungsversuche bei Ausnahmen. Für kleine Teams mit nur einigen Dutzend Keywords könnte ein passenderer Startpunkt sein: die Suchergebnisse einer SERP API zu überlassen und selbst nur die Überwachungsregeln und historischen Aufzeichnungen zu pflegen.

KI-generierte Darstellung, stellt keine echten Rankingdaten dar.
¶ Zuerst klarstellen: Welches Ranking überwachst du eigentlich?
Hier wird „an welcher Stelle die Zieldomain in den natürlichen Suchergebnissen steht, die für das angegebene Land, die Sprache und diese Rückgabe zurückgegeben werden“ überwacht. Es ist nicht das einzige Ranking, das alle Nutzer sehen, und auch keine Anzeigenposition, Kartenposition oder Pixelposition auf der gesamten Seite.
Die Google-SERP-Schnittstelle von AceDataCloud verwendet POST https://api.acedata.cloud/serp/google. Die natürlichen Suchergebnisse befinden sich in organic, und Einträge enthalten link und position. Die Anfrage kann Bedingungen wie Suchbegriff, Land, Sprache und Seitennummer angeben. Maßgeblich sind die Felder in der aktuellen Schnittstellendokumentation. Google SERP API
Dieses Beispiel legt type=search, country=us, language=en, page=1 und number=10 fest. So bleibt der Umfang klein genug und lässt sich leicht überprüfen. Prüfe nicht heute US-Englisch und morgen britisches Englisch und verbinde dann die Werte beider Tage zu einer Trendlinie.
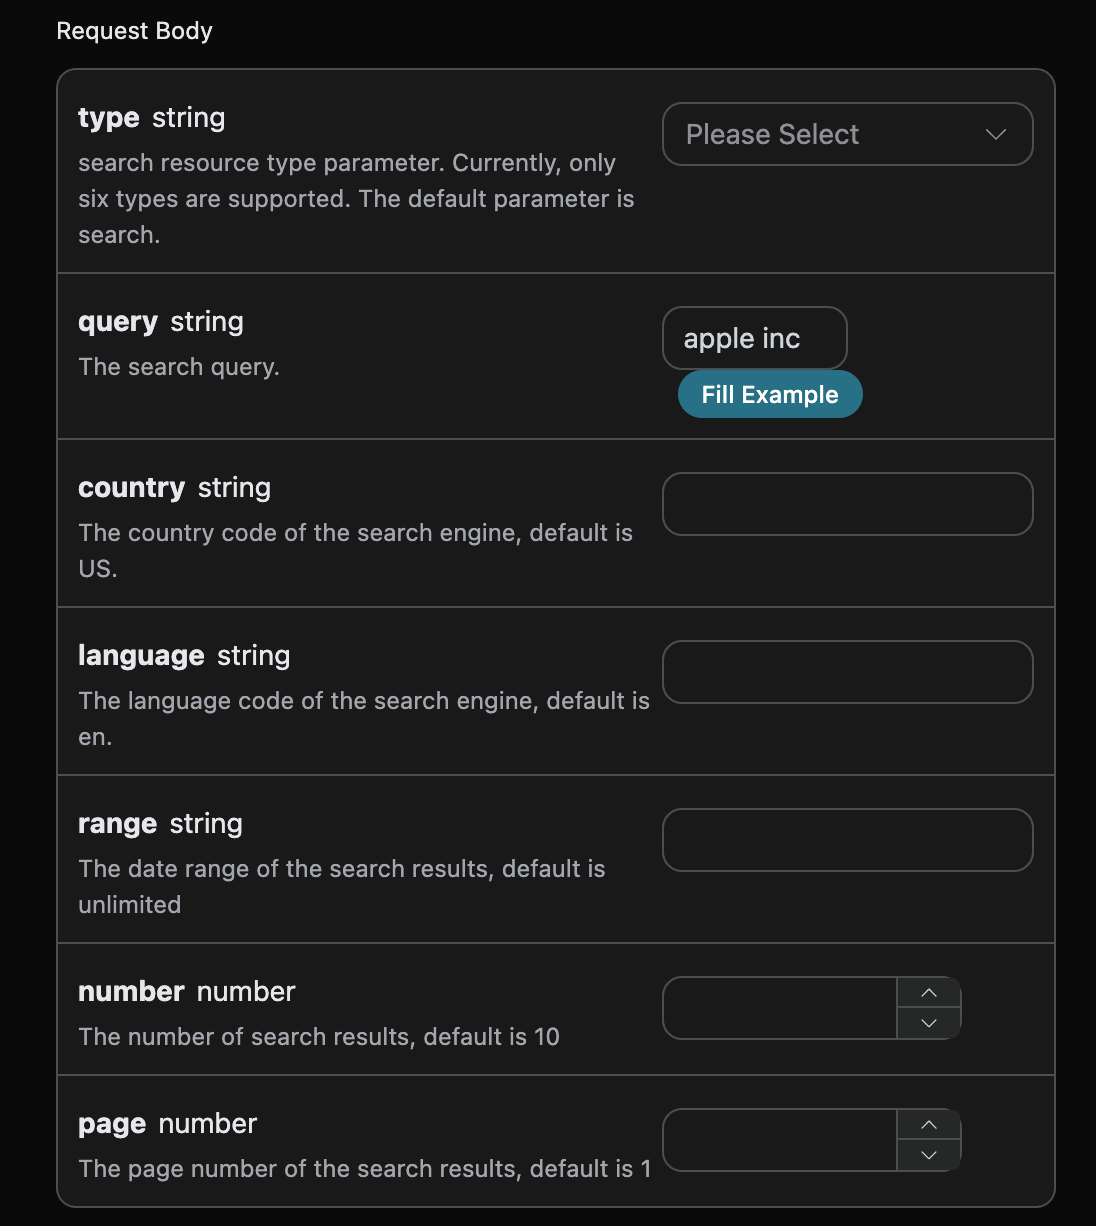
Screenshot des offiziellen Parameterformulars; maßgeblich sind die aktuellen Felder in der Dokumentation.
Es gibt noch einen Punkt, bei dem besonders leicht Fehler passieren: Wenn zehn Ergebnisse zurückgegeben werden, aber deine eigene Domain nicht gefunden wird, darf dies weder als „Schnittstellenfehler“ gespeichert noch direkt als elfter Platz ergänzt werden. Du weißt nur, dass sie nicht in der diesmal zurückgegebenen Menge erschienen ist, nicht aber, an welcher Stelle sie außerhalb dieser Menge rankt.
Es wird empfohlen, drei Status zu speichern: found bedeutet, dass ein Treffer gefunden und die Position gespeichert wurde; not_found_in_response bedeutet, dass die Schnittstelle normal geantwortet hat, aber kein Treffer vorlag; error bedeutet, dass bei Anfrage, Dekodierung oder Strukturvalidierung ein Problem aufgetreten ist. Wenn die Position unbekannt ist, schreibe einen leeren Wert, nicht 0 oder 999, und verwende ihn auch nicht zur Berechnung des Durchschnittsrankings.
¶ Mit einem Skript Anfrage und Ergebnisse festhalten
Das folgende vollständige Beispiel hängt von Python 3 und requests ab und verwendet das in Python integrierte SQLite zum Speichern der Ergebnisse. Speichere das Skript als seo_monitor.py, erstelle im selben Verzeichnis keywords.json und ersetze die Platzhalterdomain durch die zu überwachende Domain, nicht durch eine Seitenadresse mit Pfad:
[
  {"query":"reusable travel tumbler","target":"example.com","country":"us","language":"en"}
]
Den API-Key erhältst du aus deiner eigenen Anwendung und stellst ihn über die Umgebungsvariable ACEDATACLOUD_API_KEY bereit; schreibe ihn nicht in JSON, Skripte oder Screenshots. Führe das Skript nach der Installation der Abhängigkeiten aus:
python -m pip install 'requests>=2.31,<3'
python seo_monitor.py
Bei der ersten Verwendung solltest du zunächst mit einem Keyword einen echten Integrationstest durchführen und den Umfang erst danach erweitern.
import json
import os
import sqlite3
from datetime import datetime, timezone
from pathlib import Path
from urllib.parse import urlparse
import requests

ROOT = Path(__file__).resolve().parent

def host(value):
    parsed = urlparse(value if "://" in value else "https://" + value)
    return (parsed.hostname or "").lower().rstrip(".").encode("idna").decode("ascii")

def match(url, target):
    h = host(url)
    return h == target or h.endswith("." + target)

def rank(data, target):
    if not isinstance(data, dict) or data.get("error") or data.get("success") is False:
        raise ValueError("API failure")
    rows = data.get("organic")
    if not isinstance(rows, list):
        raise ValueError("organic missing or invalid")
    hits = []
    for row in rows:
        if not isinstance(row, dict):
            raise ValueError("invalid organic item")
        p, link = row.get("position"), row.get("link")
        if type(p) is not int or p < 1 or not isinstance(link, str):
            raise ValueError("invalid position/link")
        parsed = urlparse(link)
        if parsed.scheme not in ("http", "https") or not parsed.hostname:
            raise ValueError("invalid result URL")
        if match(link, target):
            hits.append((p, link))
    return min(hits) if hits else (None, None)

def main():
    token = os.environ["ACEDATACLOUD_API_KEY"]
    tasks = json.loads((ROOT / "keywords.json").read_text(encoding="utf-8"))
    db = sqlite3.connect(ROOT / "rankings.sqlite3")
    db.execute("""CREATE TABLE IF NOT EXISTS checks (
        checked_at TEXT, keyword TEXT, target TEXT, country TEXT,
        language TEXT, page INTEGER, requested_number INTEGER,
        returned_number INTEGER, status TEXT, position INTEGER,
        landing_url TEXT, error TEXT, raw_json TEXT)""")
    failures = 0
    with requests.Session() as session:
        session.headers.update({"Authorization": "Bearer " + token})
        for task in tasks:
            target = host(task["target"])
            if not target:
                raise ValueError("target must be a domain")
            payload = {"type": "search", "query": task["query"],
                       "country": task["country"], "language": task["language"],
                       "number": 10, "page": 1}
            stamp = datetime.now(timezone.utc).isoformat()
            status, p, link, error, raw, count = "error", None, None, None, None, None
            try:
                r = session.post("https://api.acedata.cloud/serp/google",
                                 json=payload, timeout=(10, 60))
                r.raise_for_status()
                data = r.json()
                raw = json.dumps(data, ensure_ascii=False)
                p, link = rank(data, target)
                count = len(data["organic"])
                status = "found" if p is not None else "not_found_in_response"
            except (requests.RequestException, ValueError) as exc:
                error = type(exc).__name__
                if isinstance(exc, requests.HTTPError) and exc.response is not None:
                    error += ": HTTP " + str(exc.response.status_code)
                failures += 1
            db.execute("INSERT INTO checks VALUES (?,?,?,?,?,?,?,?,?,?,?,?,?)",
                       (stamp, task["query"], target, task["country"], task["language"],
                        1, 10, count, status, p, link, error, raw))
            db.commit()
            print(task["query"], status, p if p is not None else "-")
    db.close()
    raise SystemExit(1 if failures else 0)

if __name__ == "__main__":
    main()
Innerhalb von rank werden Datentypen sowie URL- und Positionsfelder überprüft. Antworten ohne organic werden als Ausnahme behandelt; ein leeres Array ist hingegen ein normales leeres Ergebnis. Der Domainabgleich verwendet den Hostnamen der URL und keine Prüfung auf Zeichenketteninhalte, da andernfalls auch notexample.com fälschlicherweise als example.com erkannt werden könnte.
Dieses Beispiel schließt Subdomains ein: shop.example.com kann example.com treffen. Wenn du dich nur für die Hauptseite interessierst, ändere dies zu strikter Gleichheit; wenn du einen bestimmten Artikel verfolgst, füge zusätzlich Regeln zur Pfadnormalisierung hinzu. Setze nicht ohne abgestimmten Maßstab die beste Position der gesamten Website mit der Position einer bestimmten Seite gleich.
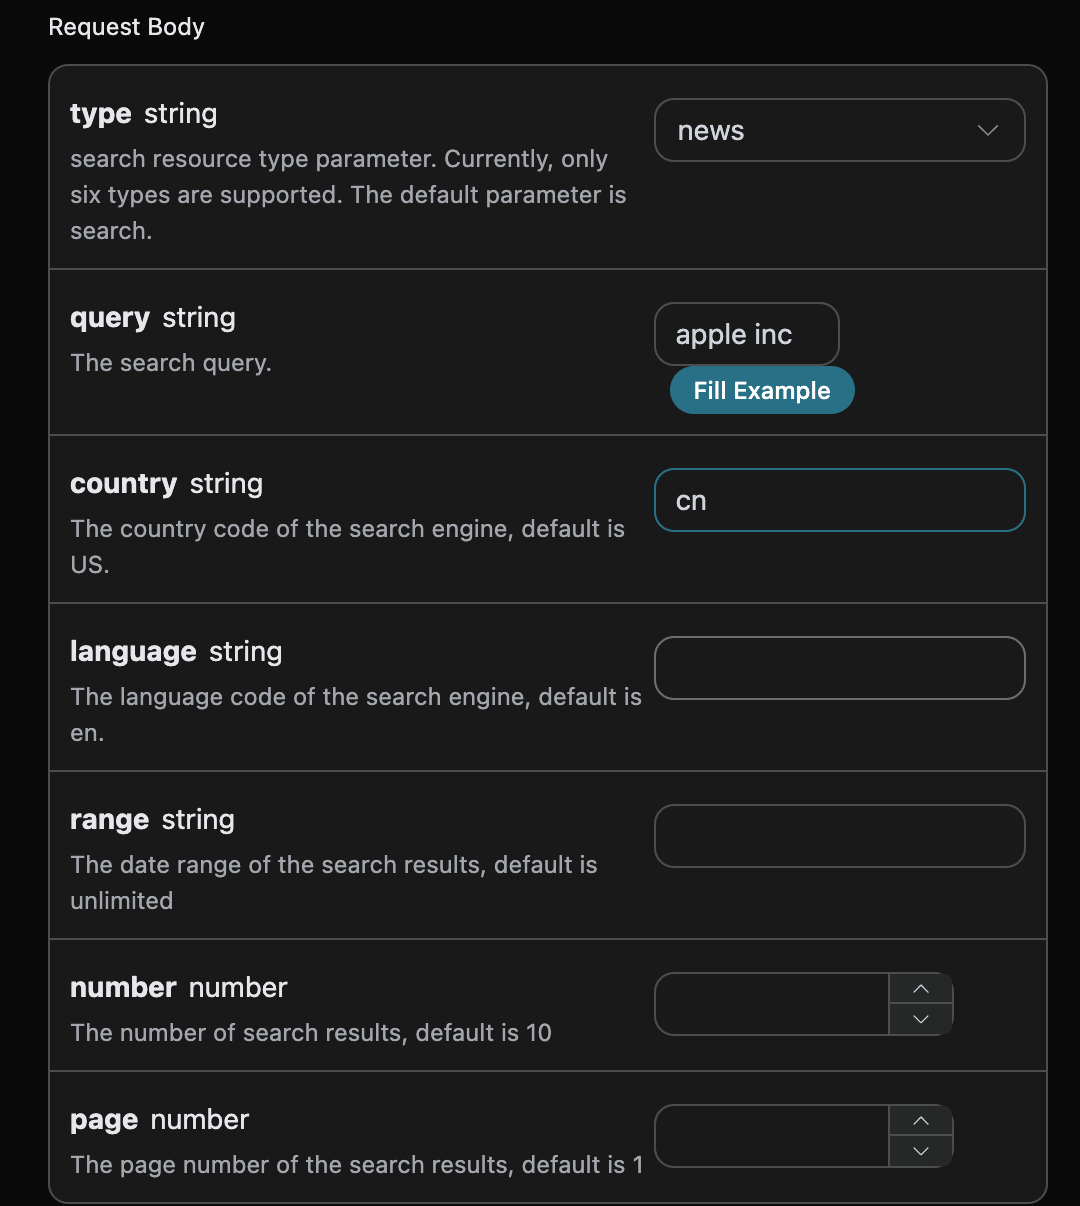
Suchkriterien wie Region, Sprache usw. sollten zusammen mit den Überwachungsaufzeichnungen gespeichert werden.
Jede Prüfung schreibt Zeit, Schlüsselwort, Domain, Land, Sprache, Seitenzahl, Anzahl der Anfragen, tatsächlich zurückgegebene Anzahl, Status, Position, Landingpage, Fehlerkategorie und ursprüngliches JSON. Die Aufzeichnungen verwenden UTC-Zeit und werden erst bei der Berichtsanzeige einheitlich in die lokale Zeitzone umgerechnet. Die ursprünglichen Antworten bleiben im eigenen Speicher, damit sie nachvollzogen werden können; veröffentlichen Sie nicht direkt die gesamte Datenbank.
Das Skript gibt keine Anfrage-Header aus. HTTP-Ausnahmen zeichnen nur Fehlerkategorie und Statuscode auf; schlägt ein beliebiges Schlüsselwort fehl, gibt der Prozess letztlich einen Exit-Code ungleich null zurück, damit der Scheduler alarmieren kann. Es gibt keine automatischen Wiederholungsversuche, und das ist beabsichtigt: Sehen Sie zuerst den Fehler und fügen Sie dann gemäß den Rate-Limiting-Regeln des Dienstes begrenztes Backoff hinzu, statt Anfragen unbegrenzt zu wiederholen, denn das ist kontrollierbarer.
¶ Täglich automatisch ausführen bedeutet nicht, täglich automatisch Schlussfolgerungen zu ziehen
Auf einem eigenen ständig laufenden Server können Sie cron oder einen vorhandenen Aufgabenplaner verwenden, um dies einmal täglich auszulösen. Unten steht ein Linux-cron-Beispiel, keine bereits für Sie konfigurierte Aufgabe:
0 9 * * * /opt/seo/.venv/bin/python /opt/seo/seo_monitor.py >> /opt/seo/run.log 2>&1
Die Ausführungszeit wird gemäß der cron-Zeitzone des Servers interpretiert. Python-Pfad und Skriptpfad müssen durch die tatsächlichen Bereitstellungsorte ersetzt werden; die Anmeldedaten müssen in der geschützten Umgebung des Planungsprozesses konfiguriert werden. Dass im interaktiven Terminal Umgebungsvariablen vorhanden sind, bedeutet nicht, dass cron sie automatisch übernimmt. Testen Sie vor dem Go-live mit demselben Ausführungsbenutzer und beschränken Sie die Log-Berechtigungen, konfigurieren Sie Rotation und verhindern Sie überlappende Aufgaben.
Beim Betrachten der Ergebnisse sehen Sie zuerst auf die Erfolgsrate und dann auf die Platzierung. Nur wenn beide Male ein Treffer erzielt wurde und die Suchbedingungen gleich sind, wird die Positionsdifferenz verglichen. Gestern Platz acht, heute Platz fünf: Man kann sagen, dass die Beobachtung bei diesen beiden Messungen um drei Plätze gestiegen ist; heute kein Treffer: Man kann nur sagen, dass das Ergebnis bei dieser Abfrage nicht gefunden wurde. Wenn die zurückgegebene Anzahl plötzlich von zehn auf zwei sinkt, muss außerdem zuerst der Einfluss einer Veränderung der Ergebnismenge ausgeschlossen werden.
Wenn mehrseitige Überwachung erforderlich ist, speichern Sie die ursprünglichen Ergebnisse jeder Seite, prüfen Sie die tatsächliche Semantik von position der Schnittstelle und entwerfen Sie dann die seitenübergreifende Deduplizierung. Setzen Sie nicht ohne Überprüfung einen globalen Rang zusammen, indem Sie „Seitenzahl mal zehn“ verwenden. Dieses Beispiel fragt absichtlich nur die erste Ergebnisseite ab, damit Leser keine Rangliste erhalten, die vollständig wirkt, aber tatsächlich auf einer falschen Definition beruht.
Das Anfragebudget kann anhand von „Anzahl der Schlüsselwörter × Anzahl der Suchkriterienkombinationen × Seitenzahl × tägliche Häufigkeit“ geschätzt werden. Es ist die Anfragemenge und nicht direkt gleichbedeutend mit der Rechnung; Kosten pro Anfrage, Stufen der zurückgegebenen Menge und Abrechnungsregeln bei Fehlern müssen weiterhin anhand der jeweiligen Dienstbeschreibung und Nutzungsaufzeichnungen geprüft werden.
¶ Was wirklich eingespart wird, ist die Zeit für die Pflege von Suchseiten
Dieses Skript verspricht keine Verbesserung der SEO und leitet auch nicht ab, dass eine bestimmte Seitenänderung eine Veränderung der Platzierung verursacht hat. Was es bietet, ist eine Beobachtungsgrundlage, die nachvollziehbar ist und zwischen Fehlern und Nichttreffern unterscheiden kann. Für langfristigere Beurteilungen sollten Inhaltsänderungen, Website-Kennzahlen und fortlaufende Beobachtungen gemeinsam analysiert werden.
Wählen Sie zunächst einige für das Geschäft besonders wichtige Begriffe aus und lassen Sie sie eine Woche laufen. Zu prüfen, ob jeder Status korrekt aufgezeichnet wurde, ist wichtiger, als am ersten Tag ein hübsches großes Dashboard zu erstellen. Die SERP API übernimmt die Ergebnisabfrage, und Sie konzentrieren sich auf die Schlüsselwörter und die Seiten selbst.
Validierungsumfang: Der Beispielcode hat Offline-Kompilierungsprüfungen sowie Assertions für Domain-Abgleich, Treffer, leere Ergebnisse und Ausnahme-Strukturen abgeschlossen; es wurden keine echten kostenpflichtigen SERP-Anfragen ausgeführt und kein Server oder Zeitplaner bereitgestellt. Der Text enthält keine echten Ranking- oder Leistungsdaten.