

أمس عدّلت عنوان الصفحة المقصودة، واليوم سأل فريق العمليات: «هل ارتفعت تلك الكلمة المفتاحية؟» تفتح صفحة البحث، وتبحث طويلًا، ثم تبدأ بالشك فيما إذا كانت المنطقة أو اللغة أو وقت البحث مختلفًا. التحقق يدويًا مرة واحدة ليس صعبًا، لكن الصعب هو التحقق كل يوم بالمعيار نفسه، وترك سجل، والقدرة على تفسير سبب عدم وجود بيانات في يوم ما.
يمكنك أيضًا استخراج صفحات البحث بنفسك، لكنك في الأصل أردت مراقبة الترتيب، وفي النهاية تجد نفسك تصون محددات الصفحة، والوكلاء، وإعادة المحاولة عند الاستثناءات. بالنسبة إلى فريق صغير لديه بضع عشرات فقط من الكلمات المفتاحية، قد تكون نقطة البداية الأنسب هي: تسليم نتائج البحث إلى SERP API، والاكتفاء بنفسك بصيانة قواعد المراقبة والسجلات التاريخية.

رسم توضيحي مولّد بالذكاء الاصطناعي، ولا يمثل بيانات ترتيب حقيقية.
¶ لنوضح أولًا، أي ترتيب تراقب بالضبط
ما نقوم به هنا هو «في نتائج البحث العضوية التي تم إرجاعها هذه المرة، ضمن الدولة واللغة المحددتين، ما ترتيب النطاق المستهدف». ليس هو الترتيب الوحيد الذي يراه جميع المستخدمين، وليس مواضع الإعلانات أو الخرائط أو الموقع البكسلي للصفحة بأكملها.
تستخدم واجهة Google SERP من AceDataCloud POST https://api.acedata.cloud/serp/google. توجد نتائج البحث العضوية في organic، وتتضمن العناصر link وposition. يمكن للطلب تحديد عبارة البحث والدولة واللغة وشروط الترقيم وغيرها. يجب الرجوع إلى وثائق الواجهة الحالية بالنسبة إلى الحقول. Google SERP API
يثبّت هذا المثال type=search وcountry=us وlanguage=en وpage=1 وnumber=10. بهذا يكون النطاق صغيرًا بما يكفي ويسهل التحقق منه. لا تبحث اليوم بالإنجليزية الأمريكية، وغدًا بالإنجليزية البريطانية، ثم تصل قيم اليومين في خط اتجاه واحد.
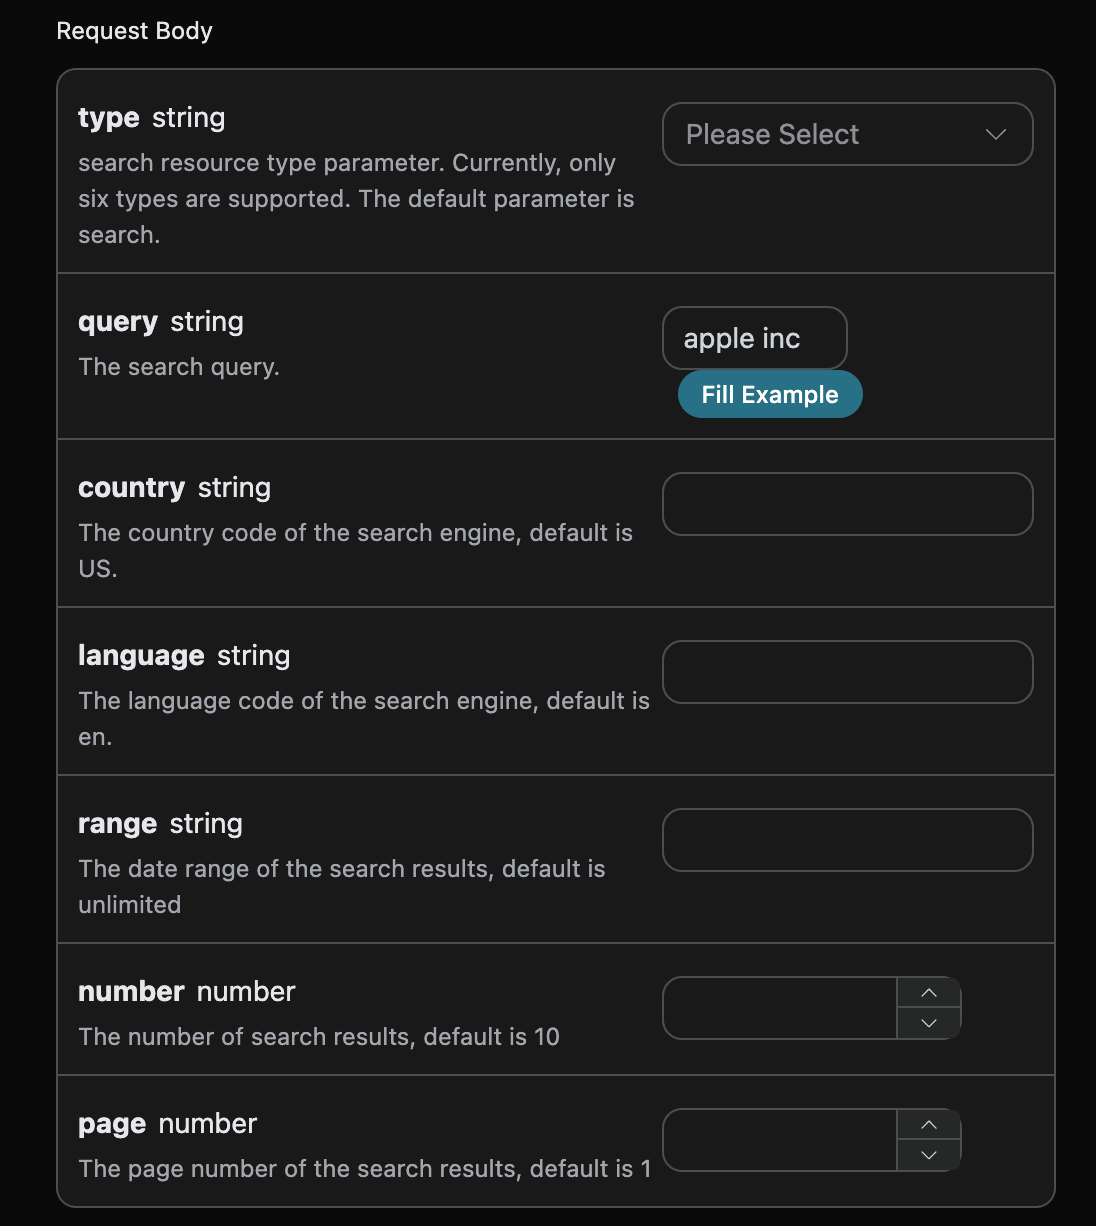
لقطة شاشة لنموذج المعلمات الرسمي؛ الحقول الحالية تخضع للوثائق.
هناك موضع آخر يسهل الخطأ فيه بشكل خاص: إذا أعاد النظام عشر نتائج ولم تجد نطاقك، فلا يمكن تسجيل ذلك على أنه «فشل في الواجهة»، ولا يمكنك إضافته مباشرة بوصفه المركز الحادي عشر. كل ما تعرفه هو أنه لم يظهر في مجموعة النتائج المعادة هذه المرة، ولا تعرف ترتيبه خارج هذه المجموعة.
يُنصح بحفظ ثلاث حالات: تشير found إلى العثور عليه وتسجيل الموضع؛ وتشير not_found_in_response إلى أن الواجهة أعادت استجابة بشكل طبيعي ولكن لم يحدث تطابق؛ وتشير error إلى وجود مشكلة في الطلب أو فك الترميز أو التحقق من البنية. عندما يكون الموضع غير معروف، اكتب قيمة فارغة، ولا تكتب 0 أو 999، ولا تستخدمه لحساب متوسط الترتيب.
¶ استخدم نصًا برمجيًا واحدًا للاحتفاظ بالطلب والنتيجة
يعتمد المثال الكامل التالي على Python 3 وrequests، ويستخدم SQLite المدمج في Python لحفظ النتائج. احفظ النص البرمجي باسم seo_monitor.py، وأنشئ keywords.json في المجلد نفسه، واستبدل النطاق الوهمي بالنطاق المراد مراقبته، وليس بعنوان صفحة يتضمن مسارًا:
[
  {"query":"reusable travel tumbler","target":"example.com","country":"us","language":"en"}
]
احصل على API Key من تطبيقك الخاص، وقدّمه عبر متغير البيئة ACEDATACLOUD_API_KEY؛ لا تكتبه في JSON أو النص البرمجي أو لقطات الشاشة. شغّل النص البرمجي بعد تثبيت التبعية:
python -m pip install 'requests>=2.31,<3'
python seo_monitor.py
عند الاستخدام لأول مرة، ينبغي أولًا إجراء اختبار تكامل فعلي باستخدام كلمة مفتاحية واحدة، ثم توسيع النطاق.
import json
import os
import sqlite3
from datetime import datetime, timezone
from pathlib import Path
from urllib.parse import urlparse
import requests

ROOT = Path(__file__).resolve().parent

def host(value):
    parsed = urlparse(value if "://" in value else "https://" + value)
    return (parsed.hostname or "").lower().rstrip(".").encode("idna").decode("ascii")

def match(url, target):
    h = host(url)
    return h == target or h.endswith("." + target)

def rank(data, target):
    if not isinstance(data, dict) or data.get("error") or data.get("success") is False:
        raise ValueError("API failure")
    rows = data.get("organic")
    if not isinstance(rows, list):
        raise ValueError("organic missing or invalid")
    hits = []
    for row in rows:
        if not isinstance(row, dict):
            raise ValueError("invalid organic item")
        p, link = row.get("position"), row.get("link")
        if type(p) is not int or p < 1 or not isinstance(link, str):
            raise ValueError("invalid position/link")
        parsed = urlparse(link)
        if parsed.scheme not in ("http", "https") or not parsed.hostname:
            raise ValueError("invalid result URL")
        if match(link, target):
            hits.append((p, link))
    return min(hits) if hits else (None, None)

def main():
    token = os.environ["ACEDATACLOUD_API_KEY"]
    tasks = json.loads((ROOT / "keywords.json").read_text(encoding="utf-8"))
    db = sqlite3.connect(ROOT / "rankings.sqlite3")
    db.execute("""CREATE TABLE IF NOT EXISTS checks (
        checked_at TEXT, keyword TEXT, target TEXT, country TEXT,
        language TEXT, page INTEGER, requested_number INTEGER,
        returned_number INTEGER, status TEXT, position INTEGER,
        landing_url TEXT, error TEXT, raw_json TEXT)""")
    failures = 0
    with requests.Session() as session:
        session.headers.update({"Authorization": "Bearer " + token})
        for task in tasks:
            target = host(task["target"])
            if not target:
                raise ValueError("target must be a domain")
            payload = {"type": "search", "query": task["query"],
                       "country": task["country"], "language": task["language"],
                       "number": 10, "page": 1}
            stamp = datetime.now(timezone.utc).isoformat()
            status, p, link, error, raw, count = "error", None, None, None, None, None
            try:
                r = session.post("https://api.acedata.cloud/serp/google",
                                 json=payload, timeout=(10, 60))
                r.raise_for_status()
                data = r.json()
                raw = json.dumps(data, ensure_ascii=False)
                p, link = rank(data, target)
                count = len(data["organic"])
                status = "found" if p is not None else "not_found_in_response"
            except (requests.RequestException, ValueError) as exc:
                error = type(exc).__name__
                if isinstance(exc, requests.HTTPError) and exc.response is not None:
                    error += ": HTTP " + str(exc.response.status_code)
                failures += 1
            db.execute("INSERT INTO checks VALUES (?,?,?,?,?,?,?,?,?,?,?,?,?)",
                       (stamp, task["query"], target, task["country"], task["language"],
                        1, 10, count, status, p, link, error, raw))
            db.commit()
            print(task["query"], status, p if p is not None else "-")
    db.close()
    raise SystemExit(1 if failures else 0)

if __name__ == "__main__":
    main()
يتحقق rank داخليًا من أنواع البيانات وعناوين المواقع وحقول المواضع. تُعامل الاستجابة التي تفتقد organic باعتبارها استثناءً؛ أما المصفوفة الفارغة فهي نتيجة فارغة طبيعية. تستخدم مطابقة النطاق hostname في عنوان URL، ولا تُجرى مطابقة احتواء نصي، وإلا فقد يُخطأ في اعتبار notexample.com هو example.com.
يتضمن هذا المثال النطاقات الفرعية: يمكن أن يطابق shop.example.com النطاق example.com. إذا كنت تهتم بالموقع الرئيسي فقط، فغيّرها إلى تطابق تام؛ وإذا كنت تهتم بمقالة معينة، فأضف قواعد لتطبيع المسار. لا تعتبر أفضل موضع في الموقع كله موضع صفحة معينة من دون الاتفاق على المعيار.
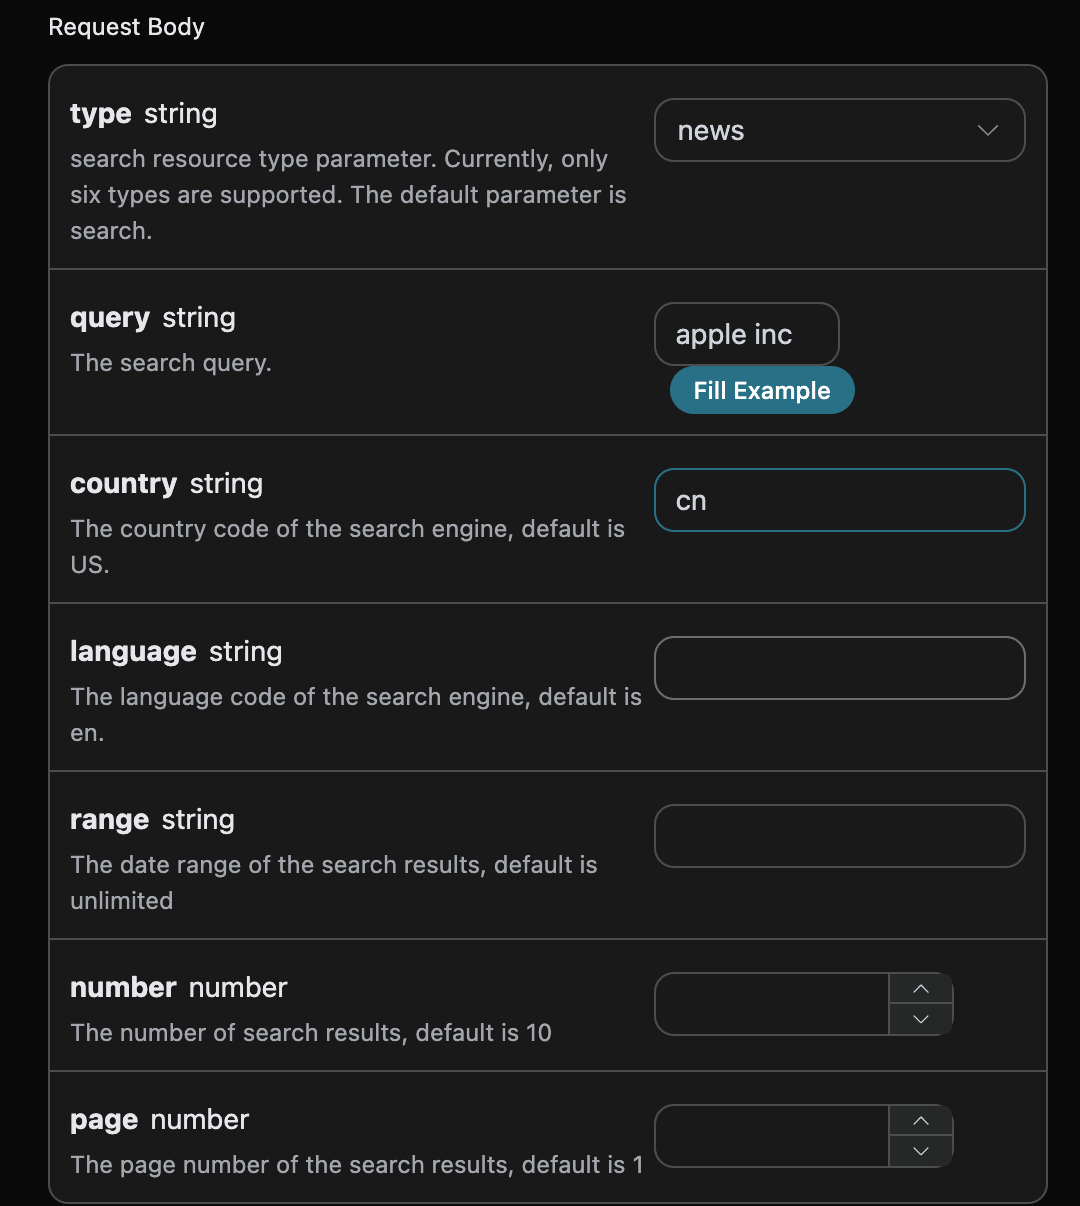
يجب حفظ شروط البحث مثل المنطقة واللغة مع سجل المراقبة.
تُكتب في كل عملية فحص معلومات الوقت، والكلمة المفتاحية، والنطاق، والبلد، واللغة، ورقم الصفحة، وعدد الطلبات، وعدد النتائج الفعلية المعادة، والحالة، والموضع، والصفحة المقصودة، وفئة الخطأ وJSON الخام. تُسجَّل السجلات بتوقيت UTC، ثم تُحوَّل بشكل موحد إلى المنطقة الزمنية المحلية عند عرض التقارير. احتفظ بالاستجابات الخام في مساحة التخزين الخاصة بك لتسهيل التتبع، ولا تنشر قاعدة البيانات كاملةً مباشرةً.
لا يطبع البرنامج النصي رؤوس الطلبات. تسجل استثناءات HTTP فئة الخطأ ورمز الحالة فقط؛ وإذا فشلت أي كلمة مفتاحية، فستُرجع العملية في النهاية رمز خروج غير صفري، لتسهيل تنبيهات المجدول. لا يحتوي على إعادة محاولة تلقائية، وهذا مقصود: اعرض الفشل أولاً، ثم أضف تراجعًا محدودًا وفقًا لقواعد تقييد الخدمة، فهذا أكثر قابلية للتحكم من تكرار الطلبات بلا نهاية.
¶ التشغيل التلقائي يوميًا لا يعني استخلاص النتائج تلقائيًا يوميًا
على خادمك الدائم التشغيل، يمكنك استخدام cron أو مجدول المهام الحالي للتشغيل مرة كل يوم. فيما يلي مثال Linux cron، وليس مهمة تم إعدادها لك مسبقًا:
0 9 * * * /opt/seo/.venv/bin/python /opt/seo/seo_monitor.py >> /opt/seo/run.log 2>&1
يُفسَّر وقت التنفيذ وفقًا للمنطقة الزمنية لـ cron على الخادم. يجب استبدال مسار Python ومسار البرنامج النصي بمواقع النشر الفعلية؛ ويجب إعداد بيانات الاعتماد في البيئة المحمية لعملية الجدولة. وجود متغيرات البيئة في الطرفية التفاعلية لا يعني أن cron سيرثها تلقائيًا. اختبر باستخدام مستخدم التنفيذ نفسه قبل الإطلاق، وقيّد أذونات السجل، واضبط التدوير، ومنع تداخل المهام.
عند عرض النتائج، انظر أولاً إلى معدل النجاح، ثم إلى الترتيب. لا تقارن فرق الموضع إلا إذا تم العثور عليه في المرتين وكانت شروط البحث متطابقة. إذا كان في المرتبة الثامنة أمس والخامسة اليوم، فيمكن القول إنه ارتفع ثلاث مراتب في هاتين الملاحظتين؛ أما إذا لم يُعثر عليه اليوم، فلا يمكن إلا القول إن نتائج هذه المرة لم تكشف عنه. وإذا انخفض عدد النتائج المعادة فجأة من عشر إلى اثنتين، فيجب أيضًا استبعاد تأثير تغير مجموعة النتائج أولاً.
عند الحاجة إلى مراقبة صفحات متعددة، احفظ النتائج الخام لكل صفحة، وتحقق من المعنى الفعلي لـ position في الواجهة، ثم صمم إزالة التكرار عبر الصفحات. لا تُنشئ ترتيبًا عالميًا باستخدام «رقم الصفحة مضروبًا في عشرة» دون تحقق. يتعمد هذا المثال الاستعلام عن الصفحة الأولى فقط، وذلك حتى لا يقدم للقارئ لوحة ترتيب تبدو مكتملة بينما يكون معيارها الفعلي خاطئًا.
يمكن تقدير ميزانية الطلبات وفقًا لـ «عدد الكلمات المفتاحية × عدد مجموعات شروط البحث × عدد الصفحات × عدد المرات اليومية». إنها كمية طلبات، ولا تساوي الفاتورة مباشرةً؛ فما زال ينبغي التحقق من تكلفة المرة الواحدة، وشرائح عدد النتائج المعادة، وقواعد احتساب فشل الطلبات بالرجوع إلى وصف الخدمة وسجلات الاستخدام في ذلك الوقت.
¶ ما يتم توفيره فعليًا هو وقت صيانة صفحات البحث
لا يعد هذا البرنامج النصي بتحسين SEO، ولا يستنتج أن تعديلًا معينًا للصفحة تسبب في تغير الترتيب. ما يوفره هو أساس للمراقبة قابل للتتبع، وقادر على التمييز بين الفشل وعدم العثور. وللحكم على المدى الأطول، اجمع بين تعديلات المحتوى ومؤشرات الموقع والملاحظات المستمرة لتحليلها معًا.
ابدأ بتشغيل بضعة كلمات يهتم بها العمل أكثر لمدة أسبوع، وتحقق مما إذا كانت كل حالة تُسجَّل بشكل صحيح؛ فهذا أهم من إنشاء لوحة كبيرة جميلة في اليوم الأول. يتولى SERP API الحصول على النتائج، وتبقي تركيزك على الكلمات المفتاحية والصفحات نفسها.
**نطاق التحقق:**أكمل كود المثال فحص التجميع دون اتصال بالإنترنت، واختبارات نطاقات المطابقة، والعثور، والنتائج الفارغة، وبنية الاستثناءات؛ ولم ينفذ طلبات SERP مدفوعة حقيقية، ولم ينشر خادمًا أو مهمة مجدولة. لا توجد في النص بيانات ترتيب أو نتائج فعلية.