

昨天改了落地页标题,今天运营问:“那个关键词涨了吗?”你打开搜索页,找了半天,又开始怀疑是不是地区、语言或者搜索时间不同。手工查一次不难,难的是每天用同一个口径查,留下记录,还能解释某天为什么没数据。
自己抓搜索页面也能做,但你原本想监测排名,最后却在维护页面选择器、代理和异常重试。对只有几十个关键词的小团队,更合适的起点可能是:把搜索结果交给 SERP API,自己只维护监测规则和历史记录。

AI 生成示意,不代表真实排名数据。
¶ 先说清楚,你到底在监测哪个排名
这里做的是“在指定国家、语言和本次返回的自然搜索结果里,目标域名排在哪里”。不是所有用户都会看到的唯一排名,也不是广告位、地图位或整张页面的像素位置。
AceDataCloud 的 Google SERP 接口使用 POST https://api.acedata.cloud/serp/google。自然搜索结果在 organic 中,条目包含 link 和 position。请求可指定查询词、国家、语言及分页等条件。字段应以当前接口文档为准。Google SERP API
本例固定 type=search、country=us、language=en、page=1、number=10。这样范围够小,容易复核。不要今天查美国英语,明天查英国英语,却把两天的值连成一条趋势线。
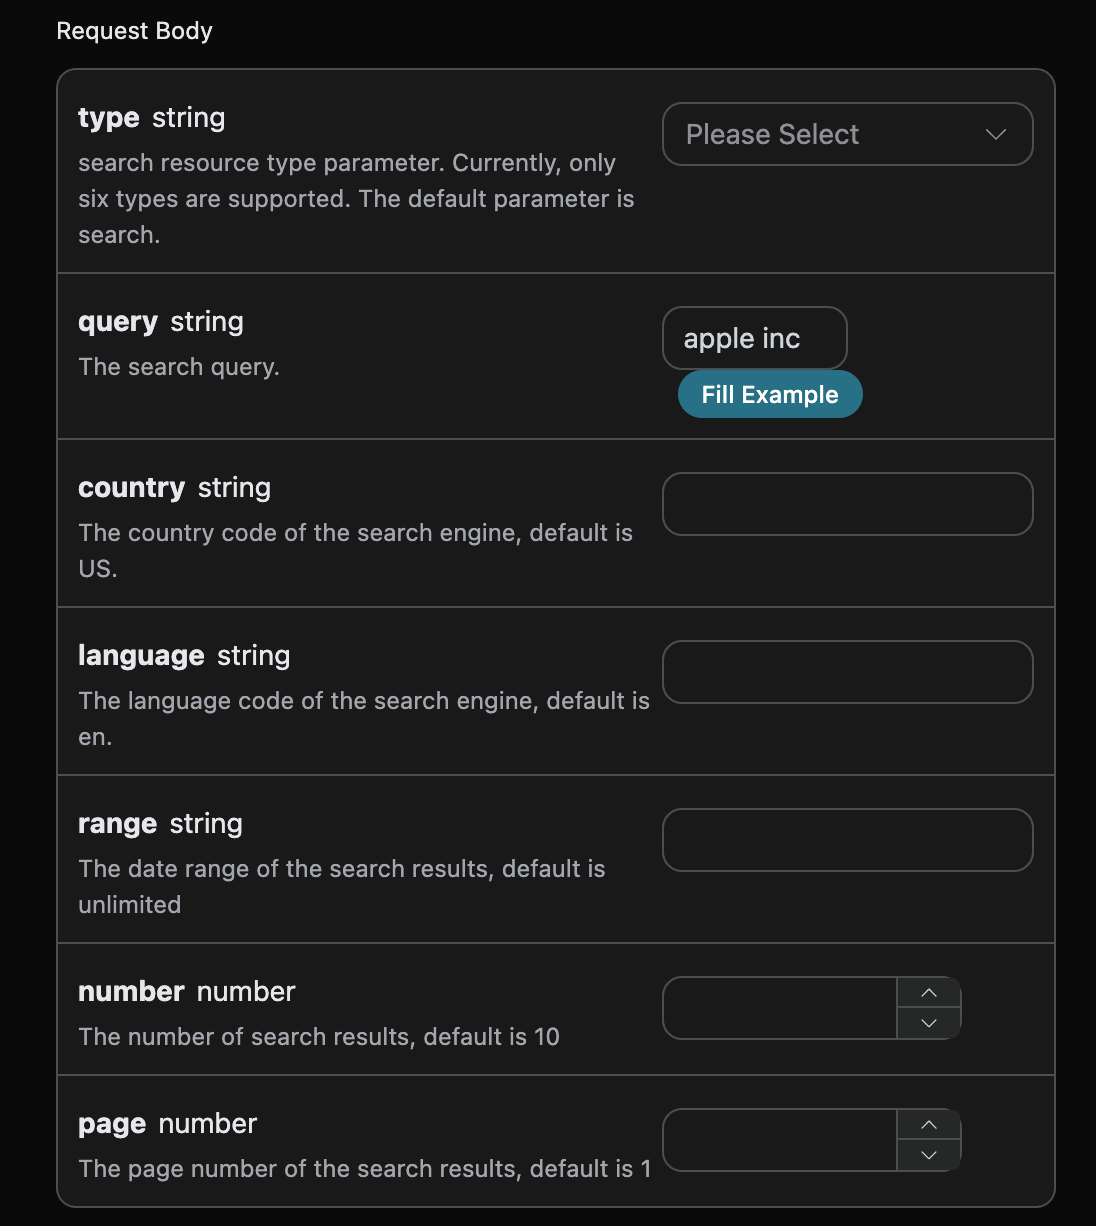
官方参数表单截图;当前字段以文档为准。
还有一个特别容易做错的地方:返回十条结果,却没找到自己的域名,不能记成“接口失败”,也不能直接补成第十一名。你只知道它没有出现在这次返回的集合里,不知道它在集合之外排在哪里。
建议保存三种状态:found 表示找到并记录位置;not_found_in_response 表示接口正常返回但未命中;error 表示请求、解码或结构校验出了问题。位置未知时写空值,不写 0、999,也不拿它算平均排名。
¶ 用一个脚本,把请求和结果留下来
下面的完整示例依赖 Python 3 和 requests,使用 Python 自带的 SQLite 保存结果。将脚本保存为 seo_monitor.py,在同目录创建 keywords.json,把占位域名换成要监测的域名,而不是带路径的页面地址:
[
  {"query":"reusable travel tumbler","target":"example.com","country":"us","language":"en"}
]
API Key 从自己的应用里获取,通过 ACEDATACLOUD_API_KEY 环境变量提供;不要写进 JSON、脚本或截图。安装依赖后运行脚本:
python -m pip install 'requests>=2.31,<3'
python seo_monitor.py
首次使用应先用一个关键词做真实联调,再扩大范围。
import json
import os
import sqlite3
from datetime import datetime, timezone
from pathlib import Path
from urllib.parse import urlparse
import requests

ROOT = Path(__file__).resolve().parent

def host(value):
    parsed = urlparse(value if "://" in value else "https://" + value)
    return (parsed.hostname or "").lower().rstrip(".").encode("idna").decode("ascii")

def match(url, target):
    h = host(url)
    return h == target or h.endswith("." + target)

def rank(data, target):
    if not isinstance(data, dict) or data.get("error") or data.get("success") is False:
        raise ValueError("API failure")
    rows = data.get("organic")
    if not isinstance(rows, list):
        raise ValueError("organic missing or invalid")
    hits = []
    for row in rows:
        if not isinstance(row, dict):
            raise ValueError("invalid organic item")
        p, link = row.get("position"), row.get("link")
        if type(p) is not int or p < 1 or not isinstance(link, str):
            raise ValueError("invalid position/link")
        parsed = urlparse(link)
        if parsed.scheme not in ("http", "https") or not parsed.hostname:
            raise ValueError("invalid result URL")
        if match(link, target):
            hits.append((p, link))
    return min(hits) if hits else (None, None)

def main():
    token = os.environ["ACEDATACLOUD_API_KEY"]
    tasks = json.loads((ROOT / "keywords.json").read_text(encoding="utf-8"))
    db = sqlite3.connect(ROOT / "rankings.sqlite3")
    db.execute("""CREATE TABLE IF NOT EXISTS checks (
        checked_at TEXT, keyword TEXT, target TEXT, country TEXT,
        language TEXT, page INTEGER, requested_number INTEGER,
        returned_number INTEGER, status TEXT, position INTEGER,
        landing_url TEXT, error TEXT, raw_json TEXT)""")
    failures = 0
    with requests.Session() as session:
        session.headers.update({"Authorization": "Bearer " + token})
        for task in tasks:
            target = host(task["target"])
            if not target:
                raise ValueError("target must be a domain")
            payload = {"type": "search", "query": task["query"],
                       "country": task["country"], "language": task["language"],
                       "number": 10, "page": 1}
            stamp = datetime.now(timezone.utc).isoformat()
            status, p, link, error, raw, count = "error", None, None, None, None, None
            try:
                r = session.post("https://api.acedata.cloud/serp/google",
                                 json=payload, timeout=(10, 60))
                r.raise_for_status()
                data = r.json()
                raw = json.dumps(data, ensure_ascii=False)
                p, link = rank(data, target)
                count = len(data["organic"])
                status = "found" if p is not None else "not_found_in_response"
            except (requests.RequestException, ValueError) as exc:
                error = type(exc).__name__
                if isinstance(exc, requests.HTTPError) and exc.response is not None:
                    error += ": HTTP " + str(exc.response.status_code)
                failures += 1
            db.execute("INSERT INTO checks VALUES (?,?,?,?,?,?,?,?,?,?,?,?,?)",
                       (stamp, task["query"], target, task["country"], task["language"],
                        1, 10, count, status, p, link, error, raw))
            db.commit()
            print(task["query"], status, p if p is not None else "-")
    db.close()
    raise SystemExit(1 if failures else 0)

if __name__ == "__main__":
    main()
rank 内部会检查数据类型、网址和位置字段。缺少 organic 的响应被当作异常;空数组则是正常的空结果。域名匹配使用 URL 的 hostname,不做字符串包含判断,否则 notexample.com 也可能被误认作 example.com。
本例包含子域名:shop.example.com 可以命中 example.com。如果你只关心主站,改为严格相等;如果关注某一篇文章,再增加路径规范化规则。不要没商量口径,就把全站最好位置当成某个页面的位置。
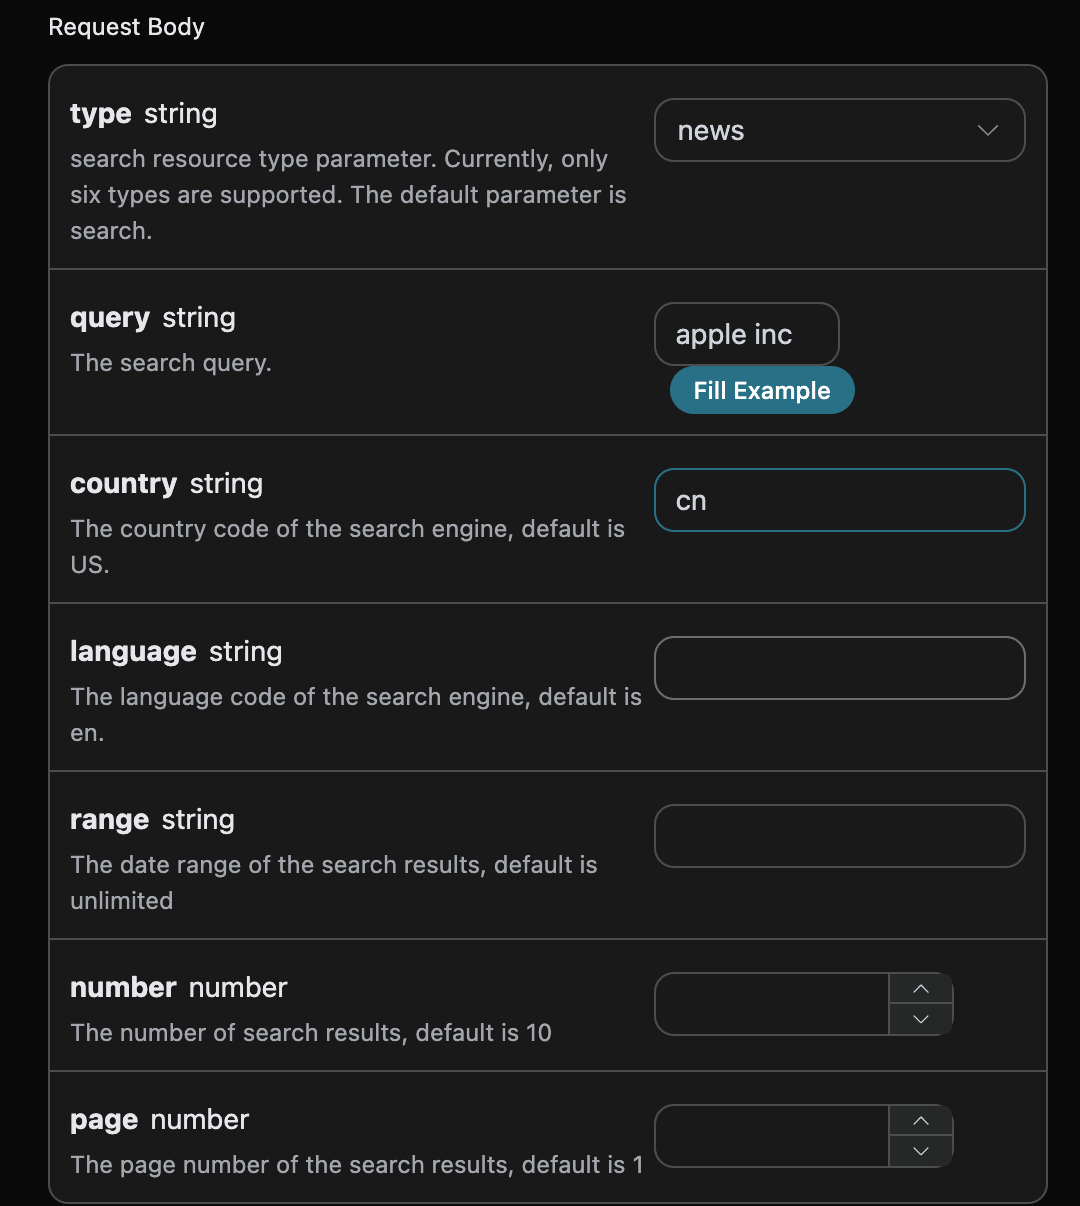
地区、语言等搜索条件应随监测记录一同保存。
每次检查都会写入时间、关键词、域名、国家、语言、页码、请求数量、实际返回数量、状态、位置、落地页、错误类别和原始 JSON。记录用 UTC 时间,报表展示时再统一转成本地时区。原始响应留在自己的存储里,便于追溯,不要直接公开整个数据库。
脚本不会打印请求头。HTTP 异常只记录错误类别和状态码;任一关键词失败,进程最终返回非零退出码,方便调度器告警。它没有自动重试,这是有意的:先把失败看见,再根据服务限流规则增加有上限的退避,比无限重复请求更可控。
¶ 每天自动跑,不等于每天自动下结论
在自己的常开服务器上,可以用 cron 或现有任务调度器每天触发一次。下面是 Linux cron 示例,不是已经替你配置好的任务:
0 9 * * * /opt/seo/.venv/bin/python /opt/seo/seo_monitor.py >> /opt/seo/run.log 2>&1
执行时间按服务器的 cron 时区解释。Python 路径、脚本路径要换成真实部署位置;凭据需要在调度进程的受保护环境中配置。交互式终端里有环境变量,不代表 cron 自动继承。上线前用同一执行用户测试,并限制日志权限、配置轮转,防止任务重叠。
查看结果时,先看成功率,再看排名。两次都命中、搜索条件相同,才比较位置差。昨天第八、今天第五,可以说这两次观测上升三位;今天没命中,只能说本次结果未检出。若返回数量突然从十条变成两条,还要先排除返回集合变化的影响。
需要多页监测时,保存每页原始结果,核对接口 position 的实际语义,再设计跨页去重。别未经验证就用“页码乘十”拼出全局排名。本例刻意只查首屏,就是为了不给读者一个看似完整、实际口径错误的排行榜。
请求预算可以按“关键词数 × 搜索条件组合数 × 页数 × 每日次数”估算。它是请求量,不直接等于账单;单次费用、返回数量档位及失败计费规则仍需以服务当时的说明和用量记录核对。
¶ 真正省下来的,是维护搜索页面的时间
这个脚本不承诺改善 SEO,也不推断某次页面修改导致了排名变化。它提供的是一个能追溯、能区分失败与未命中的观察基础。需要更长期的判断,再把内容改动、站点指标和连续观测放在一起分析。
先挑几个业务最关心的词跑一周,核对每种状态有没有被正确记录,比第一天做一个漂亮的大屏更重要。SERP API 接管结果获取,你把精力留给关键词和页面本身。
**验证范围:**示例代码完成离线编译检查及域名匹配、命中、空结果、异常结构断言;没有执行真实付费 SERP 请求,没有部署服务器或定时任务。文中没有真实排名或效果数据。