

어제 랜딩 페이지 제목을 바꿨는데, 오늘 운영팀에서 물었다: “그 키워드 올랐나요?” 검색 페이지를 열고 한참 찾다가, 또 지역, 언어 또는 검색 시간이 다른 건 아닌지 의심하기 시작한다. 수동으로 한 번 확인하는 것은 어렵지 않지만, 어려운 것은 매일 같은 기준으로 확인하고, 기록을 남기며, 어떤 날 왜 데이터가 없었는지도 설명할 수 있게 하는 것이다.
직접 검색 페이지를 수집하는 것도 가능하지만, 원래는 순위를 모니터링하려 했는데 결국 페이지 셀렉터, 프록시와 예외 재시도를 유지보수하게 된다. 키워드가 수십 개뿐인 소규모 팀에게는, 더 적합한 시작점은 아마도 이렇다: 검색 결과는 SERP API에 맡기고, 자신은 모니터링 규칙과 이력 기록만 유지한다.

AI 생성 예시이며, 실제 순위 데이터를 나타내지 않습니다.
¶ 먼저 명확히 하자, 정확히 어떤 순위를 모니터링하는가
여기서 하는 것은 “지정된 국가, 언어 및 이번에 반환된 자연 검색 결과에서 목표 도메인이 몇 위에 있는가”이다. 모든 사용자가 보게 되는 유일한 순위도 아니고, 광고 영역, 지도 영역 또는 페이지 전체의 픽셀 위치도 아니다.
AceDataCloud의 Google SERP 인터페이스는 POST https://api.acedata.cloud/serp/google를 사용한다. 자연 검색 결과는 organic에 있으며, 항목에는 link와 position이 포함된다. 요청에서 검색어, 국가, 언어 및 페이지네이션 등의 조건을 지정할 수 있다. 필드는 현재 인터페이스 문서를 기준으로 해야 한다. Google SERP API
이 예제에서는 type=search, country=us, language=en, page=1, number=10을 고정한다. 이렇게 하면 범위가 충분히 작아 검토하기 쉽다. 오늘은 미국 영어로 확인하고, 내일은 영국 영어로 확인한 뒤, 이틀의 값을 하나의 추세선으로 연결하지 마라.
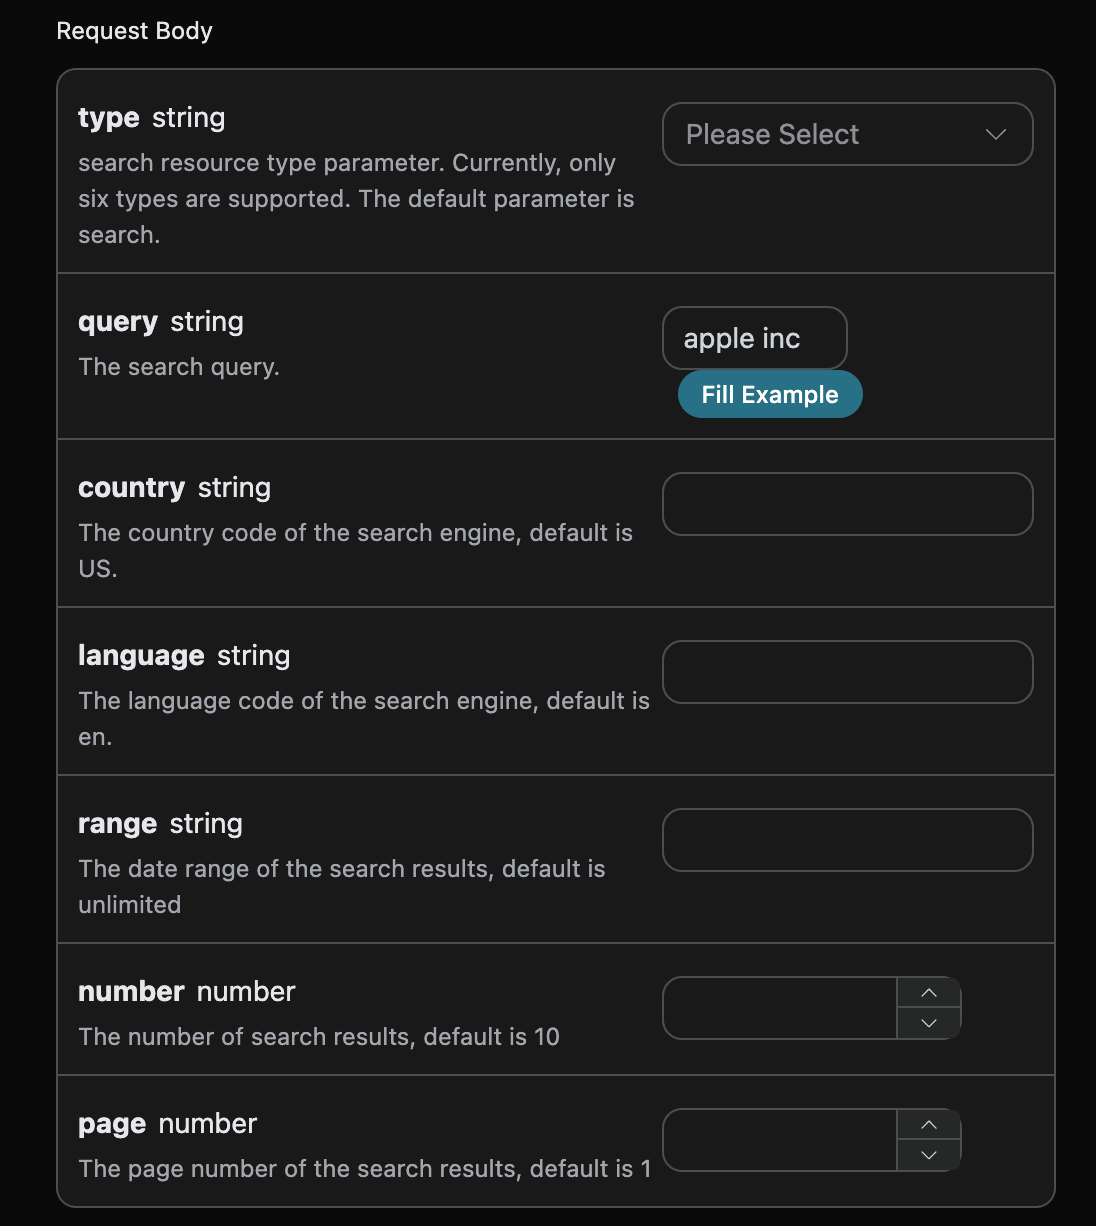
공식 파라미터 양식 스크린샷; 현재 필드는 문서를 기준으로 합니다.
또 특히 쉽게 잘못 처리하는 부분이 있다: 결과가 열 개 반환되었지만 자신의 도메인을 찾지 못했다면, 이를 “인터페이스 실패”로 기록할 수도 없고, 곧바로 11위로 채워 넣을 수도 없다. 당신이 아는 것은 그것이 이번에 반환된 집합에 나타나지 않았다는 것뿐이며, 집합 밖에서 몇 위인지 알 수는 없다.
세 가지 상태를 저장하는 것을 권장한다: found는 찾아서 위치를 기록했음을 나타낸다; not_found_in_response는 인터페이스가 정상적으로 반환되었지만 일치하지 않았음을 나타낸다; error는 요청, 디코딩 또는 구조 검증에 문제가 있었음을 나타낸다. 위치를 알 수 없을 때는 빈값으로 쓰고, 0이나 999를 쓰거나 그것으로 평균 순위를 계산하지 마라.
¶ 하나의 스크립트로 요청과 결과를 남기기
아래의 전체 예제는 Python 3과 requests에 의존하며, Python에 내장된 SQLite를 사용해 결과를 저장한다. 스크립트를 seo_monitor.py로 저장하고, 같은 디렉터리에 keywords.json을 생성한 다음, 자리표시자 도메인을 경로가 포함된 페이지 주소가 아닌 모니터링할 도메인으로 바꾼다:
[
  {"query":"reusable travel tumbler","target":"example.com","country":"us","language":"en"}
]
API Key는 자신의 애플리케이션에서 가져오며, ACEDATACLOUD_API_KEY 환경 변수를 통해 제공한다; JSON, 스크립트 또는 스크린샷에 작성하지 마라. 의존성을 설치한 후 스크립트를 실행한다:
python -m pip install 'requests>=2.31,<3'
python seo_monitor.py
처음 사용할 때는 먼저 하나의 키워드로 실제 연동 테스트를 하고, 그다음 범위를 확대해야 한다.
import json
import os
import sqlite3
from datetime import datetime, timezone
from pathlib import Path
from urllib.parse import urlparse
import requests

ROOT = Path(__file__).resolve().parent

def host(value):
    parsed = urlparse(value if "://" in value else "https://" + value)
    return (parsed.hostname or "").lower().rstrip(".").encode("idna").decode("ascii")

def match(url, target):
    h = host(url)
    return h == target or h.endswith("." + target)

def rank(data, target):
    if not isinstance(data, dict) or data.get("error") or data.get("success") is False:
        raise ValueError("API failure")
    rows = data.get("organic")
    if not isinstance(rows, list):
        raise ValueError("organic missing or invalid")
    hits = []
    for row in rows:
        if not isinstance(row, dict):
            raise ValueError("invalid organic item")
        p, link = row.get("position"), row.get("link")
        if type(p) is not int or p < 1 or not isinstance(link, str):
            raise ValueError("invalid position/link")
        parsed = urlparse(link)
        if parsed.scheme not in ("http", "https") or not parsed.hostname:
            raise ValueError("invalid result URL")
        if match(link, target):
            hits.append((p, link))
    return min(hits) if hits else (None, None)

def main():
    token = os.environ["ACEDATACLOUD_API_KEY"]
    tasks = json.loads((ROOT / "keywords.json").read_text(encoding="utf-8"))
    db = sqlite3.connect(ROOT / "rankings.sqlite3")
    db.execute("""CREATE TABLE IF NOT EXISTS checks (
        checked_at TEXT, keyword TEXT, target TEXT, country TEXT,
        language TEXT, page INTEGER, requested_number INTEGER,
        returned_number INTEGER, status TEXT, position INTEGER,
        landing_url TEXT, error TEXT, raw_json TEXT)""")
    failures = 0
    with requests.Session() as session:
        session.headers.update({"Authorization": "Bearer " + token})
        for task in tasks:
            target = host(task["target"])
            if not target:
                raise ValueError("target must be a domain")
            payload = {"type": "search", "query": task["query"],
                       "country": task["country"], "language": task["language"],
                       "number": 10, "page": 1}
            stamp = datetime.now(timezone.utc).isoformat()
            status, p, link, error, raw, count = "error", None, None, None, None, None
            try:
                r = session.post("https://api.acedata.cloud/serp/google",
                                 json=payload, timeout=(10, 60))
                r.raise_for_status()
                data = r.json()
                raw = json.dumps(data, ensure_ascii=False)
                p, link = rank(data, target)
                count = len(data["organic"])
                status = "found" if p is not None else "not_found_in_response"
            except (requests.RequestException, ValueError) as exc:
                error = type(exc).__name__
                if isinstance(exc, requests.HTTPError) and exc.response is not None:
                    error += ": HTTP " + str(exc.response.status_code)
                failures += 1
            db.execute("INSERT INTO checks VALUES (?,?,?,?,?,?,?,?,?,?,?,?,?)",
                       (stamp, task["query"], target, task["country"], task["language"],
                        1, 10, count, status, p, link, error, raw))
            db.commit()
            print(task["query"], status, p if p is not None else "-")
    db.close()
    raise SystemExit(1 if failures else 0)

if __name__ == "__main__":
    main()
rank 내부에서는 데이터 유형, URL 및 위치 필드를 검사한다. organic이 없는 응답은 예외로 처리한다; 빈 배열은 정상적인 빈 결과다. 도메인 매칭은 문자열 포함 여부를 판단하지 않고 URL의 hostname을 사용한다. 그렇지 않으면 notexample.com도 example.com으로 잘못 인식될 수 있다.
이 예제는 하위 도메인을 포함한다: shop.example.com은 example.com과 일치할 수 있다. 메인 사이트만 관심 있다면 엄격한 동일 비교로 바꿔라; 특정 글 하나에 관심 있다면 경로 정규화 규칙을 추가하라. 기준을 합의하지 않은 채, 사이트 전체에서 가장 좋은 위치를 어떤 페이지의 위치로 간주하지 마라.
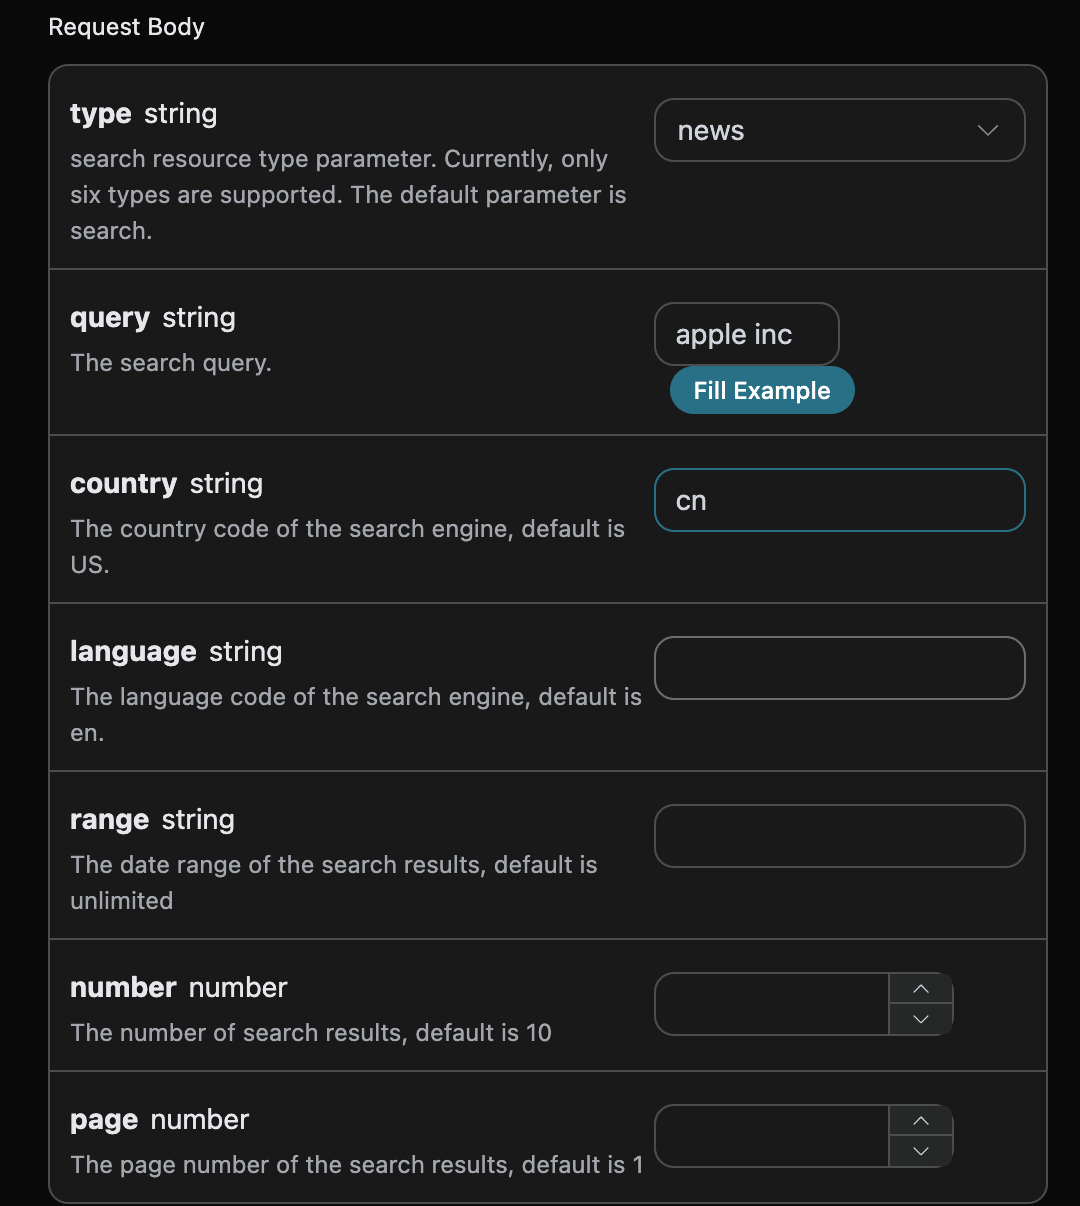
지역, 언어 등의 검색 조건은 모니터링 기록과 함께 저장해야 합니다.
매번 검사할 때마다 시간, 키워드, 도메인, 국가, 언어, 페이지 번호, 요청 수량, 실제 반환 수량, 상태, 위치, 랜딩 페이지, 오류 유형 및 원본 JSON을 기록합니다. 기록에는 UTC 시간을 사용하고, 보고서 표시 시 일괄적으로 현지 시간대로 변환합니다. 원본 응답은 추적이 편리하도록 자체 저장소에 보관하고, 전체 데이터베이스를 직접 공개하지 마세요.
스크립트는 요청 헤더를 출력하지 않습니다. HTTP 예외는 오류 유형과 상태 코드만 기록합니다. 어떤 키워드든 실패하면 프로세스는 최종적으로 0이 아닌 종료 코드를 반환하여 스케줄러가 경고할 수 있도록 합니다. 자동 재시도는 의도적으로 하지 않습니다. 먼저 실패를 확인한 뒤, 서비스 속도 제한 규칙에 따라 상한이 있는 백오프를 추가하는 것이 무한 반복 요청보다 더 제어하기 쉽습니다.
¶ 매일 자동 실행한다고 해서 매일 자동으로 결론이 나는 것은 아닙니다
자신의 상시 운영 서버에서는 cron 또는 기존 작업 스케줄러를 사용해 매일 한 번 트리거할 수 있습니다. 아래는 Linux cron 예시이며, 이미 대신 설정된 작업은 아닙니다:
0 9 * * * /opt/seo/.venv/bin/python /opt/seo/seo_monitor.py >> /opt/seo/run.log 2>&1
실행 시간은 서버의 cron 시간대를 기준으로 해석됩니다. Python 경로와 스크립트 경로는 실제 배포 위치로 바꿔야 하며, 자격 증명은 스케줄링 프로세스의 보호된 환경에서 구성해야 합니다. 대화형 터미널에 환경 변수가 있다고 해서 cron이 자동으로 상속하는 것은 아닙니다. 배포 전에 동일한 실행 사용자로 테스트하고, 로그 권한을 제한하고 로테이션을 구성하며, 작업이 중복되지 않도록 방지하세요.
결과를 볼 때는 먼저 성공률을 보고, 그다음 순위를 보세요. 두 번 모두 적중했고 검색 조건이 같을 때에만 위치 차이를 비교합니다. 어제 8위, 오늘 5위라면 이 두 번의 관측에서 세 단계 상승했다고 말할 수 있습니다. 오늘 적중하지 않았다면 이번 결과에서는 검출되지 않았다고만 말할 수 있습니다. 반환 수량이 갑자기 열 건에서 두 건으로 바뀌었다면, 먼저 반환 집합 변화의 영향을 배제해야 합니다.
여러 페이지를 모니터링해야 할 때는 각 페이지의 원본 결과를 저장하고, 인터페이스 position의 실제 의미를 확인한 뒤 페이지 간 중복 제거를 설계하세요. 검증하지 않은 채 “페이지 번호 곱하기 10”으로 전역 순위를 만들어 내지 마세요. 이 예시는 의도적으로 첫 화면만 조회합니다. 독자에게 겉보기에는 완전하지만 실제 기준은 잘못된 순위표를 제공하지 않기 위해서입니다.
요청 예산은 “키워드 수 × 검색 조건 조합 수 × 페이지 수 × 일일 횟수”로 추산할 수 있습니다. 이는 요청량이며 청구 금액과 직접 같지는 않습니다. 단일 요청 비용, 반환 수량 구간 및 실패 과금 규칙은 여전히 당시 서비스 설명과 사용량 기록을 기준으로 확인해야 합니다.
¶ 실제로 절약되는 것은 검색 페이지를 유지보수하는 시간입니다
이 스크립트는 SEO 개선을 약속하지 않으며, 어떤 페이지 수정이 순위 변화를 유발했다고 추론하지도 않습니다. 제공하는 것은 추적 가능하고 실패와 미검출을 구분할 수 있는 관측 기반입니다. 더 장기적인 판단이 필요하다면 콘텐츠 변경, 사이트 지표 및 연속 관측을 함께 분석하세요.
업무에서 가장 중요하게 여기는 몇 개의 키워드를 먼저 골라 일주일간 실행하고, 각 상태가 올바르게 기록되는지 확인하는 것이 첫날에 보기 좋은 대시보드를 만드는 것보다 더 중요합니다. SERP API가 결과 수집을 맡고, 여러분은 키워드와 페이지 자체에 집중하면 됩니다.
검증 범위: 예제 코드는 오프라인 컴파일 검사와 도메인 일치, 적중, 빈 결과, 예외 구조 단언을 완료했습니다. 실제 유료 SERP 요청을 실행하지 않았으며, 서버나 정기 작업도 배포하지 않았습니다. 본문에는 실제 순위나 효과 데이터가 없습니다.