¶ 一、Почему AI нужно не просто больше текста?
«Это решение не подходит для производственной среды.»
Если видеть только это предложение, AI трудно определить, что именно оно отрицает: технологию, способ развёртывания или вариант реализации при определённых условиях?
Но если добавить предыдущий контекст, смысл может стать гораздо яснее:
Вопрос: Я хочу сделать сервис обмена файлами, можно ли напрямую хранить загруженные файлы внутри контейнера?
Ответ: Для краткосрочной проверки можно, но нужно учитывать сохранность данных после пересоздания контейнера.
Уточняющий вопрос: А если запускать в продакшн?
Дополнение: Тогда нужно дополнительно учитывать постоянное хранение, резервное копирование и масштабирование, нельзя просто продолжать использовать подход этапа прототипирования.
Выше приведён демонстрационный диалог, поясняющий роль контекста, а не исходная запись набора данных.
В этом примере знание, которое действительно стоит извлечь, — это не простое «можно» или «нельзя», а при каких условиях решение применимо и в каких случаях его нужно корректировать.
В этом также заключается уникальная ценность данных обсуждений сообщества: они не только содержат выводы, но и фиксируют фон постановки вопросов, компромиссы между разными решениями, а также процесс дополнения и корректировки взглядов. Чтобы AI лучше использовал контент сообщества, недостаточно просто разбить посты и комментарии на отдельные фрагменты текста — необходимо по возможности сохранять связи между ними.
¶ 二、Знакомство с набором данных Ace Data Cloud Reddit
Набор данных Ace Data Cloud Reddit Posts & Comments (посты и комментарии Reddit) организует контент вокруг форумных постов, комментариев и многоуровневых ответов, сохраняя принадлежность к разделам и родительско-дочерние связи, а также поддерживая выбор диапазона данных по темам обсуждений и условиям содержания.[1]
Он обращает внимание не только на то, «какие есть тексты», но и на следующее:
- К какому разделу обсуждений относится этот контент;
- Какой вопрос был задан в исходном посте;
- Отвечает ли комментарий на пост или на другой комментарий;
- Как последующие ответы дополняют, ставят под сомнение или развивают предыдущие точки зрения.
¶ Масштаб данных и публичный предварительный просмотр
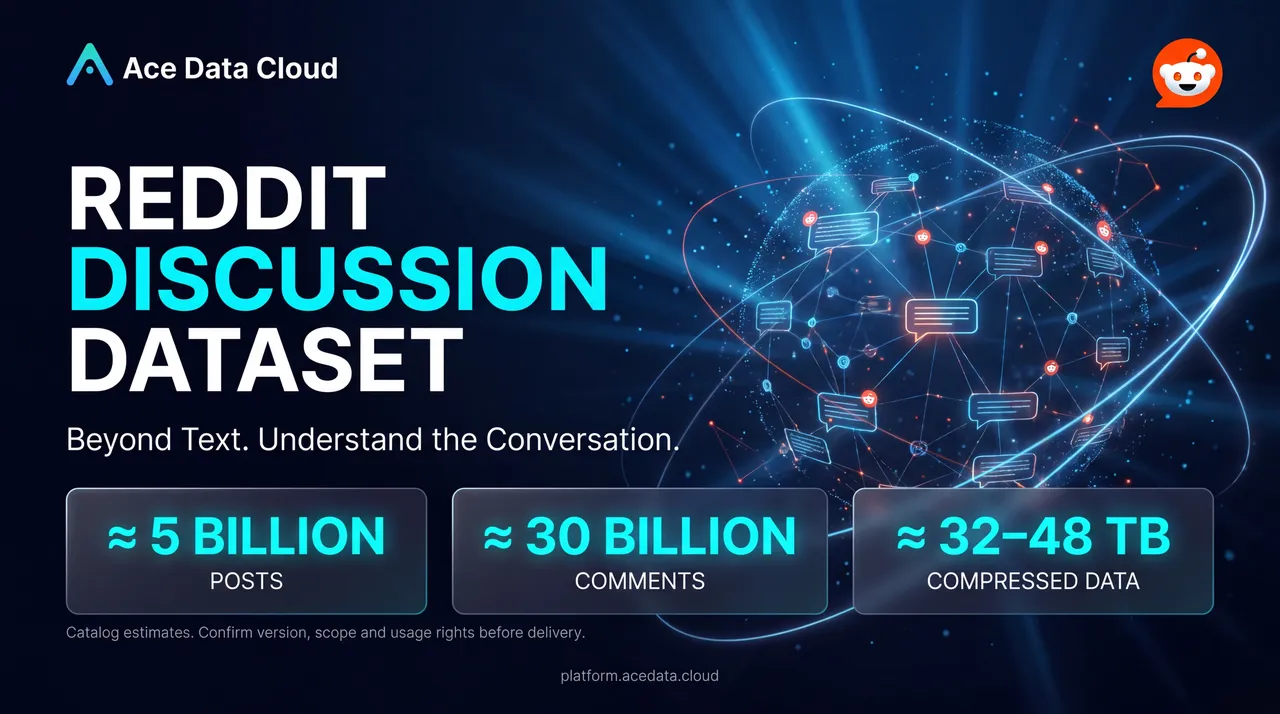
На странице сервиса представлена следующая информация из каталожной регистрации. Эти цифры относятся к масштабу по каталожной методике; фактическое доступное для поставки количество, объём и охват всё ещё необходимо подтверждать для конкретной версии.[1]
| Измерение | Описание в каталоге |
|---|---|
| Масштаб постов | Около 5 миллиардов (5 billion) |
| Масштаб комментариев | Около 30 миллиардов (30 billion) |
| Сжатый объём | Около 32–48 TB |
| Публичный предварительный просмотр | 5 предварительных записей, без фрагментов изображений |
| Сопроводительные материалы | Справочник полей и README на китайском и английском |
| Способ получения | Сначала ознакомиться с образцом, затем подтвердить версию, охват, лицензию и цену |
Для конкретного проекта более важен не вопрос «сколько всего данных», а вопрос: сколько данных, связанных с бизнесом, содержательно полезных, с восстанавливаемыми связями и с лицензией, соответствующей назначению, доступно.
Например, при создании ассистента вопросов и ответов для Web-разработки обычно следует в первую очередь обращать внимание на тематический охват соответствующих разделов и качество ответов, а не напрямую стремиться к максимальному объёму данных.
¶ 三、Структура данных: возвращение текста в контекст обсуждения
Понять этот набор данных можно, начав с трёх уровней: постов, комментариев и связей ответов.

Концептуальная схема: только сохраняя связи обсуждения, можно лучше понимать контекст.
¶ 1. Посты: откуда начинается понимание вопроса
Посты обычно предоставляют тему обсуждения и исходный контекст. Справочник полей публичного пакета примеров перечисляет такие поля, как ID поста, раздел, время, заголовок, основной текст, метки и исходная ссылка.[2]
| Поле | Значение | Прикладная ценность |
|---|---|---|
post.id |
Идентификатор поста | Удаление дубликатов, индексация и связывание комментариев |
post.channel |
Принадлежащий раздел | Определение предметной области и границ сообщества |
post.title |
Заголовок поста | Распознавание вопросов и тематический поиск |
post.text |
Основной текст поста | Извлечение требований, контекста и ограничений |
post.timestamp |
Время публикации поста | Фильтрация по времени и анализ тенденций |
post.flair |
Метка поста | Вспомогательная классификация и фильтрация контента |
Например, «как хранить статьи блога» — это лишь обобщение вопроса; именно упомянутые в основном тексте технологический стек, способ редактирования и требования к отображению могут определить, какие рекомендации действительно применимы.
¶ 2. Комментарии: наблюдение за ответами, опытом и разногласиями
Комментарии не всегда являются прямыми ответами; они также могут быть уточняющими вопросами, исправлениями, контрпримерами или дополнениями из опыта. Объект комментария в справочнике полей содержит такую информацию, как ID, основной текст, раздел, время и идентификатор родительского объекта. Время комментариев сохраняется в виде числового текста, тогда как время постов обозначено как секунды Unix; при обработке их следует отдельно проверять и приводить к единому формату.[2]
На прикладном уровне необходимо дополнительно различать: какие комментарии напрямую отвечают на вопрос, какие рекомендации действуют только при определённых условиях, какой контент исправляет предыдущие ошибки и какая информация имеет низкую ценность или уже ушла от темы. Такие суждения обычно требуют сочетания правил, моделей и ручной проверки и не могут быть сделаны только на основе количества комментариев.
¶ 3. Родительско-дочерние связи: определение того, «кто кому отвечает»
comments[].parent используется для записи ID родительского поста или комментария и сохраняет префиксы t1_ и t3_. Это предоставляет основу для связывания при восстановлении отношений ответов, однако полноту связей в конкретной версии всё ещё необходимо проверять на образцах.[2]
Для AI-приложений это означает, что можно пытаться перейти от «поиска независимых комментариев» к «поиску цепочек ответов с контекстом».
Следует учитывать, что справочник полей не равен фактическому списку поставки каждой версии. В описании образца указано, что объект поста может быть пустым, основной текст может отсутствовать или содержать отметку об удалении, а столбцы публичного предварительного просмотра не полностью совпадают с исходными полями.[2]
¶ 四、От обсуждений сообщества к AI-приложениям: шесть направлений, которые стоит исследовать
Представленные ниже направления применения предложены на основе структуры данных и относятся к идеям реализации; это не означает, что сервис данных уже включает соответствующие модели или прикладные системы. Перед фактическим внедрением необходимо сначала подтвердить качество данных, охват и лицензию на использование.

¶ Сценарий первый: дополнение базы знаний RAG опытом сообщества
Официальная документация хорошо объясняет функции и спецификации, а обсуждения в сообществе могут дополнить её проблемами и компромиссами из реального использования: почему определённое решение не подходит в конкретной среде, как выбирать инструменты при разных ограничениях и какие контрпримеры и дополнительные условия существуют для той или иной рекомендации.
При построении системы генерации с дополненным поиском (RAG) можно объединять заголовок поста + контекст вопроса + связанные комментарии + необходимые вышестоящие ответы в единицу поиска.
Например, если пользователь спрашивает: «Следует ли для личного блога использовать базу данных или файлы Markdown?», система не должна возвращать только название инструмента, а должна находить обсуждения, связанные с такими условиями, как частота редактирования, совместная работа нескольких человек и способ развёртывания, а затем формировать ответ.
Подходящие проекты: помощники для разработчиков, инструменты выбора технологий, системы вопросов и ответов по специализированным знаниям.
Ключевая рекомендация: отображайте опыт сообщества отдельно от авторитетных материалов; при ответах, связанных с версиями, производительностью или безопасностью, следует проводить дополнительную проверку.
¶ Сценарий второй: преобразование длинных обсуждений в многопозиционные резюме
В одном длинном обсуждении могут одновременно присутствовать поддерживающие мнения, аргументы против, дополнительные условия и нерешённые вопросы. Обычное резюме при чрезмерном сжатии легко может представить спорное содержание как единый вывод.
Сохраняя связи между ответами, можно структурировать резюме вокруг следующей схемы:
- Исходный вопрос и известные ограничения;
- Основные варианты решений;
- Аргументы в поддержку разных решений;
- Возражения и границы применимости;
- Вопросы, которые всё ещё требуют проверки.
На примере вопроса «Стоит ли самостоятельно развёртывать файловое хранилище» цель резюме состоит не в простом выводе «следует» или «не следует», а в объяснении: какие различия необходимо учитывать при разных условиях, таких как проверка прототипа, личный проект и полноценный сервис.
Подходящие проекты: помощники для чтения сообществ, краткие отчёты по техническим исследованиям, инструменты обобщения обсуждений.
Ключевая рекомендация: сохраняйте разногласия во взглядах и оставляйте отслеживаемую содержательную основу для важных выводов.
¶ Сценарий третий: выявление сигналов продуктовых потребностей из вопросов пользователей
Продуктовые потребности часто не появляются в виде формальных документов с требованиями, а скрываются в сомнениях и жалобах пользователей: «Есть ли более простой способ?», «Почему обязательно нужно зависеть от этого сервиса?», «Я просто делаю небольшой проект — действительно ли нужна такая сложность?»
В публичном предварительном просмотре пост «Как хранить статьи блога» затрагивает такие вопросы, как база данных, Markdown и способ отображения статей.[1]
Продуктовая команда может на этой основе сформировать гипотезы, требующие проверки: пользователям может не хватать полного процесса от написания до публикации, они могут не понимать границы применимости баз данных и управления файлами, а также могут хотеть снизить стоимость настройки управления контентом. Далее это проверяется через большее число аналогичных обсуждений, интервью или продуктовые данные.
Подходящие проекты: исследование потребностей в инструментах для разработчиков, системах управления контентом, облачных сервисах и специализированном программном обеспечении.
Ключевая рекомендация: рассматривайте обсуждения в сообществе как материал для качественных исследований; не переносите выводы из небольшого числа постов напрямую на долю потребностей всего рынка.
¶ Сценарий четвёртый: исследование изменений технических тем и интересов сообщества
При условии непрерывного временного диапазона и сопоставимых критериев сбора можно наблюдать, смещаются ли обсуждения от «что это такое» к «как это развернуть», чем отличаются трудности, на которых сосредоточены сообщества новичков и профессиональные сообщества, а также каким условиям пользователи при сравнении альтернативных решений придают всё большее значение.
Подходящие проекты: исследования технологических трендов, управление сообществами, планирование контента для разработчиков.
Ключевая рекомендация: увеличение числа постов не обязательно означает рост общего интереса; оно также может быть вызвано изменениями охвата или правил фильтрации. Выводы о трендах должны основываться на сопоставимых данных.
¶ Сценарий пятый: создание оценки ИИ, более близкой к реальным обсуждениям
Контент сообществ включает короткие ответы, неоднозначные ссылки, исправления предыдущего текста и разногласия во мнениях, поэтому он подходит для разработки задач на понимание контекста. После получения соответствующих разрешений и выполнения разметки можно исследовать:
| Задача оценки | Проверяемая способность |
|---|---|
| Оценка релевантности ответа | Действительно ли комментарий отвечает на вопрос |
| Распознавание функции комментария | Различение ответа, уточняющего вопроса, исправления и возражения |
| Понимание контекста | Понимание того, к чему относятся «этот метод» и «предыдущее решение» |
| Многопозиционное резюме | Сохранение разных позиций и условий их применимости |
| Оценка поиска | Нахождение фрагментов обсуждения, достаточных для обоснования ответа |
Подходящие проекты: оценка систем вопросов и ответов, оценка моделей резюмирования, исследования понимания обсуждений.
Ключевая рекомендация: исходные комментарии не являются готовыми эталонными ответами. Необходимо проверять факты, разрабатывать правила разметки и избегать утечки информации из-за разделения одного и того же обсуждения между обучающим и тестовым наборами.
¶ Сценарий шестой: выявление повторяющихся вопросов и проблем качества контента
Для управления сообществами и исследований модерации контента можно проводить кластеризацию похожих вопросов, выявлять повторяющиеся запросы, распознавать отклонения от темы и комментарии с низкой информационной ценностью, классифицировать рекламу и флуд, а также составлять каталог часто задаваемых вопросов.
Когда в нескольких постах неоднократно спрашивают об одном и том же типе проблем с настройкой, их можно оформить как сигналы для FAQ, помогая команде выявить отсутствующие в документации объяснения.
Подходящие проекты: управление знаниями сообщества, оптимизация документации, исследования качества контента.
Ключевая рекомендация: в первую очередь используйте анализ на уровне контента и агрегированных данных, избегая ненужного профилирования пользователей; удаление имён пользователей ещё не означает, что основной текст был анонимизирован.
¶ V. Как выбрать данные, которые действительно подходят проекту?
При работе с крупномасштабными данными наиболее эффективной отправной точкой часто является чёткое определение границ, а не расширение охвата. На странице сервиса перечислены такие способы выбора диапазона, как фильтрация по разделам, исключение NSFW и недоступного контента, а также фильтрация по числу комментариев к постам; конкретные правила и результаты необходимо проверять по пакетам.[1]
¶ 1. Сначала выберите тему, затем смотрите на масштаб
Если цель — технические вопросы и ответы, следует сначала проверить соответствующие разделы и типы вопросов; если цель — исследование продукта, то следует в первую очередь искать контент, содержащий контекст использования, конкретные трудности и альтернативные решения. Не следует по умолчанию считать, что какой-либо поднабор подходит для текущей задачи только потому, что он велик по объёму.
¶ 2. Сначала смотрите на полезный контент, затем — на количество взаимодействий
Большое число комментариев может означать богатство информации, а может указывать на ожесточённые споры или большое количество сообщений не по теме. В текущем справочнике полей не указаны оценки лайков, просмотры или отметки «лучший ответ», поэтому нельзя по умолчанию предполагать, что высококачественный контент можно отбирать по этим показателям.[2]
Более надёжный подход — оценивать качество, сочетая релевантность, полноту информации, источник и ручную выборочную проверку.
¶ 3. Сначала проверяйте связи, затем создавайте контекстные приложения
Если проект зависит от дерева обсуждений, следует особенно проверять, можно ли найти родительские посты или комментарии, не прерывается ли цепочка ответов, влияет ли удалённый контент на понимание, доступен ли временной порядок и остаётся ли контекст достаточным после удаления идентифицирующей информации.
«Наличие родительского поля» и «возможность полностью восстановить обсуждение» — это две разные цели приёмки.
¶ VI. От выборки к приложению: выполнимый путь внедрения
¶ Шаг первый: опишите бизнес-цель одним предложением
Например: «Создать помощника по поиску для вопросов веб-разработки, сохраняя исходные вопросы и связанные ответы, поддерживая фильтрацию по разделам и времени, а также предоставляя отслеживаемые основания в ответах».
По сравнению с формулировкой «нужен набор данных Reddit», такое описание легче позволяет сформировать чёткие рамки данных и критерии приёмки.
¶ Шаг второй: изучите публичную выборку, затем запросите репрезентативную проверочную выборку
Публичный пакет примеров предоставляет 5 предварительных записей, а также JSON, CSV, справочник полей и README, что позволяет первоначально понять форму данных, но недостаточно для оценки общего качества.[2]
Скачать публичный пакет примеров набора данных Reddit
После перехода к формальной проверке рекомендуется проверить отсутствие полей, дублирующийся контент, долю полезного основного текста, успешность связывания ответов и охват целевых тем.
¶ Шаг третий: создайте процесс очистки и обработки контекста
Примерный инженерный процесс может выглядеть так:
Подключение данных → Проверка полей → Удаление дубликатов и фильтрация → Обработка конфиденциальности → Восстановление связей ответов → Организация данных для задачи → Индексация или анализ → Оценка качества
Для разных задач можно использовать разные способы организации: RAG организует единицы поиска по вопросам и связанным цепочкам ответов; суммаризация сохраняет основные ветви и контролирует длину контекста; исследование требований агрегирует похожие вопросы и ограничения использования; оценка моделей делит данные по полным обсуждениям и добавляет ручную разметку.
Это рекомендация по реализации со стороны приложения, а не процесс поставки, включённый в сервис по умолчанию.
¶ Шаг четвёртый: проверяйте с помощью бизнес-показателей, а не только подсчитывайте количество импортированных данных
| Направление применения | Рекомендуемые показатели |
|---|---|
| Поиск знаний | Нахождение релевантного контента, достаточность доказательств, отслеживаемость ответов |
| Суммаризация обсуждений | Охват точек зрения, согласованность фактов, сохранение разногласий |
| Исследование продукта | Полезные сигналы о потребностях, прохождение ручной проверки |
| Анализ структуры обсуждений | Успешность связей «родитель—потомок», доля полезных цепочек ответов |
| Оценка моделей | Согласованность разметки, разнообразие выборки, проверка утечек |
Только когда данные улучшают результаты реальных задач, масштаб действительно превращается в ценность.
¶ VII. Перед использованием подтвердите границы данных и прав
Доступность данных не означает, что их можно использовать для любых целей.
Страница сервиса ясно указывает: отображение в каталоге и доступ к публичному предварительному просмотру не предоставляют права на обучение моделей на полном объёме данных, коммерческое использование или повторное распространение; источники, лицензии и разрешённые способы использования выбранной версии должны быть подтверждены до поставки.[1]
Рекомендуется до запуска проекта чётко определить:
- Охват версии: какие разделы, временные периоды и языки охватываются;
- Содержание поставки: количество записей, фактические поля, формат и способ сжатия;
- Критерии качества: как определяются полезные записи, недействительный контент и полные обсуждения;
- Обработка конфиденциальности: как обрабатываются имена пользователей, персональная информация в основном тексте и удалённый контент;
- Разрешённые способы использования: допускаются ли внутренний анализ, демонстрация поиска, обучение и коммерческое применение;
- Механизм сопровождения: предоставляются ли обновления и как синхронизируются удаления и исправления.
В то же время эта страница относится к каталогу данных и консультациям по требованиям, и на её основании не следует предполагать наличие Reddit API в реальном времени или подписки на непрерывные обновления.[2]
¶ Заключение: пусть ИИ понимает не только точки зрения, но и связи между ними
Ценность обсуждений в сообществе заключается не только в том, что сказали пользователи, но и в том, почему они задали вопрос, при каких условиях приняли определённое решение и как постепенно прояснялся ответ через уточняющие вопросы и возражения.
Для приложений ИИ сохранение этих связей помогает преобразовать изолированный текст в информационную основу с более богатым контекстом. Набор данных Ace Data Cloud Reddit предоставляет точку входа для изучения таких приложений.
Независимо от того, является ли целью поиск знаний, суммаризация обсуждений, исследование потребностей пользователей или оценка моделей, рекомендуется следовать одному и тому же пути: сначала определить задачу, затем проверить выборку; сначала подтвердить качество и лицензию, затем расширять масштаб применения.
Научить ИИ понимать обсуждение — это не просто дать ему прочитать больше текста, а дать ему более точно понять: на что отвечает конкретный ответ и при каких условиях обоснована конкретная точка зрения.
¶ Начните изучение
- Посмотреть описание набора данных Reddit
- Связаться с Ace Data Cloud, чтобы обсудить охват данных и потребности использования
¶ Источники
[1] Описание сервиса набора данных Ace Data Cloud Reddit。
[2] Публичный пакет примеров набора данных Reddit, включая справочник полей, предварительные данные и README.
Описание иллюстраций: обложка и иллюстрации в тексте представляют собой концептуальные дизайны, сгенерированные ИИ, и не являются фактическими снимками данных или интерфейсами уже поставленных продуктов. Число масштаба на обложке является оценкой, зарегистрированной в каталоге; конкретная версия, объём поставки и лицензия на использование требуют подтверждения. Логотип Reddit используется для обозначения объекта обсуждения в этой статье и не означает сотрудничества или одобрения.