
¶ I. Por que a IA precisa de mais do que apenas texto?
“Esta solução não é adequada para ambiente de produção.”
Se vir apenas esta frase, é difícil para a IA determinar exatamente o que ela está negando: uma tecnologia, uma forma de implantação ou uma solução de implementação sob determinadas condições?
Mas, se o contexto anterior for acrescentado, o significado pode se tornar muito mais claro:
Pergunta: Quero criar um serviço de compartilhamento de arquivos. Posso armazenar diretamente os arquivos enviados dentro do contêiner?
Resposta: Para validação de curto prazo, sim, mas é preciso considerar a retenção de dados após a recriação do contêiner.
Pergunta complementar: E se for para entrar oficialmente em produção?
Complemento: Então é necessário considerar ainda mais a persistência, os backups e a expansão, não sendo possível apenas manter a abordagem da fase de protótipo.
O acima é um diálogo ilustrativo que demonstra a função do contexto, e não um registro original do conjunto de dados.
Neste exemplo, o conhecimento realmente digno de extração não é simplesmente “pode” ou “não pode”, mas sim em que condições a solução é válida e em quais situações ela precisa ser ajustada.
Este também é o valor único dos dados de discussões da comunidade: eles não apenas carregam conclusões, mas também registram o contexto em que as perguntas foram feitas, as escolhas entre diferentes soluções e o processo pelo qual opiniões foram complementadas e corrigidas. Para que a IA utilize melhor o conteúdo da comunidade, não basta apenas dividir posts e comentários em segmentos de texto; também é necessário preservar, tanto quanto possível, as relações entre eles.
¶ II. Conhecendo o conjunto de dados Reddit da Ace Data Cloud
O conjunto de dados Reddit Posts & Comments (Posts e Comentários do Reddit) da Ace Data Cloud organiza o conteúdo em torno de posts de fóruns, comentários e respostas em múltiplos níveis, preserva as comunidades às quais pertencem e as relações de pai e filho, e permite selecionar o escopo dos dados por tema de discussão e condições de conteúdo.[1]
Ele se concentra não apenas em “quais textos existem”, mas também em:
- A qual comunidade de discussão este conteúdo pertence;
- Que pergunta o post original apresentou;
- Se o comentário responde ao post ou a outro comentário;
- Como as respostas subsequentes complementam, questionam ou estendem os pontos de vista anteriores.
¶ Escala dos dados e prévia pública
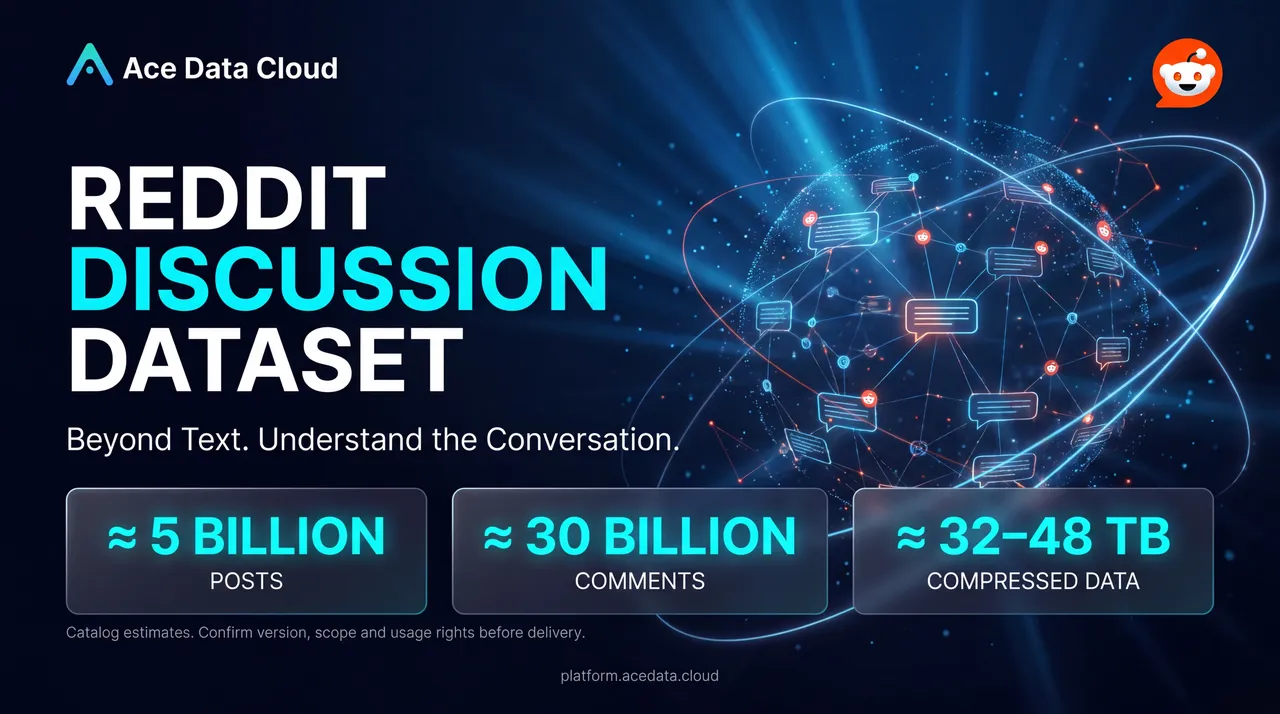
As informações de catálogo exibidas na página do serviço são as seguintes. Esses números pertencem ao critério de escala do catálogo; a quantidade, o volume e o escopo efetivamente entregáveis ainda devem ser confirmados de acordo com a versão específica.[1]
| Dimensão | Descrição do catálogo |
|---|---|
| Escala de posts | Aproximadamente 5 bilhões (5 billion) |
| Escala de comentários | Aproximadamente 30 bilhões (30 billion) |
| Volume compactado | Aproximadamente 32–48 TB |
| Prévia pública | 5 registros de prévia, sem trechos de imagens |
| Materiais complementares | Referência de campos e README em chinês e inglês |
| Forma de obtenção | Primeiro visualizar a amostra, depois confirmar versão, escopo, licença e cotação |
Para projetos específicos, a questão mais importante não é “quantos dados há no total”, mas sim: quantos dados relacionados ao negócio, com conteúdo válido, relações restauráveis e autorização compatível com o uso existem.
Por exemplo, ao construir um assistente de perguntas e respostas voltado ao desenvolvimento Web, normalmente deve-se priorizar a cobertura temática e a qualidade das respostas nas comunidades relevantes, em vez de buscar diretamente o maior volume de dados.
¶ III. Estrutura dos dados: recolocando o texto no contexto da discussão
Para entender este conjunto de dados, pode-se começar por três níveis: posts, comentários e relações de resposta.

Diagrama conceitual: somente preservando as relações de discussão é possível compreender melhor o contexto.
¶ 1. Posts: entendendo onde a pergunta começa
Os posts normalmente fornecem o tema da discussão e o contexto inicial. A referência de campos do pacote de amostra público lista campos como ID do post, comunidade, horário, título, texto principal, tags e link original.[2]
| Campo | Significado | Valor de aplicação |
|---|---|---|
post.id |
Identificador do post | Deduplicação, indexação e associação de comentários |
post.channel |
Comunidade à qual pertence | Delimitação do domínio e do escopo da comunidade |
post.title |
Título do post | Identificação de perguntas e busca por temas |
post.text |
Texto principal do post | Extração de necessidades, contexto e restrições |
post.timestamp |
Horário do post | Filtragem temporal e análise de tendências |
post.flair |
Tag do post | Classificação auxiliar e filtragem de conteúdo |
Por exemplo, “como armazenar artigos de blog” é apenas um resumo da pergunta; a pilha tecnológica, a forma de edição e as necessidades de apresentação mencionadas no texto principal podem ser o que determina quais sugestões realmente são aplicáveis.
¶ 2. Comentários: observando respostas, experiências e divergências
Os comentários não são necessariamente respostas diretas; também podem ser perguntas complementares, correções, contraexemplos ou complementos de experiência. O objeto de comentários na referência de campos contém informações como ID, texto principal, comunidade, horário e identificador de nível pai. O horário dos comentários é armazenado como texto numérico, enquanto o horário dos posts é indicado como segundos Unix; durante o processamento, eles devem ser verificados separadamente e unificados em um mesmo formato.[2]
No nível da aplicação, é necessário distinguir ainda mais: quais comentários respondem diretamente à pergunta, quais sugestões são válidas apenas sob condições específicas, quais conteúdos corrigem erros anteriores e quais têm pouca informação ou já se desviaram do assunto. Esse tipo de julgamento normalmente exige a combinação de regras, modelos e revisão humana, não podendo ser concluído apenas pela quantidade de comentários.
¶ 3. Relações de pai e filho: identificando “quem está respondendo a quem”
comments[].parent é usado para registrar o ID do post ou comentário pai e preserva os prefixos t1_ e t3_. Ele fornece uma base de associação para restaurar relações de resposta, mas a integridade específica das associações em cada versão ainda precisa ser validada por meio de amostras.[2]
Para aplicações de IA, isso significa que se pode tentar avançar da “recuperação de comentários independentes” para a “recuperação de cadeias de respostas com contexto”.
É importante observar que a referência de campos não equivale à lista efetiva de entrega de cada versão. As instruções da amostra indicam que o objeto de post pode estar vazio, o texto principal pode estar ausente ou conter marcas de exclusão, e as colunas da prévia pública não são totalmente iguais aos campos originais.[2]
¶ IV. Das discussões da comunidade às aplicações de IA: seis cenários que valem a pena explorar
As direções de aplicação a seguir são propostas com base na estrutura dos dados e constituem ideias de implementação; elas não significam que o serviço de dados já inclua os modelos ou sistemas de aplicação correspondentes. A implementação prática exige primeiro confirmar a qualidade dos dados, o escopo de cobertura e a licença de uso.

¶ Cenário um: complementar a experiência da comunidade para a base de conhecimento RAG
A documentação oficial é boa para explicar funcionalidades e normas, enquanto as discussões da comunidade podem complementar problemas e escolhas no uso real: por que uma determinada solução não é aplicável em um ambiente específico, como escolher ferramentas diante de diferentes restrições e quais contraexemplos e condições adicionais uma recomendação possui.
Ao construir um sistema de geração aumentada por recuperação (RAG), é possível combinar título da publicação + contexto da pergunta + comentários relacionados + respostas superiores necessárias como unidade de recuperação.
Por exemplo, se um usuário perguntar “um blog pessoal deve usar banco de dados ou arquivos Markdown”, o sistema não deve retornar apenas o nome de uma ferramenta, mas recuperar discussões relacionadas a condições como frequência de edição, colaboração entre várias pessoas e forma de implantação, e então organizar a resposta.
Projetos adequados: assistentes para desenvolvedores, ferramentas de seleção técnica, sistemas verticais de perguntas e respostas sobre conhecimento.
Recomendação principal: exibir separadamente a experiência da comunidade e materiais autoritativos; quando a resposta envolver versões, desempenho ou segurança, deve-se verificar mais a fundo.
¶ Cenário dois: organizar discussões longas em resumos de múltiplos pontos de vista
Em uma discussão longa, podem coexistir opiniões favoráveis, razões contrárias, condições adicionais e questões não resolvidas. Se um resumo comum for excessivamente comprimido, é fácil transformar conteúdo controverso em uma conclusão consensual.
Após preservar as relações entre respostas, é possível organizar o resumo em torno da seguinte estrutura:
- A pergunta original e as restrições conhecidas;
- As principais soluções candidatas;
- As razões de apoio às diferentes soluções;
- As opiniões contrárias e os limites de aplicação;
- As questões que ainda precisam ser verificadas.
Tomando como exemplo “se deve construir armazenamento de arquivos próprio”, o objetivo do resumo não é simplesmente produzir “deve” ou “não deve”, mas explicar: em diferentes condições, como validação de protótipo, projetos pessoais e serviços formais, quais diferenças precisam ser consideradas.
Projetos adequados: assistentes de leitura de comunidades, boletins de pesquisa técnica, ferramentas de síntese de discussões.
Recomendação principal: preservar as divergências de opinião e manter uma base de conteúdo rastreável para conclusões importantes.
¶ Cenário três: descobrir indícios de necessidades de produto a partir das perguntas dos usuários
As necessidades de produto muitas vezes não aparecem em documentos de requisitos padronizados, mas ficam escondidas nas dúvidas e reclamações dos usuários: “Existe uma forma mais simples?” “Por que é obrigatório depender deste serviço?” “Estou apenas fazendo um pequeno projeto, preciso de algo tão complexo?”
Na prévia pública, a publicação “como armazenar artigos de blog” envolve questões como banco de dados, Markdown e formas de exibição dos artigos.[1]
As equipes de produto podem, com base nisso, formular hipóteses a serem verificadas: os usuários podem não ter um fluxo completo da escrita à publicação, podem não compreender os limites de aplicação entre bancos de dados e gerenciamento de arquivos e também podem desejar reduzir o custo de configuração do gerenciamento de conteúdo. Em seguida, validar por meio de mais discussões semelhantes, entrevistas ou dados de produto.
Projetos adequados: pesquisa de necessidades para ferramentas de desenvolvedores, sistemas de gerenciamento de conteúdo, serviços em nuvem e software vertical.
Recomendação principal: tratar discussões da comunidade como material de pesquisa qualitativa; não extrapolar diretamente algumas poucas publicações como a proporção de necessidades de todo o mercado.
¶ Cenário quatro: estudar mudanças em temas técnicos e pontos de atenção da comunidade
Sob a premissa de continuidade do intervalo de tempo e comparabilidade dos critérios de coleta, é possível observar se as discussões passam de “o que é isto” para “como implantar”, quais dificuldades recebem atenção diferente em comunidades de iniciantes e comunidades profissionais e quais condições os usuários valorizam cada vez mais ao comparar soluções alternativas.
Projetos adequados: pesquisa de tendências tecnológicas, operação de comunidades, planejamento de conteúdo para desenvolvedores.
Recomendação principal: o aumento no número de publicações não significa necessariamente um aumento no nível geral de atenção; ele também pode resultar de mudanças no escopo de cobertura ou nas regras de filtragem. As conclusões sobre tendências devem se basear em dados comparáveis.
¶ Cenário cinco: construir avaliações de IA mais próximas de discussões reais
O conteúdo da comunidade inclui respostas curtas, referências ambíguas, correções do texto anterior e divergências de opinião, sendo adequado para projetar tarefas de compreensão de contexto. Após obter as permissões correspondentes e concluir a anotação, é possível estudar:
| Tarefa de avaliação | Capacidade a ser testada |
|---|---|
| Julgamento de relevância da resposta | Se o comentário realmente responde à pergunta |
| Identificação da função do comentário | Distinguir resposta, pergunta complementar, correção e refutação |
| Compreensão de contexto | Compreender a que se referem “este método” e “a solução anterior” |
| Resumo de múltiplos pontos de vista | Preservar diferentes posições e suas condições de aplicação |
| Avaliação de recuperação | Recuperar trechos de discussão suficientes para sustentar a resposta |
Projetos adequados: avaliação de sistemas de perguntas e respostas, avaliação de modelos de resumo, pesquisa sobre compreensão de discussões.
Recomendação principal: comentários originais não são respostas padrão por natureza. É necessário verificar fatos, definir normas de anotação e evitar vazamento de informações causado pela divisão da mesma discussão entre o conjunto de treinamento e o conjunto de teste.
¶ Cenário seis: identificar perguntas repetidas e problemas de qualidade de conteúdo
Para operação de comunidades e pesquisa sobre governança de conteúdo, é possível realizar agrupamento de perguntas semelhantes, descoberta de perguntas repetidas, identificação de comentários fora de tópico e de baixo conteúdo informativo, classificação de publicidade e spam, bem como organização de catálogos de perguntas frequentes.
Quando várias publicações perguntam repetidamente sobre o mesmo tipo de problema de configuração, elas podem ser organizadas como indícios de FAQ, ajudando a equipe a descobrir explicações ausentes na documentação.
Projetos adequados: gerenciamento de conhecimento da comunidade, otimização de documentação, pesquisa sobre qualidade de conteúdo.
Recomendação principal: priorizar análises no nível do conteúdo e em nível agregado, evitando perfis pessoais desnecessários; remover nomes de usuário também não significa que o corpo do texto já tenha sido anonimizado.
¶ V. Como escolher dados realmente adequados ao projeto?
Diante de dados em grande escala, o ponto de partida mais eficaz costuma ser definir claramente os limites, e não ampliar o escopo. A página do serviço lista formas de seleção de escopo, como filtrar por seção, excluir conteúdo NSFW e inválido e filtrar pelo número de comentários das publicações; as regras e os efeitos específicos precisam ser verificados por lote.[1]
¶ 1. Primeiro escolha o tema, depois observe a escala
Se o objetivo for perguntas e respostas técnicas, deve-se primeiro verificar as seções relevantes e os tipos de perguntas; se o objetivo for pesquisa de produto, deve-se priorizar a busca por conteúdo que inclua contexto de uso, dificuldades específicas e soluções alternativas. Não presuma que um subconjunto é adequado para a tarefa atual apenas porque possui uma grande quantidade de dados.
¶ 2. Primeiro observe o conteúdo válido, depois a quantidade de interações
Um alto volume de comentários pode significar informações abundantes, mas também pode significar debates intensos ou grande quantidade de conteúdo fora do tópico. A referência atual de campos não lista pontuações de votos positivos, visualizações ou marcadores de “melhor resposta”, portanto não se pode presumir que seja possível filtrar conteúdo de alta qualidade com base nesses indicadores.[2]
Uma abordagem mais segura é avaliar a qualidade combinando relevância, completude das informações, fonte e verificação manual por amostragem.
¶ 3. Primeiro valide as relações, depois construa aplicações com contexto
Se o projeto depender de árvores de discussão, deve-se verificar com atenção se é possível encontrar postagens ou comentários de nível superior, se a cadeia de respostas está interrompida, se conteúdo excluído afeta a compreensão, se a ordem cronológica está disponível e se o contexto continua suficiente após a remoção de informações de identidade.
“Existir um campo de nível superior” e “ser possível restaurar integralmente uma discussão” são dois objetivos de aceitação diferentes.
¶ VI. Da amostra à aplicação: um caminho de implementação executável
¶ Primeiro passo: descreva o objetivo de negócio em uma frase
Por exemplo: “Construir um assistente de recuperação para problemas de desenvolvimento Web, preservando as perguntas originais e as respostas relacionadas, com suporte a filtragem por seção e período, e fornecendo evidências rastreáveis nas respostas.”
Em comparação com “precisamos de um lote de dados do Reddit”, essa descrição facilita a definição de um escopo de dados e de critérios de aceitação claros.
¶ Segundo passo: examine amostras públicas e, em seguida, solicite amostras de validação representativas
O pacote público de exemplos fornece 5 registros de visualização, além de JSON, CSV, referência de campos e README, que podem ser usados para uma compreensão inicial do formato dos dados, mas não são suficientes para avaliar a qualidade geral.[2]
Baixar o pacote público de exemplos do conjunto de dados do Reddit
Após entrar na validação formal, recomenda-se verificar campos ausentes, conteúdo duplicado, proporção de textos válidos, taxa de sucesso na associação de respostas e cobertura dos temas-alvo.
¶ Terceiro passo: estabelecer um fluxo de limpeza e processamento de contexto
Um fluxo de engenharia de referência é:
Integração de dados → Validação de campos → Deduplicação e filtragem → Processamento de privacidade → Reconstrução das relações de resposta → Organização dos dados da tarefa → Indexação ou análise → Avaliação de qualidade
Diferentes tarefas podem adotar diferentes formas de organização: RAG organiza as unidades de recuperação por pergunta e cadeias de respostas relacionadas; resumos preservam os principais ramos e controlam o comprimento do contexto; pesquisa de requisitos agrega problemas semelhantes e restrições de uso; avaliação de modelos divide os dados por discussões completas e adiciona anotação manual.
Esta é uma recomendação de implementação no lado da aplicação, e não um fluxo de entrega incluído por padrão no serviço.
¶ Quarto passo: valide com métricas de negócio, em vez de apenas contar a quantidade importada
| Direção da aplicação | Métricas recomendadas a acompanhar |
|---|---|
| Recuperação de conhecimento | Recuperação de conteúdo relevante, suficiência das evidências, rastreabilidade das respostas |
| Resumo de discussões | Cobertura de pontos de vista, consistência factual, preservação de controvérsias |
| Pesquisa de produto | Sinais de requisitos válidos, situação de aprovação na revisão manual |
| Análise da estrutura de discussões | Taxa de sucesso de associação pai-filho, proporção de cadeias de respostas válidas |
| Avaliação de modelos | Consistência de anotações, diversidade de amostras, verificação de vazamento |
Somente quando os dados melhoram os resultados da tarefa real é que a escala se transforma verdadeiramente em valor.
¶ VII. Antes de usar, confirme os limites de dados e direitos
Dados acessíveis não significam que podem ser usados para todos os fins.
A página do serviço declara claramente: a exibição no catálogo e o acesso à visualização pública não concedem direitos para treinamento de modelos, uso comercial ou redistribuição dos dados completos; a origem, a licença e os usos permitidos da versão selecionada precisam ser confirmados antes da entrega.[1]
Recomenda-se esclarecer, antes do início do projeto:
- Escopo da versão: quais seções, períodos e idiomas são abrangidos;
- Conteúdo da entrega: número de registros, campos reais, formato e método de compressão;
- Critérios de qualidade: como são definidos registros válidos, conteúdo inválido e discussões completas;
- Processamento de privacidade: como são tratados nomes de usuário, informações pessoais no corpo do texto e conteúdo excluído;
- Usos autorizados: se são permitidas análise interna, exibição de recuperação, treinamento e aplicações comerciais;
- Mecanismo de manutenção: se são fornecidas atualizações e como exclusões e correções são sincronizadas.
Ao mesmo tempo, esta página pertence a um catálogo de dados e consulta de requisitos, e não se deve presumir, com base nela, que inclua uma API do Reddit em tempo real ou uma assinatura de atualizações contínuas.[2]
¶ Conclusão: fazer a IA compreender opiniões e também as relações entre elas
O valor das discussões comunitárias não está apenas no que os usuários disseram, mas também em por que levantaram uma pergunta, sob quais condições aceitam uma determinada solução e como esclarecem gradualmente a resposta por meio de perguntas complementares e refutações.
Para aplicações de IA, preservar essas relações ajuda a transformar textos isolados em uma base de informações mais contextualizada. O conjunto de dados do Reddit da Ace Data Cloud fornece uma porta de entrada para explorar esse tipo de aplicação.
Seja o objetivo recuperação de conhecimento, resumo de discussões, pesquisa de necessidades dos usuários ou avaliação de modelos, recomenda-se partir do mesmo caminho: primeiro esclarecer a tarefa, depois validar as amostras; primeiro confirmar a qualidade e a licença, depois expandir a escala da aplicação.
Fazer a IA entender discussões não é apenas fazê-la ler mais texto, mas fazê-la compreender com mais precisão: ao que uma resposta está respondendo e sob quais condições um ponto de vista é válido.
¶ Comece a explorar
- Ver a introdução do conjunto de dados do Reddit
- Contatar a Ace Data Cloud para discutir o escopo dos dados e as necessidades de uso
¶ Fontes
[1] Introdução ao serviço de conjunto de dados do Reddit da Ace Data Cloud。
[2] Pacote público de exemplos do conjunto de dados do Reddit, incluindo referência de campos, dados de visualização e README.
Descrição das imagens: a capa e as imagens no corpo do texto são designs conceituais gerados por IA e não representam capturas de tela reais dos dados ou interfaces de produtos já entregues. Os números de escala na capa são estimativas registradas no catálogo; a versão específica, o escopo de entrega e a licença de uso precisam ser confirmados. A marca Reddit é usada para identificar o objeto discutido neste artigo e não indica parceria ou endosso.