
¶ 一、なぜ AI に必要なのは、単により多くのテキストだけではないのか?
「この方法は本番環境には適していません。」
この一文だけを見ても、AI がそれが何を否定しているのかを判断するのは困難です。ある技術なのか、あるデプロイ方法なのか、それとも特定の条件下における実装方法なのか?
しかし、前後の文脈を補えば、意味はより明確になる可能性があります。
**質問:**ファイル共有サービスを作りたいのですが、アップロードしたファイルを直接コンテナ内部に保存してもよいですか?
**回答:**短期的な検証であれば可能ですが、コンテナ再構築後のデータ保持を考慮する必要があります。
**追加質問:**正式にリリースする場合はどうですか?
**補足:**その場合は、永続化、バックアップ、スケールアウトをさらに考慮する必要があり、プロトタイプ段階の方法をそのまま使い続けることはできません。
以上はコンテキストの役割を説明するための例示的な対話であり、データセットの元の記録ではありません。
この例で本当に抽出する価値がある知識は、単純な「できる」または「できない」ではなく、どのような条件でその方法が成立し、どのような場合に調整が必要となるかです。
これこそがコミュニティディスカッションデータの独自の価値です。そこには結論だけでなく、質問が提起された背景、異なる方法のトレードオフ、そして見解が補足・修正される過程も記録されています。AI がコミュニティコンテンツをより良く活用するためには、投稿とコメントを単なるテキスト断片に分割するだけでなく、それらの間の関係も可能な限り保持する必要があります。
¶ 二、Ace Data Cloud Reddit データセットを知る
Ace Data Cloud の Reddit Posts & Comments(Reddit 投稿・コメント)データセットは、フォーラムの投稿、コメント、および多階層の返信を中心にコンテンツを構成し、所属コミュニティと親子関係を保持しています。議論テーマやコンテンツ条件に応じてデータ範囲を選択できます。[1]
このデータセットが注目しているのは、単に「どのようなテキストがあるか」だけではなく、以下も含まれます。
- このコンテンツがどの議論コミュニティに属しているか;
- 元の投稿がどのような質問を提起したか;
- コメントが投稿に返信しているのか、それとも別のコメントに返信しているのか;
- 後続の返信が、それまでの見解をどのように補足、疑問視、または発展させているか。
¶ データ規模と公開プレビュー
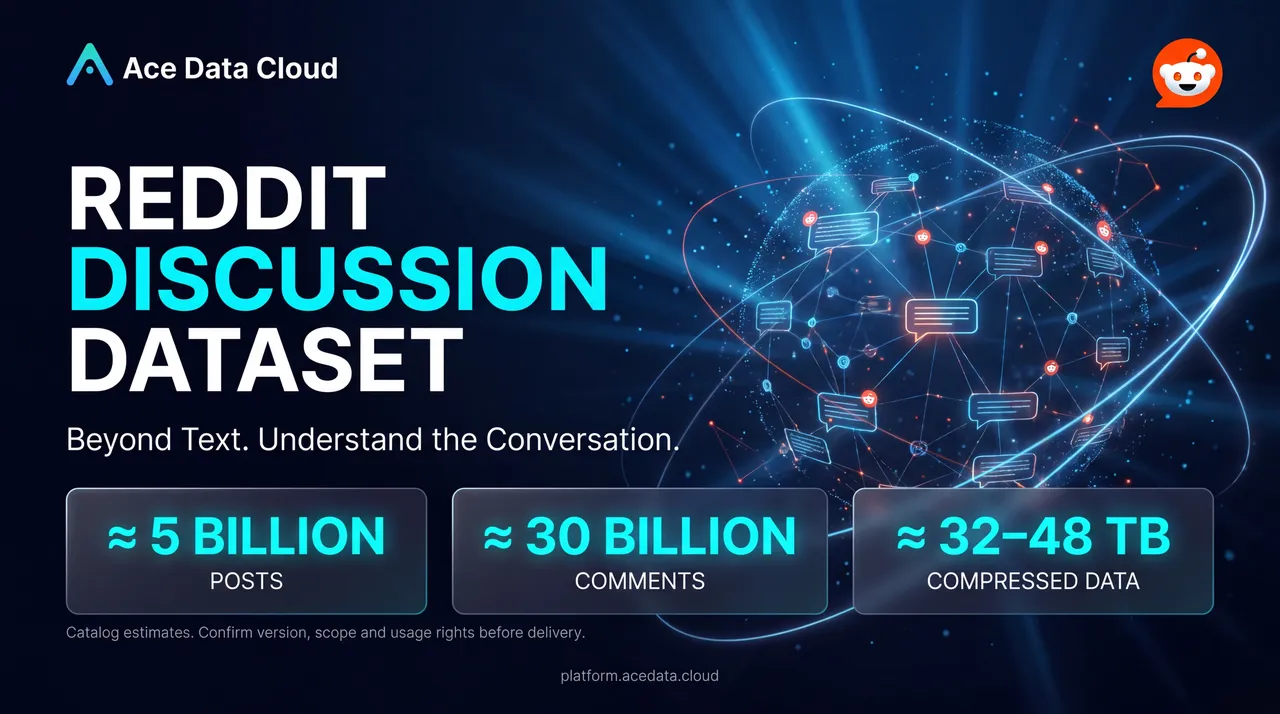
サービスページに表示されているカタログ登録情報は以下のとおりです。これらの数値はカタログ規模の基準によるものであり、実際に提供可能な件数、容量、および範囲については、具体的なバージョンごとに確認が必要です。[1]
| 次元 | カタログ説明 |
|---|---|
| 投稿規模 | 約 50 億件(5 billion) |
| コメント規模 | 約 300 億件(30 billion) |
| 圧縮容量 | 約 32~48 TB |
| 公開プレビュー | 5 件のプレビュー記録、画像抜粋なし |
| 付属資料 | フィールド参照および中国語・英語 README |
| 取得方法 | まずサンプルを確認し、その後バージョン、範囲、ライセンス、見積もりを確認 |
具体的なプロジェクトにおいて、より重要な問題は「データが全部でどれだけあるか」ではなく、ビジネスに関連し、コンテンツが有効で、関係を復元でき、許諾が用途に適合するデータがどれだけあるかです。
たとえば、Web 開発向けの質問応答アシスタントを構築する場合、通常は最大のデータ量を直接追求するのではなく、関連コミュニティにおけるテーマの網羅性と回答の品質を優先すべきです。
¶ 三、データ構造:テキストを議論の文脈に戻す
このデータセットを理解するには、投稿、コメント、返信関係という 3 つの層から着手できます。

概念図:議論の関係を保持してこそ、文脈をより良く理解できます。
¶ 1. 投稿:質問がどこから始まるかを理解する
投稿は通常、議論のテーマと初期背景を提供します。公開サンプルパッケージのフィールド参照には、投稿 ID、コミュニティ、時刻、タイトル、本文、タグ、元リンクなどのフィールドが記載されています。[2]
| フィールド | 意味 | 活用価値 |
|---|---|---|
post.id |
投稿識別子 | 重複排除、インデックス、コメント関連付け |
post.channel |
所属コミュニティ | 分野とコミュニティ範囲の設定 |
post.title |
投稿タイトル | 質問識別とテーマ検索 |
post.text |
投稿本文 | 要件、背景、制約の抽出 |
post.timestamp |
投稿時刻 | 時間フィルタリングとトレンド分析 |
post.flair |
投稿タグ | 分類支援とコンテンツフィルタリング |
たとえば、「ブログ記事をどのように保存するか」は質問の要約にすぎません。本文で言及される技術スタック、編集方法、表示要件こそが、どの提案が実際に適用できるかを左右する可能性があります。
¶ 2. コメント:回答、経験、意見の相違を観察する
コメントが必ずしも直接的な回答とは限らず、追加質問、訂正、反例、または経験の補足である場合もあります。フィールド参照内のコメントオブジェクトには、ID、本文、コミュニティ、時刻、親識別子などの情報が含まれます。コメント時刻は数値テキストとして保存されている一方、投稿時刻は Unix 秒として記載されているため、処理時にはそれぞれを検証し、形式を統一する必要があります。[2]
アプリケーションの観点では、さらに区別する必要があります。どのコメントが質問に直接回答しているのか、どの提案が特定の条件下でのみ成立するのか、どの内容が前述の誤りを訂正しているのか、どの情報が少ない、またはすでに本題から逸れているのか。こうした判断には通常、ルール、モデル、人工レビューの連携が必要であり、コメント数だけでは完了できません。
¶ 3. 親子関係:「誰が誰に返信しているか」を識別する
comments[].parent は親となる投稿またはコメント ID を記録するために使用され、t1_、t3_ 接頭辞も保持されています。これは返信関係を復元するための関連付けの根拠を提供しますが、具体的なバージョンにおける関連の完全性については、依然としてサンプルを通じて検証する必要があります。[2]
AI アプリケーションにとって、これは「独立したコメント検索」からさらに進み、「文脈を伴う返信チェーン検索」へと移行できる可能性を意味します。
注意すべき点として、フィールド参照は各バージョンの実際の提供リストと同義ではありません。サンプル説明では、投稿オブジェクトが空である可能性、本文が欠落している可能性または削除マークが付いている可能性、公開プレビューの列と元のフィールドが完全には一致しない可能性が示されています。[2]
¶ 四、コミュニティディスカッションから AI アプリケーションへ:探索する価値のある 6 つのシナリオ
以下のアプリケーションの方向性は、データ構造に基づいて提示したものであり、実装の考え方に属します。データサービスに対応するモデルやアプリケーションシステムが付属していることを意味するものではありません。実際に導入する際には、まずデータ品質、カバー範囲、利用許諾を確認する必要があります。

¶ シーン一:RAG ナレッジベースにコミュニティの経験を補完する
公式ドキュメントは機能や仕様の説明に優れている一方、コミュニティの議論は実際の利用における問題やトレードオフを補完できる:なぜあるソリューションが特定の環境では適用できないのか、異なる制約に直面した場合にどのようにツールを選ぶのか、そして一つの提案にはどのような反例や補足条件があるのか。
検索拡張生成(RAG)システムを構築する際は、投稿タイトル + 問題の背景 + 関連コメント + 必要な親返信を検索単位として組み合わせることができる。
例えば、ユーザーが「個人ブログではデータベースと Markdown ファイルのどちらを使うべきか」と尋ねた場合、システムは単にツール名を一つ返すのではなく、編集頻度、複数人での協業、デプロイ方法などの条件に関連する議論を検索し、その上で回答を構成すべきである。
**適したプロジェクト:**開発者アシスタント、技術選定ツール、垂直型知識質問応答システム。
**重要な提案:**コミュニティの経験と権威ある資料を区別して表示する;回答がバージョン、性能、または安全性に関わる場合は、さらに検証すべきである。
¶ シーン二:長い議論を複数の観点による要約に整理する
一つの長い議論には、賛成意見、反対理由、補足条件、未解決の問題が同時に存在する可能性がある。通常の要約が過度に圧縮されると、議論のある内容を一致した結論として書いてしまいやすい。
返信関係を保持した後は、以下の構造を中心に要約を整理できる:
- 元の問題と既知の制約;
- 主な候補ソリューション;
- 異なるソリューションを支持する理由;
- 反対意見と適用範囲;
- 依然として検証が必要な問題。
「ファイルストレージを自前で構築すべきか」を例にすると、要約の目的は単純に「すべき」または「すべきでない」と出力することではなく、プロトタイプ検証、個人プロジェクト、正式なサービスなどの異なる条件において、どのような違いを考慮する必要があるかを説明することである。
**適したプロジェクト:**コミュニティ閲覧アシスタント、技術研究ブリーフィング、議論要約ツール。
**重要な提案:**意見の相違を保持し、重要な結論については追跡可能な内容上の根拠を残す。
¶ シーン三:ユーザーの質問から製品ニーズの手がかりを見つける
製品ニーズは、規範的な要件文書として現れることは多くなく、ユーザーの疑問や不満の中に隠れている:「もっと簡単な方法はないのか?」「なぜ必ずこのサービスに依存しなければならないのか?」「小さなプロジェクトを作るだけなのに、これほど複雑である必要があるのか?」
公開プレビューでは、「ブログ記事をどのように保存するか」という投稿が、データベース、Markdown、記事の表示方法などの問題に関わっている。[1]
製品チームはこれをもとに、検証すべき仮説を形成できる:ユーザーには執筆から公開までの完全なフローが不足している可能性があり、データベースとファイル管理の適用範囲を明確に理解していない可能性があり、コンテンツ管理の設定コストを下げたいと考えている可能性もある。続いて、より多くの同種の議論、インタビュー、または製品データによって検証する。
**適したプロジェクト:**開発者ツール、コンテンツ管理システム、クラウドサービスおよび垂直型ソフトウェアのニーズ調査。
**重要な提案:**コミュニティの議論を定性的な研究資料として扱い、少数の投稿を市場全体のニーズの比率として直接外挿しない。
¶ シーン四:技術テーマとコミュニティの関心の変化を研究する
時間範囲が連続しており、収集基準が比較可能であるという前提のもとで、議論が「これは何か」から「どのようにデプロイするか」へ移行しているか、初心者コミュニティと専門家コミュニティが注目する困難にはどのような違いがあるか、そしてユーザーが代替案を比較する際にどのような条件をますます重視しているかを観察できる。
**適したプロジェクト:**技術トレンド研究、コミュニティ運営、開発者向けコンテンツ企画。
**重要な提案:**投稿数の増加は必ずしも全体的な関心度の上昇を意味するわけではなく、カバレッジ範囲やフィルタリングルールの変化による可能性もある。トレンドに関する結論は、比較可能なデータに基づくべきである。
¶ シーン五:実際の議論により近い AI 評価を構築する
コミュニティのコンテンツには、短い返信、曖昧な指示語、前の文脈に対する訂正、意見の相違が含まれており、文脈理解タスクの設計に適している。対応する許可を得てアノテーションを完了した後、以下を研究できる:
| 評価タスク | 検証すべき能力 |
|---|---|
| 返信の関連性判定 | コメントが本当に問題に応答しているか |
| コメント機能の識別 | 回答、追加質問、訂正、反論を区別する |
| 文脈理解 | 「この方法」「前のソリューション」が何を指すかを理解する |
| 複数観点の要約 | 異なる立場とその適用条件を保持する |
| 検索評価 | 回答を支えるのに十分な議論の断片を検索する |
**適したプロジェクト:**質問応答システム評価、要約モデル評価、議論理解研究。
**重要な提案:**元のコメントは自然に標準解答となるものではない。事実を検証し、アノテーションの規範を策定し、同じ議論を訓練セットとテストセットに分割して情報漏洩を引き起こすことを避ける必要がある。
¶ シーン六:重複した問題とコンテンツ品質の問題を識別する
コミュニティ運営とコンテンツガバナンスの研究においては、コンテンツを中心に、類似問題のクラスタリング、重複質問の発見、脱線したコメントや情報量の少ないコメントの識別、広告や無意味な投稿の分類、およびよくある質問の目録整理を行うことができる。
複数の投稿が同じ種類の設定問題を繰り返し尋ねている場合、それらを FAQ の手がかりとして整理し、チームがドキュメント内で不足している説明を発見するのに役立てることができる。
**適したプロジェクト:**コミュニティ知識管理、ドキュメント最適化、コンテンツ品質研究。
**重要な提案:**コンテンツレベルおよび集計レベルの分析を優先し、不必要な個人プロファイリングを避ける;ユーザー名を削除しても、本文の匿名化が完了していることを意味しない。
¶ 五、プロジェクトに本当に適したデータをどのように選ぶか?
大規模データに直面した際、最も効果的な出発点は、範囲を拡大することではなく、境界を明確にすることである。サービスページには、カテゴリによるフィルタリング、NSFW および無効なコンテンツの除外、投稿のコメント数によるフィルタリングなどの範囲選択方法が記載されており、具体的なルールと効果はバッチごとに検証する必要がある。[1]
¶ 1. まずテーマを選び、それから規模を見る
目標が技術的なQ&Aである場合は、関連する板と質問タイプを先に検証すべきである。目標が製品リサーチである場合は、利用背景、具体的な困難、代替案を含むコンテンツを優先して探すべきである。あるサブセットの件数が多いからといって、それが現在のタスクに適しているとデフォルトで判断してはならない。
¶ 2. まず有効なコンテンツを見て、その後にインタラクション数を見る
コメント数が多いことは情報が豊富であることを意味する場合もあれば、議論が激しい、または大量に脱線していることを意味する場合もある。現在のフィールド参考には、いいねスコア、閲覧数、または「ベストアンサー」マークは記載されておらず、これらの指標で高品質なコンテンツを絞り込めるとデフォルトで想定することはできない。[2]
より堅実な方法は、関連性、情報の完全性、ソース、および手動サンプリングチェックを組み合わせて品質を判断することである。
¶ 3. まず関係を検証し、その後にコンテキスト活用を構築する
プロジェクトがディスカッションツリーに依存する場合、親投稿または親コメントを見つけられるか、返信チェーンが中断していないか、削除されたコンテンツが理解に影響しないか、時系列が利用可能か、そして個人識別情報を除去した後でもコンテキストが十分に残るかを重点的に確認すべきである。
「親フィールドが存在すること」と「ディスカッションを完全に復元できること」は、異なる2つの受け入れ目標である。
¶ 六、サンプルからアプリケーションへ:実行可能な導入パス
¶ 第一步:一文でビジネス目標を説明する
例:「Web開発に関する質問向けの検索アシスタントを構築し、元の質問と関連する返信を保持し、板と時間によるフィルタリングをサポートし、回答において追跡可能な根拠を提供する。」
「Redditデータが一括で必要」と言うよりも、このような説明のほうが明確なデータ範囲と受け入れ基準を形成しやすい。
¶ 第二步:公開サンプルを確認し、その後に代表性のある検証サンプルを申請する
公開サンプルパッケージは5件のプレビュー記録、およびJSON、CSV、フィールド参考、READMEを提供しており、データ形式を初歩的に理解するために利用できるが、全体的な品質を評価するには不十分である。[2]
Redditデータセット公開サンプルパッケージをダウンロード
正式な検証に入った後は、フィールド欠損、重複コンテンツ、有効本文の割合、返信関連付けの成功率、および対象テーマのカバー状況を確認することが推奨される。
¶ 第三步:クリーニングとコンテキスト処理フローを構築する
参考となるエンジニアリングフローは以下のとおりである。
データ取り込み → フィールド検証 → 重複排除とフィルタリング → プライバシー処理 → 返信関係の再構築 → タスクデータの整理 → インデックスまたは分析 → 品質評価
タスクによって異なる整理方法を採用できる。RAGでは質問と関連返信チェーンに基づいて検索単位を整理する。要約では主要な分岐を保持し、コンテキスト長を制御する。ニーズ調査では類似した質問と利用制約を集約する。モデル評価では完全なディスカッションに基づいてデータを分割し、手動アノテーションを追加する。
これはアプリケーション側の実施提案であり、サービスにデフォルトで含まれる納品フローではない。
¶ 第四步:インポート件数だけを集計するのではなく、ビジネス指標で検証する
| アプリケーションの方向 | 注目すべき推奨指標 |
|---|---|
| ナレッジ検索 | 関連コンテンツの再現率、根拠の十分性、回答の追跡可能性 |
| ディスカッション要約 | 観点のカバー、事実の一貫性、論争の保持 |
| 製品リサーチ | 有効なニーズの手がかり、手動レビューの通過状況 |
| ディスカッション構造分析 | 親子関連付けの成功率、有効な返信チェーンの割合 |
| モデル評価 | アノテーションの一貫性、サンプルの多様性、リークチェック |
データが実際のタスク効果を改善して初めて、規模は真に価値へと転換される。
¶ 七、使用前に、データと権利の境界を確認する
データにアクセス可能であることは、すべての用途に使用できることを意味しない。
サービスページでは、カタログ表示と公開プレビューへのアクセスは、全量データのモデル学習、商用利用、または再配布の権利を付与するものではないことが明確に説明されている。選択したバージョンのソース、ライセンス、および許可される用途は、納品前に確認する必要がある。[1]
プロジェクト開始前に、以下を明確にすることが推奨される。
- **バージョン範囲:**どの板、期間、言語をカバーするか。
- **納品内容:**レコード数、実際のフィールド、形式、および圧縮方式。
- **品質基準:**有効レコード、無効コンテンツ、完全なディスカッションをどのように定義するか。
- **プライバシー処理:**ユーザー名、本文中の個人情報、削除コンテンツをどのように処理するか。
- **許可される用途:**内部分析、検索表示、学習、および商用アプリケーションが許可されるか。
- **保守メカニズム:**更新が提供されるか、また削除や訂正をどのように同期するか。
同時に、このページはデータカタログおよび要件相談に属するものであり、これに基づいてリアルタイムのReddit APIまたは継続的な更新サブスクリプションが含まれると想定すべきではない。[2]
¶ 結び:AIに観点を理解させ、観点同士の関係も理解させる
コミュニティディスカッションの価値は、ユーザーが何を言ったかだけではなく、なぜ問題を提起したのか、どのような条件で特定の案を受け入れたのか、そして追加質問や反論を通じてどのように回答を徐々に明確にしたのかにもある。
AIアプリケーションにとって、これらの関係を保持することは、孤立したテキストをよりコンテキストのある情報基盤へと変換するのに役立つ。Ace Data Cloud Redditデータセットは、この種のアプリケーションを探求するための入口を提供する。
目標がナレッジ検索、ディスカッション要約、ユーザーニーズ調査、またはモデル評価のいずれであっても、同じパスから始めることが推奨される。まずタスクを明確にし、その後にサンプルを検証する。まず品質とライセンスを確認し、その後にアプリケーション規模を拡大する。
AIにディスカッションを読み取らせることは、単により多くの文字を読ませることではなく、ある回答が何に応答しているのか、ある観点がどのような条件で成立するのかをより正確に理解させることである。
¶ 探索を始める
¶ 資料出典
[1] Ace Data Cloud Redditデータセットサービス紹介。
[2] Redditデータセット公開サンプルパッケージ。フィールド参考、プレビューデータ、およびREADMEを含む。
画像説明:表紙および本文内の画像はAI生成のコンセプトデザインであり、実際のデータスクリーンショットまたは納品済み製品インターフェースを表すものではない。表紙の規模数値はカタログ登録時の推定値であり、具体的なバージョン、納品範囲、利用ライセンスは確認が必要である。Redditの標識は本文の議論対象を示すために使用しており、提携または支持を意味するものではない。