
¶ I. Warum braucht KI mehr als nur mehr Text?
„Diese Lösung ist nicht für die Produktionsumgebung geeignet.“
Wenn KI nur diesen Satz sieht, ist es schwierig zu beurteilen, was genau damit abgelehnt wird: eine Technologie, eine Bereitstellungsart oder ein Implementierungsansatz unter bestimmten Bedingungen?
Wenn jedoch der vorherige Kontext ergänzt wird, kann die Bedeutung deutlich klarer werden:
Frage: Ich möchte einen Dateifreigabedienst erstellen. Kann ich hochgeladene Dateien direkt im Container speichern?
Antwort: Für kurzfristige Tests ist das möglich, aber die Datenaufbewahrung nach einer Container-Neuerstellung muss berücksichtigt werden.
Nachfrage: Und wenn es offiziell in Betrieb gehen soll?
Ergänzung: Dann müssen Persistenz, Backups und Skalierung weiter berücksichtigt werden; die Vorgehensweise aus der Prototyp-Phase kann nicht einfach übernommen werden.
Das Obige ist ein beispielhafter Dialog zur Veranschaulichung der Funktion von Kontext und kein ursprünglicher Datensatz-Eintrag.
In diesem Beispiel ist das tatsächlich extrahierenswerte Wissen nicht einfach „möglich“ oder „nicht möglich“, sondern unter welchen Bedingungen eine Lösung funktioniert und unter welchen Umständen sie angepasst werden muss.
Das ist auch der einzigartige Wert von Community-Diskussionsdaten: Sie enthalten nicht nur Schlussfolgerungen, sondern dokumentieren auch den Hintergrund der Fragestellung, die Abwägungen zwischen verschiedenen Lösungen sowie den Prozess, in dem Ansichten ergänzt und korrigiert werden. Damit KI Community-Inhalte besser nutzen kann, dürfen Beiträge und Kommentare nicht nur in einzelne Textabschnitte zerlegt werden; auch ihre Beziehungen zueinander sollten so weit wie möglich erhalten bleiben.
¶ II. Das Ace Data Cloud Reddit-Dataset verstehen
Das Reddit Posts & Comments(Reddit-Beiträge und Kommentare)Dataset von Ace Data Cloud organisiert Inhalte rund um Forenbeiträge, Kommentare und mehrstufige Antworten, bewahrt die zugehörigen Bereiche und Eltern-Kind-Beziehungen und unterstützt die Auswahl des Datenumfangs nach Diskussionsthemen und Inhaltsbedingungen.[1]
Es konzentriert sich nicht nur darauf, „welche Texte vorhanden sind“, sondern auch darauf:
- Zu welchem Diskussionsbereich dieser Inhalt gehört;
- Welche Frage der ursprüngliche Beitrag gestellt hat;
- Ob ein Kommentar auf den Beitrag oder auf einen anderen Kommentar antwortet;
- Wie nachfolgende Antworten die vorherigen Ansichten ergänzen, hinterfragen oder weiterführen.
¶ Datenumfang und öffentliche Vorschau
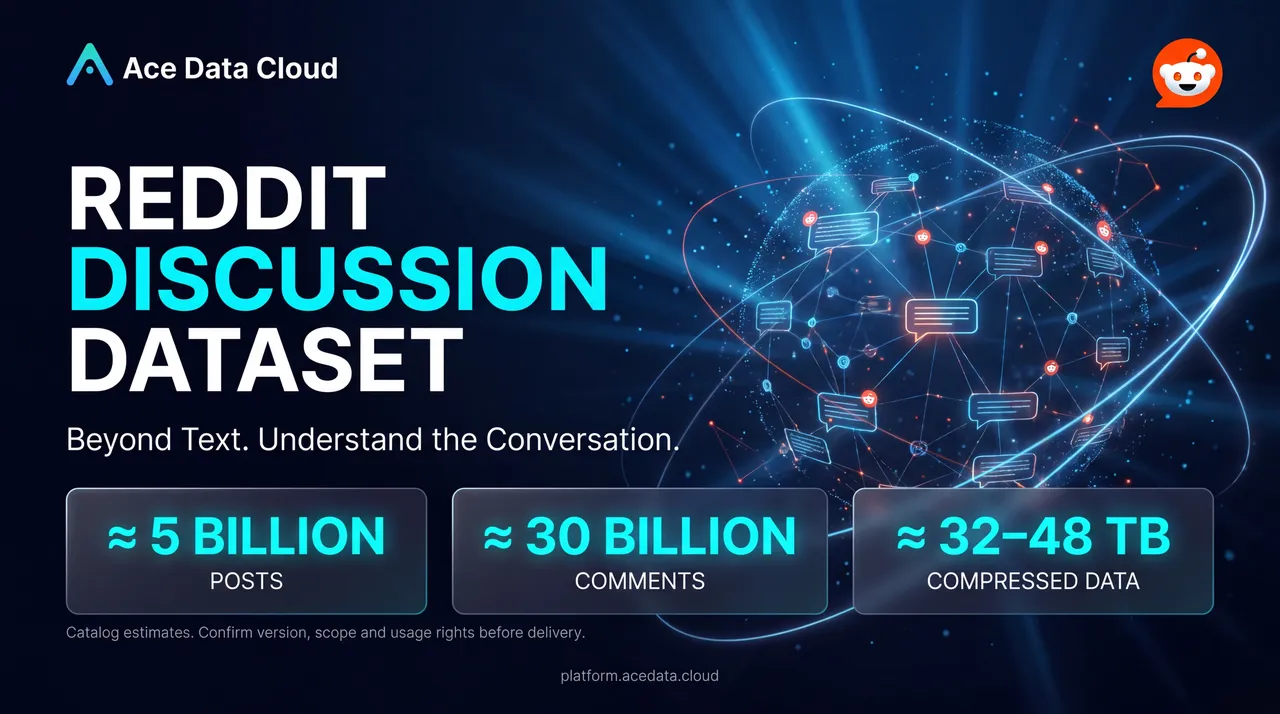
Die auf der Serviceseite angezeigten Katalogregistrierungsinformationen lauten wie folgt. Diese Zahlen beziehen sich auf den Katalogumfang; die tatsächlich lieferbare Menge, das Volumen und der Umfang müssen weiterhin anhand der konkreten Version bestätigt werden.[1]
| Dimension | Katalogbeschreibung |
|---|---|
| Beitragsumfang | Etwa 5 Milliarden (5 billion) |
| Kommentarumfang | Etwa 30 Milliarden (30 billion) |
| Komprimiertes Volumen | Etwa 32–48 TB |
| Öffentliche Vorschau | 5 Vorschau-Datensätze, keine Bildauszüge |
| Begleitmaterialien | Feldreferenz sowie README auf Chinesisch und Englisch |
| Bezugsmethode | Zuerst Stichprobe prüfen, dann Version, Umfang, Lizenz und Preis bestätigen |
Für konkrete Projekte ist die wichtigere Frage nicht „wie viele Daten es insgesamt gibt“, sondern: Wie viele Daten geschäftsrelevant, inhaltlich gültig, in ihren Beziehungen rekonstruierbar und für den vorgesehenen Zweck ordnungsgemäß lizenziert sind.
Beim Aufbau eines Frage-Antwort-Assistenten für Webentwicklung sollte beispielsweise normalerweise der Themenabdeckung relevanter Bereiche und der Qualität der Antworten Vorrang gegeben werden, statt direkt die größtmögliche Datenmenge anzustreben.
¶ III. Datenstruktur: Texte wieder in den Diskussionskontext einordnen
Dieses Dataset lässt sich auf drei Ebenen verstehen: Beiträge, Kommentare und Antwortbeziehungen.

Konzeptionelle Darstellung: Nur durch den Erhalt der Diskussionsbeziehungen lässt sich der Kontext besser verstehen.
¶ 1. Beiträge: Verstehen, wo eine Frage beginnt
Beiträge liefern in der Regel das Thema und den anfänglichen Hintergrund einer Diskussion. Die Feldreferenz des öffentlichen Beispielpakets führt Felder wie Beitrags-ID, Bereich, Zeit, Titel, Textkörper, Tags und ursprünglichen Link auf.[2]
| Feld | Bedeutung | Anwendungswert |
|---|---|---|
post.id |
Beitragskennung | Deduplizierung, Indizierung und Kommentarzuordnung |
post.channel |
Zugehöriger Bereich | Abgrenzung von Fachgebiet und Community-Bereich |
post.title |
Beitragstitel | Fragenerkennung und Themensuche |
post.text |
Beitragstext | Extraktion von Anforderungen, Hintergrund und Einschränkungen |
post.timestamp |
Beitragszeit | Zeitfilterung und Trendanalyse |
post.flair |
Beitrags-Tag | Unterstützung bei Klassifizierung und Inhaltsfilterung |
Zum Beispiel ist „Wie speichere ich Blogartikel?“ nur eine Zusammenfassung der Frage; der im Textkörper erwähnte Technologie-Stack, die Bearbeitungsmethode und die Darstellungsanforderungen können erst bestimmen, welche Empfehlungen tatsächlich geeignet sind.
¶ 2. Kommentare: Antworten, Erfahrungen und Meinungsverschiedenheiten beobachten
Kommentare sind nicht zwangsläufig direkte Antworten; sie können auch Nachfragen, Korrekturen, Gegenbeispiele oder Erfahrungsergänzungen sein. Das Kommentarobjekt in der Feldreferenz enthält Informationen wie ID, Textkörper, Bereich, Zeit und übergeordnete Kennung. Die Kommentarzeit wird als numerischer Text gespeichert, während die Beitragszeit als Unix-Sekunden gekennzeichnet ist; bei der Verarbeitung sollten beide getrennt geprüft und in ein einheitliches Format überführt werden.[2]
Auf Anwendungsebene muss weiter unterschieden werden: Welche Kommentare beantworten die Frage direkt, welche Empfehlungen gelten nur unter bestimmten Bedingungen, welche Inhalte korrigieren frühere Fehler und welche Informationen sind wenig gehaltvoll oder bereits vom Thema abgekommen. Solche Beurteilungen erfordern in der Regel das Zusammenspiel von Regeln, Modellen und manueller Prüfung und können nicht allein anhand der Kommentaranzahl vorgenommen werden.
¶ 3. Eltern-Kind-Beziehungen: Erkennen, „wer auf wen antwortet“
comments[].parent wird verwendet, um die ID des übergeordneten Beitrags oder Kommentars aufzuzeichnen, und behält die Präfixe t1_ und t3_ bei. Es liefert eine Verknüpfungsgrundlage für die Rekonstruktion von Antwortbeziehungen, doch die Vollständigkeit der Verknüpfungen in der konkreten Version muss weiterhin anhand von Stichproben überprüft werden.[2]
Für KI-Anwendungen bedeutet dies, dass versucht werden kann, von der „Suche nach eigenständigen Kommentaren“ zu einer „Suche nach Antwortketten mit Kontext“ überzugehen.
Es ist zu beachten, dass die Feldreferenz nicht der tatsächlichen Lieferliste jeder Version entspricht. Die Beispielbeschreibung weist darauf hin, dass Beitragsobjekte leer sein können, Textkörper fehlen oder Löschmarkierungen enthalten können und dass die Spalten der öffentlichen Vorschau nicht vollständig mit den ursprünglichen Feldern übereinstimmen.[2]
¶ IV. Von Community-Diskussionen zu KI-Anwendungen: sechs erkundenswerte Szenarien
Die folgenden Anwendungsrichtungen werden auf Grundlage der Datenstruktur vorgeschlagen und sind Umsetzungsideen; sie bedeuten nicht, dass der Datendienst bereits entsprechende Modelle oder Anwendungssysteme beinhaltet. Vor der tatsächlichen Umsetzung müssen Datenqualität, Abdeckungsumfang und Nutzungslizenzen bestätigt werden.

¶ Szenario eins: Community-Erfahrungen für eine RAG-Wissensdatenbank ergänzen
Offizielle Dokumentationen eignen sich gut zur Erklärung von Funktionen und Spezifikationen, während Community-Diskussionen Probleme und Abwägungen aus der tatsächlichen Nutzung ergänzen können: Warum eine bestimmte Lösung in einer bestimmten Umgebung nicht geeignet ist, wie man angesichts unterschiedlicher Einschränkungen Werkzeuge auswählt und welche Gegenbeispiele und zusätzlichen Bedingungen es für eine Empfehlung gibt.
Beim Aufbau eines Retrieval-Augmented-Generation-(RAG)-Systems können Posttitel + Problemhintergrund + relevante Kommentare + notwendige übergeordnete Antworten zu einer Abrufeinheit kombiniert werden.
Wenn ein Nutzer beispielsweise fragt: „Sollte ein persönlicher Blog eine Datenbank oder Markdown-Dateien verwenden?“, sollte das System nicht nur einen Toolnamen zurückgeben, sondern Diskussionen zu Bedingungen wie Bearbeitungshäufigkeit, Zusammenarbeit mehrerer Personen und Bereitstellungsweise abrufen und anschließend die Antwort strukturieren.
Geeignete Projekte: Entwicklerassistenten, Tools zur Technologieauswahl, vertikale Wissensfrage-Antwort-Systeme.
Wichtiger Hinweis: Community-Erfahrungen und autoritative Materialien getrennt darstellen; bei Antworten zu Versionen, Leistung oder Sicherheit sollten weitere Überprüfungen erfolgen.
¶ Szenario zwei: Lange Diskussionen in Zusammenfassungen mit mehreren Perspektiven ordnen
In einer langen Diskussion können gleichzeitig unterstützende Meinungen, Gegenargumente, ergänzende Bedingungen und ungelöste Fragen vorhanden sein. Wenn gewöhnliche Zusammenfassungen zu stark komprimiert werden, wird strittiger Inhalt leicht als einheitliche Schlussfolgerung dargestellt.
Nach dem Erhalt der Antwortbeziehungen kann die Zusammenfassung anhand der folgenden Struktur organisiert werden:
- Ursprüngliche Frage und bekannte Einschränkungen;
- Wichtigste Kandidatenlösungen;
- Gründe zur Unterstützung der verschiedenen Lösungen;
- Gegenmeinungen und Anwendungsgrenzen;
- Noch zu überprüfende Fragen.
Am Beispiel der Frage „Sollte Dateispeicher selbst aufgebaut werden?“ besteht das Ziel der Zusammenfassung nicht darin, einfach „sollte“ oder „sollte nicht“ auszugeben, sondern zu erläutern: Welche Unterschiede unter verschiedenen Bedingungen wie Prototypvalidierung, persönlichen Projekten und produktiven Diensten berücksichtigt werden müssen.
Geeignete Projekte: Community-Leseassistenten, technische Forschungsbriefings, Tools zur Diskussionszusammenfassung.
Wichtiger Hinweis: Meinungsunterschiede beibehalten und für wichtige Schlussfolgerungen nachvollziehbare Inhaltsgrundlagen bewahren.
¶ Szenario drei: Produktbedarfsindikatoren aus Nutzerfragen entdecken
Produktanforderungen erscheinen oft nicht als standardisierte Anforderungsdokumente, sondern verbergen sich in den Zweifeln und Beschwerden der Nutzer: „Gibt es keine einfachere Methode?“, „Warum muss man unbedingt von diesem Dienst abhängig sein?“, „Ich mache nur ein kleines Projekt, muss es so kompliziert sein?“
In der öffentlichen Vorschau betrifft der Beitrag „Wie speichert man Blogartikel?“ Fragen wie Datenbanken, Markdown und die Darstellungsweise von Artikeln.[1]
Produktteams können daraus zu überprüfende Hypothesen ableiten: Nutzern fehlt möglicherweise ein vollständiger Prozess vom Schreiben bis zur Veröffentlichung, sie verstehen möglicherweise die Anwendungsgrenzen von Datenbanken und Dateiverwaltung nicht oder möchten die Konfigurationskosten der Inhaltsverwaltung senken. Anschließend erfolgt die Validierung durch weitere ähnliche Diskussionen, Interviews oder Produktdaten.
Geeignete Projekte: Bedarfsforschung für Entwicklertools, Content-Management-Systeme, Cloud-Dienste und vertikale Software.
Wichtiger Hinweis: Community-Diskussionen als qualitative Forschungsmaterialien betrachten und nicht wenige Beiträge direkt auf den Bedarfsanteil des gesamten Marktes hochrechnen.
¶ Szenario vier: Veränderungen technischer Themen und Community-Schwerpunkte untersuchen
Unter der Voraussetzung eines kontinuierlichen Zeitraums und vergleichbarer Erhebungskriterien kann beobachtet werden, ob sich Diskussionen von „Was ist das?“ zu „Wie wird es bereitgestellt?“ verlagern, worin sich die Schwierigkeiten unterscheiden, auf die sich Anfänger- und Fachcommunities konzentrieren, und welchen Bedingungen Nutzer beim Vergleich alternativer Lösungen zunehmend Bedeutung beimessen.
Geeignete Projekte: Forschung zu Technologietrends, Community-Betrieb, Planung von Entwickler-Inhalten.
Wichtiger Hinweis: Eine steigende Anzahl von Beiträgen bedeutet nicht zwangsläufig, dass das allgemeine Interesse zunimmt; sie kann auch auf Änderungen des Abdeckungsbereichs oder der Filterregeln zurückzuführen sein. Trendfolgerungen sollten auf vergleichbaren Daten beruhen.
¶ Szenario fünf: KI-Evaluierungen erstellen, die realen Diskussionen näherkommen
Community-Inhalte enthalten kurze Antworten, vage Verweise, Korrekturen früherer Aussagen und Meinungsverschiedenheiten und eignen sich zur Gestaltung von Aufgaben zum Kontextverständnis. Nach Einholung entsprechender Genehmigungen und Abschluss der Annotation können folgende Themen untersucht werden:
| Evaluierungsaufgabe | Zu prüfende Fähigkeit |
|---|---|
| Beurteilung der Antwortrelevanz | Ob der Kommentar tatsächlich auf die Frage eingeht |
| Erkennung der Kommentarfunktion | Antworten, Rückfragen, Korrekturen und Widerlegungen unterscheiden |
| Kontextverständnis | Verstehen, worauf sich „diese Methode“ und „die vorherige Lösung“ beziehen |
| Zusammenfassung mehrerer Perspektiven | Unterschiedliche Standpunkte und ihre Anwendungsbedingungen beibehalten |
| Retrieval-Evaluierung | Diskussionsabschnitte zurückfinden, die zur Unterstützung einer Antwort ausreichen |
Geeignete Projekte: Evaluierung von Frage-Antwort-Systemen, Evaluierung von Zusammenfassungsmodellen, Forschung zum Diskussionsverständnis.
Wichtiger Hinweis: Rohkommentare sind keine natürlichen Standardantworten. Fakten müssen überprüft, Annotationsrichtlinien erstellt und Informationslecks vermieden werden, die dadurch entstehen, dass dieselbe Diskussion in Trainings- und Testdaten aufgeteilt wird.
¶ Szenario sechs: Wiederholte Fragen und Probleme mit der Inhaltsqualität erkennen
Für Forschung zum Community-Betrieb und zur Inhaltsgovernance können inhaltsbezogen ähnliche Fragen geclustert, wiederholte Fragen entdeckt, Abschweifungen und informationsarme Kommentare erkannt, Werbung und Spam klassifiziert sowie Verzeichnisse häufig gestellter Fragen erstellt werden.
Wenn mehrere Beiträge wiederholt dieselbe Art von Konfigurationsfrage stellen, können sie als FAQ-Hinweise zusammengestellt werden, um Teams dabei zu helfen, fehlende Erklärungen in der Dokumentation zu entdecken.
Geeignete Projekte: Community-Wissensmanagement, Dokumentationsoptimierung, Forschung zur Inhaltsqualität.
Wichtiger Hinweis: Vorrangig Analysen auf Inhalts- und Aggregationsebene einsetzen und unnötige Personenprofile vermeiden; das Entfernen von Benutzernamen bedeutet auch nicht, dass der Textkörper bereits anonymisiert wurde.
¶ V. Wie wählt man Daten aus, die wirklich zum Projekt passen?
Bei großen Datenmengen ist der wirksamste Ausgangspunkt oft die klare Festlegung von Grenzen, anstatt den Umfang zu erweitern. Die Serviceseite führt Auswahlmöglichkeiten für den Umfang auf, etwa die Filterung nach Bereichen, den Ausschluss von NSFW- und nicht mehr verfügbaren Inhalten sowie die Filterung nach der Anzahl der Kommentare eines Beitrags; die konkreten Regeln und Ergebnisse müssen je Batch überprüft werden.[1]
¶ 1. Zuerst das Thema wählen, dann den Umfang betrachten
Wenn das Ziel technische Fragen und Antworten sind, sollten zunächst die relevanten Bereiche und Fragetypen überprüft werden; wenn das Ziel Produktforschung ist, sollten Inhalte mit Nutzungshintergrund, konkreten Schwierigkeiten und Alternativen vorrangig gesucht werden. Gehen Sie nicht allein deshalb davon aus, dass eine bestimmte Teilmenge für die aktuelle Aufgabe geeignet ist, weil sie groß ist.
¶ 2. Zuerst die gültigen Inhalte prüfen, dann die Interaktionszahlen
Eine hohe Anzahl an Kommentaren kann bedeuten, dass die Informationen reichhaltig sind, sie kann aber auch auf intensive Kontroversen oder eine große Menge an Abschweifungen hindeuten. Die aktuelle Feldreferenz führt weder Like-Bewertungen, Aufrufzahlen noch eine Markierung für „beste Antwort“ auf, daher kann nicht davon ausgegangen werden, dass hochwertige Inhalte anhand dieser Kennzahlen gefiltert werden können.[2]
Ein sicherer Ansatz ist, die Qualität anhand von Relevanz, Vollständigkeit der Informationen, Quelle und manuellen Stichproben zu beurteilen.
¶ 3. Zuerst Beziehungen überprüfen, dann kontextbezogene Anwendungen aufbauen
Wenn ein Projekt von Diskussionsbäumen abhängt, sollte besonders geprüft werden, ob übergeordnete Beiträge oder Kommentare gefunden werden können, ob Antwortketten unterbrochen sind, ob gelöschte Inhalte das Verständnis beeinträchtigen, ob die zeitliche Reihenfolge nutzbar ist und ob der Kontext nach der Entfernung von Identitätsinformationen weiterhin ausreichend ist.
„Das Vorhandensein eines übergeordneten Feldes“ und „die vollständige Rekonstruktion einer Diskussion“ sind zwei unterschiedliche Abnahmeziele.
¶ VI. Von Stichproben zur Anwendung: ein umsetzbarer Implementierungspfad
¶ Erster Schritt: Das Geschäftsziel in einem Satz beschreiben
Beispiel: „Aufbau eines Retrieval-Assistenten für Webentwicklungsfragen, der Originalfragen und relevante Antworten beibehält, das Filtern nach Bereichen und Zeit unterstützt und in Antworten nachvollziehbare Belege bereitstellt.“
Im Vergleich zu „Wir benötigen eine Reihe von Reddit-Daten“ ermöglicht eine solche Beschreibung leichter einen klaren Datenumfang und Abnahmekriterien.
¶ Zweiter Schritt: Öffentliche Stichproben ansehen und dann repräsentative Validierungsstichproben beantragen
Das öffentliche Beispielpaket bietet 5 Vorschau-Datensätze sowie JSON, CSV, Feldreferenz und README und kann zum ersten Verständnis der Datenform verwendet werden, reicht jedoch nicht aus, um die Gesamtqualität zu bewerten.[2]
Öffentliches Beispielpaket des Reddit-Datensatzes herunterladen
Nach Eintritt in die formelle Validierung wird empfohlen, fehlende Felder, doppelte Inhalte, den Anteil gültiger Haupttexte, die Erfolgsrate der Antwortzuordnung sowie die Abdeckung der Zielthemen zu prüfen.
¶ Dritter Schritt: Einen Prozess für Bereinigung und Kontextverarbeitung aufbauen
Ein referenzierbarer technischer Prozess ist:
Datenanbindung → Feldvalidierung → Deduplizierung und Filterung → Datenschutzverarbeitung → Rekonstruktion von Antwortbeziehungen → Organisation der Aufgabendaten → Indizierung oder Analyse → Qualitätsbewertung
Verschiedene Aufgaben können unterschiedliche Organisationsformen verwenden: RAG organisiert Retrieval-Einheiten nach Fragen und zugehörigen Antwortketten; Zusammenfassungen behalten die Hauptzweige bei und kontrollieren die Kontextlänge; Bedarfsforschung aggregiert ähnliche Fragen und Nutzungsbeschränkungen; Modellevaluierungen teilen Daten nach vollständigen Diskussionen auf und ergänzen manuelle Annotationen.
Dies sind Implementierungsempfehlungen auf der Anwendungsseite und nicht standardmäßig enthaltene Lieferprozesse des Dienstes.
¶ Vierter Schritt: Mit Geschäftskennzahlen validieren, statt nur Importmengen zu zählen
| Anwendungsrichtung | Empfohlene Kennzahlen |
|---|---|
| Wissensretrieval | Abruf relevanter Inhalte, Hinlänglichkeit der Belege, Nachvollziehbarkeit der Antworten |
| Diskussionszusammenfassung | Abdeckung von Standpunkten, faktische Konsistenz, Erhalt von Kontroversen |
| Produktforschung | Gültige Bedarfshinweise, Bestehensquote der manuellen Prüfung |
| Analyse der Diskussionsstruktur | Erfolgsrate der Eltern-Kind-Zuordnung, Anteil gültiger Antwortketten |
| Modellevaluierung | Konsistenz der Annotationen, Vielfalt der Stichproben, Leakage-Prüfung |
Erst wenn Daten die tatsächlichen Aufgabenergebnisse verbessern, wird Umfang wirklich in Wert umgewandelt.
¶ VII. Vor der Nutzung Daten- und Rechtegrenzen bestätigen
Die Zugänglichkeit von Daten bedeutet nicht, dass sie für alle Zwecke genutzt werden dürfen.
Die Serviceseite weist ausdrücklich darauf hin: Die Anzeige im Katalog und der Zugriff auf öffentliche Vorschauen gewähren keine Rechte für Modelltraining, kommerzielle Nutzung oder Weiterverbreitung der vollständigen Datenmenge; Quelle, Lizenz und zulässige Verwendungszwecke der ausgewählten Version müssen vor der Lieferung bestätigt werden.[1]
Es wird empfohlen, vor Projektbeginn Folgendes klarzustellen:
- Versionsumfang: Welche Bereiche, Zeiträume und Sprachen abgedeckt sind;
- Lieferumfang: Anzahl der Datensätze, tatsächliche Felder, Formate und Komprimierungsweise;
- Qualitätsdefinition: Wie gültige Datensätze, ungültige Inhalte und vollständige Diskussionen definiert werden;
- Datenschutzverarbeitung: Wie Benutzernamen, persönliche Informationen im Text und gelöschte Inhalte behandelt werden;
- Nutzungsberechtigung: Ob interne Analysen, Retrieval-Anzeige, Training und kommerzielle Anwendungen erlaubt sind;
- Wartungsmechanismus: Ob Aktualisierungen bereitgestellt werden und wie Löschungen und Korrekturen synchronisiert werden.
Zugleich handelt es sich bei dieser Seite um einen Datenkatalog und eine Bedarfsberatung; es sollte nicht daraus geschlossen werden, dass sie eine Echtzeit-Reddit-API oder ein fortlaufendes Aktualisierungsabonnement umfasst.[2]
¶ Schlusswort: KI soll Standpunkte verstehen – und auch die Beziehungen zwischen ihnen
Der Wert von Community-Diskussionen liegt nicht nur darin, was Nutzer gesagt haben, sondern auch darin, warum sie Fragen stellen, unter welchen Bedingungen sie eine bestimmte Lösung akzeptieren und wie Antworten durch Nachfragen und Widerlegungen schrittweise geklärt werden.
Für KI-Anwendungen hilft der Erhalt dieser Beziehungen dabei, isolierte Texte in eine Informationsgrundlage mit mehr Kontext zu verwandeln. Der Ace Data Cloud Reddit-Datensatz bietet einen Einstiegspunkt für die Erkundung solcher Anwendungen.
Unabhängig davon, ob das Ziel Wissensretrieval, Diskussionszusammenfassung, Forschung zu Nutzerbedürfnissen oder Modellevaluierung ist, wird empfohlen, denselben Weg zu gehen: Zuerst die Aufgabe klar definieren, dann die Stichproben validieren; zuerst Qualität und Lizenz bestätigen, dann den Anwendungsumfang erweitern.
KI Diskussionen verstehen zu lassen bedeutet nicht nur, sie mehr Text lesen zu lassen, sondern sie genauer verstehen zu lassen: Worauf eine Antwort reagiert und unter welchen Bedingungen ein Standpunkt gilt.
¶ Exploration beginnen
- Einführung zum Reddit-Datensatz ansehen
- Ace Data Cloud kontaktieren, um Datenumfang und Nutzungsanforderungen zu besprechen
¶ Quellen
[1] Einführung in den Ace Data Cloud Reddit-Datensatzdienst。
[2] Öffentliches Beispielpaket des Reddit-Datensatzes, einschließlich Feldreferenz, Vorschau-Daten und README.
Bildhinweis: Titelbild und Abbildungen im Text sind KI-generierte Konzeptentwürfe und stellen weder tatsächliche Datenscreenshots noch bereits ausgelieferte Produktoberflächen dar. Die Größenangabe auf dem Titelbild ist eine geschätzte Katalogregistrierung; die konkrete Version, der Lieferumfang und die Nutzungslizenz müssen bestätigt werden. Das Reddit-Logo wird zur Kennzeichnung des in diesem Artikel behandelten Objekts verwendet und bedeutet keine Zusammenarbeit oder Unterstützung.