
¶ أولًا، لماذا لا يحتاج الذكاء الاصطناعي إلى المزيد من النصوص فحسب؟
"هذا الحل غير مناسب لبيئة الإنتاج."
إذا رأى الذكاء الاصطناعي هذه الجملة فقط، فمن الصعب عليه تحديد ما الذي تنفيه بالضبط: هل هي تقنية، أم طريقة نشر، أم حل تنفيذ ضمن شروط محددة؟
لكن إذا أُضيف السياق السابق، فقد يصبح المعنى أوضح بكثير:
السؤال: أريد إنشاء خدمة لمشاركة الملفات، هل يمكنني تخزين الملفات المرفوعة مباشرة داخل الحاوية؟
الإجابة: يمكن ذلك للتحقق قصير المدى، لكن يجب مراعاة الاحتفاظ بالبيانات بعد إعادة إنشاء الحاوية.
سؤال متابعة: وماذا إذا كان الهدف هو الإطلاق الرسمي؟
إضافة: عندها يجب النظر بشكل إضافي في الاستمرارية والنسخ الاحتياطي والتوسع، ولا يمكن الاكتفاء باتباع ممارسات مرحلة النموذج الأولي.
ما سبق حوار توضيحي لشرح دور السياق، وليس سجلًا أصليًا من مجموعة البيانات.
في هذا المثال، المعرفة الجديرة بالاستخراج حقًا ليست مجرد "يمكن" أو "لا يمكن"، بل هي ضمن أي شروط يكون الحل صالحًا، وفي أي حالات يحتاج إلى تعديل.
وهذه أيضًا القيمة الفريدة لبيانات نقاشات المجتمع: فهي لا تحمل الاستنتاجات فحسب، بل تسجل أيضًا خلفية طرح الأسئلة، والمفاضلات بين الحلول المختلفة، وعملية استكمال الآراء وتصحيحها. ولكي يستفيد الذكاء الاصطناعي من محتوى المجتمع بصورة أفضل، لا يكفي تقسيم المنشورات والتعليقات إلى مقاطع نصية، بل يلزم أيضًا الحفاظ قدر الإمكان على العلاقات بينها.
¶ ثانيًا، التعرّف على مجموعة بيانات Ace Data Cloud Reddit
تنظم مجموعة بيانات Reddit Posts & Comments (منشورات وتعليقات Reddit) من Ace Data Cloud المحتوى حول منشورات المنتدى والتعليقات والردود متعددة المستويات، وتحافظ على الأقسام التابعة وعلاقات الأصل والفرع، وتدعم اختيار نطاق البيانات وفق موضوعات النقاش وشروط المحتوى.[1]
وهي لا تهتم فقط بـ "ما النصوص الموجودة"، بل تشمل أيضًا:
- إلى أي قسم نقاش تنتمي هذه القطعة من المحتوى؛
- ما السؤال الذي طرحه المنشور الأصلي؛
- هل يرد التعليق على المنشور أم على تعليق آخر؛
- كيف تستكمل الردود اللاحقة الآراء السابقة أو تشكك فيها أو توسعها.
¶ حجم البيانات والمعاينة العامة
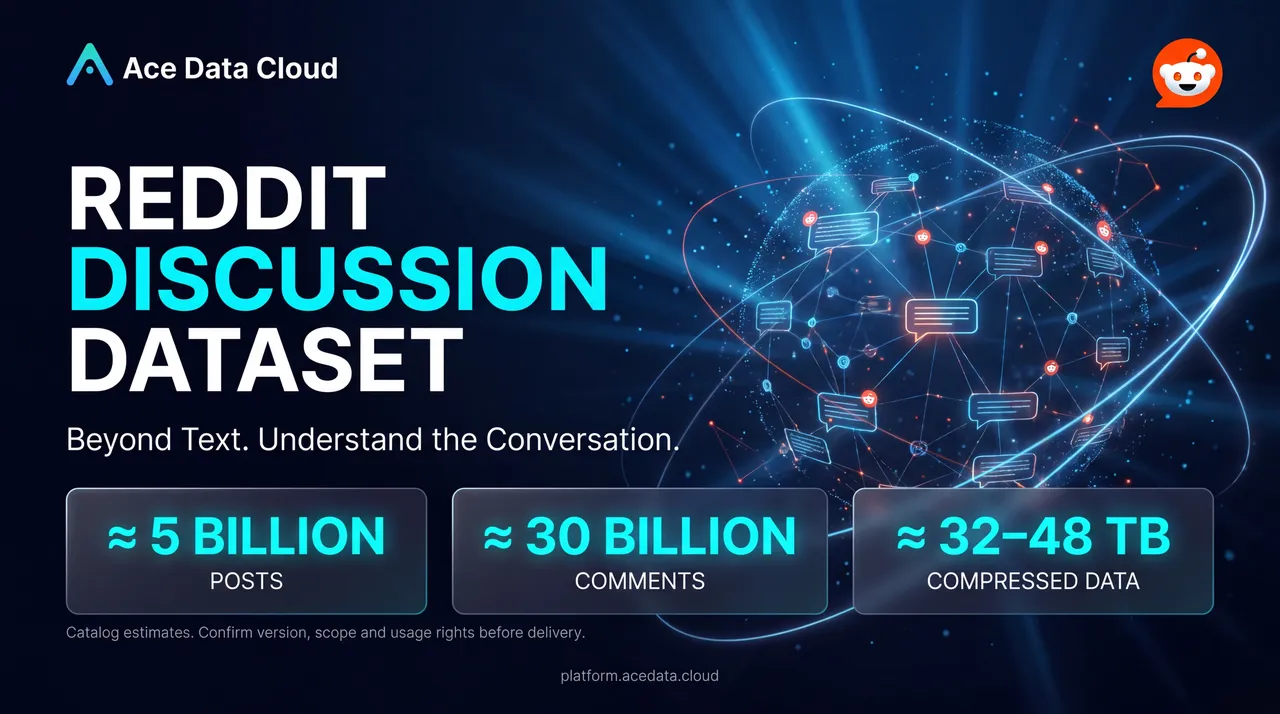
تظهر معلومات التسجيل في الدليل المعروضة على صفحة الخدمة كما يلي. هذه الأرقام تخص معيار حجم الدليل، بينما يظل العدد والحجم والنطاق الفعلي القابل للتسليم بحاجة إلى التأكيد وفق الإصدار المحدد.[1]
| البعد | وصف الدليل |
|---|---|
| حجم المنشورات | نحو 5 مليارات سجل (5 billion) |
| حجم التعليقات | نحو 30 مليار سجل (30 billion) |
| الحجم المضغوط | نحو 32–48 TB |
| المعاينة العامة | 5 سجلات معاينة، دون مقتطفات صور |
| المواد المرافقة | مرجع الحقول وREADME بالصينية والإنجليزية |
| طريقة الحصول | الاطلاع على العينة أولًا، ثم تأكيد الإصدار والنطاق والترخيص والسعر |
بالنسبة إلى مشروع محدد، فإن السؤال الأكثر أهمية ليس "كم يبلغ إجمالي البيانات"، بل: كم يبلغ حجم البيانات المرتبطة بالعمل، والفعالة من حيث المحتوى، والقابلة لاستعادة العلاقات، والتي يتوافق ترخيصها مع الاستخدام المقصود.
فعلى سبيل المثال، عند بناء مساعد سؤال وجواب موجه لتطوير الويب، ينبغي عادةً إعطاء الأولوية لتغطية الموضوعات وجودة الإجابات في الأقسام ذات الصلة، بدل السعي مباشرةً وراء أكبر حجم من البيانات.
¶ ثالثًا، بنية البيانات: إعادة النص إلى سياق النقاش
يمكن البدء في فهم مجموعة البيانات هذه من ثلاثة مستويات: المنشورات والتعليقات وعلاقات الردود.

رسم توضيحي مفاهيمي: لا يمكن فهم السياق بصورة أفضل إلا بالحفاظ على علاقات النقاش.
¶ 1. المنشورات: فهم من أين يبدأ السؤال
توفر المنشورات عادةً موضوع النقاش والخلفية الأولية. يسرد مرجع الحقول في حزمة العينات العامة حقولًا مثل معرّف المنشور، والقسم، والوقت، والعنوان، والنص الأساسي، والوسوم، والرابط الأصلي.[2]
| الحقل | المعنى | القيمة التطبيقية |
|---|---|---|
post.id |
معرّف المنشور | إزالة التكرار والفهرسة وربط التعليقات |
post.channel |
القسم التابع | تحديد نطاق المجال والمجتمع |
post.title |
عنوان المنشور | التعرف على الأسئلة واسترجاع الموضوعات |
post.text |
نص المنشور | استخراج المتطلبات والخلفية والقيود |
post.timestamp |
وقت المنشور | تصفية الوقت وتحليل الاتجاهات |
post.flair |
وسم المنشور | دعم التصنيف وتصفية المحتوى |
فعلى سبيل المثال، "كيف أخزّن مقالات المدونة" ليس سوى تلخيص للسؤال؛ أما حزمة التقنيات وطريقة التحرير ومتطلبات العرض المذكورة في النص، فقد تكون هي ما يحدد أي الاقتراحات تنطبق فعليًا.
¶ 2. التعليقات: ملاحظة الإجابات والخبرات والاختلافات
ليست التعليقات دائمًا إجابات مباشرة، بل قد تكون أيضًا أسئلة متابعة، أو تصحيحات، أو أمثلة مضادة، أو إضافات مبنية على الخبرة. يحتوي كائن التعليق في مرجع الحقول على معلومات مثل المعرّف والنص الأساسي والقسم والوقت ومعرّف الأصل. يُحفظ وقت التعليقات كنص رقمي، بينما يُشار إلى وقت المنشورات بوصفه ثواني Unix، لذا ينبغي التحقق من كل منهما على حدة وتوحيد التنسيق عند المعالجة.[2]
على مستوى التطبيق، يلزم إجراء تمييز إضافي بين: التعليقات التي تجيب مباشرةً عن السؤال، والاقتراحات التي لا تصح إلا ضمن شروط محددة، والمحتوى الذي يصحح الأخطاء السابقة، والمعلومات منخفضة القيمة أو التي خرجت عن الموضوع. ويتطلب هذا النوع من الأحكام عادةً تعاون القواعد والنماذج والمراجعة البشرية، ولا يمكن إنجازه بالاعتماد على عدد التعليقات وحده.
¶ 3. علاقات الأصل والفرع: تحديد "من يرد على من"
يُستخدم comments[].parent لتسجيل معرّف المنشور أو التعليق الأصلي، مع الاحتفاظ بالبادئات t1_ وt3_. وهو يوفر أساسًا للربط من أجل استعادة علاقات الردود، لكن اكتمال الربط في الإصدار المحدد يظل بحاجة إلى التحقق عبر العينات.[2]
بالنسبة إلى تطبيقات الذكاء الاصطناعي، يعني ذلك إمكانية محاولة الانتقال من "استرجاع التعليقات المستقلة" إلى "استرجاع سلاسل الردود المصحوبة بالسياق".
ينبغي ملاحظة أن مرجع الحقول لا يساوي قائمة التسليم الفعلية لكل إصدار. تشير ملاحظات العينة إلى أن كائن المنشور قد يكون فارغًا، وأن النص الأساسي قد يكون مفقودًا أو يحمل علامة حذف، وأن أعمدة المعاينة العامة لا تتطابق تمامًا مع الحقول الأصلية.[2]
¶ رابعًا، من نقاشات المجتمع إلى تطبيقات الذكاء الاصطناعي: ستة سيناريوهات جديرة بالاستكشاف
تُطرح اتجاهات التطبيق التالية استنادًا إلى بنية البيانات، وهي أفكار للتنفيذ، ولا تعني أن خدمة البيانات تأتي مرفقة بالنماذج أو أنظمة التطبيقات المقابلة. ويتطلب التطبيق الفعلي أولًا تأكيد جودة البيانات ونطاق التغطية وترخيص الاستخدام.

¶ السيناريو الأول: استكمال خبرات المجتمع لقاعدة معرفة RAG
تتفوق الوثائق الرسمية في شرح الميزات والمعايير، بينما يمكن لنقاشات المجتمع أن تكمل المشكلات والمفاضلات في الاستخدام الفعلي: لماذا لا يناسب حل معين بيئة محددة، وكيفية اختيار الأدوات عند مواجهة قيود مختلفة، وما هي الأمثلة المضادة والشروط الإضافية التي تتضمنها نصيحة ما.
عند بناء نظام التوليد المعزز بالاسترجاع (RAG)، يمكن دمج عنوان المنشور + خلفية السؤال + التعليقات ذات الصلة + الردود السابقة الضرورية كوحدة استرجاع.
على سبيل المثال، عندما يسأل المستخدم: «هل ينبغي للمدونة الشخصية استخدام قاعدة بيانات أم ملفات Markdown؟»، لا ينبغي للنظام أن يعيد اسم أداة فحسب، بل ينبغي أن يسترجع النقاشات المتعلقة بشروط مثل وتيرة التحرير، والتعاون بين عدة أشخاص، وطريقة النشر، ثم ينظم الإجابة.
المشاريع المناسبة: مساعدو المطورين، وأدوات الاختيار التقني، وأنظمة الأسئلة والأجوبة المعرفية المتخصصة.
النصيحة الأساسية: اعرض خبرات المجتمع والمواد الموثوقة بشكل منفصل؛ وعندما تتعلق الإجابة بالإصدار أو الأداء أو الأمان، ينبغي التحقق منها بشكل إضافي.
¶ السيناريو الثاني: تنظيم النقاشات الطويلة في ملخصات متعددة الآراء
في نقاش طويل واحد، قد توجد في الوقت نفسه آراء مؤيدة، وأسباب معارضة، وشروط إضافية، وأسئلة لم تُحل. وإذا كان الملخص العادي مضغوطًا بشكل مفرط، فمن السهل أن يكتب المحتوى المثير للجدل على أنه نتيجة متفق عليها.
بعد الاحتفاظ بعلاقات الردود، يمكن تنظيم الملخص حول الهيكل التالي:
- السؤال الأصلي والقيود المعروفة؛
- الحلول المرشحة الرئيسية؛
- أسباب دعم الحلول المختلفة؛
- الآراء المعارضة وحدود التطبيق؛
- المسائل التي لا تزال بحاجة إلى التحقق.
باستخدام «هل يجب بناء تخزين الملفات ذاتيًا» كمثال، فإن هدف الملخص ليس إخراج «ينبغي» أو «لا ينبغي» ببساطة، بل توضيح: ما الاختلافات التي يجب أخذها في الاعتبار في ظل ظروف مختلفة مثل التحقق من النموذج الأولي، والمشاريع الشخصية، والخدمات الرسمية.
المشاريع المناسبة: مساعدو قراءة المجتمع، والملخصات الموجزة للأبحاث التقنية، وأدوات استخلاص النقاشات.
النصيحة الأساسية: احتفظ باختلافات الآراء، واحتفظ بأساس محتوى قابل للتتبع للاستنتاجات المهمة.
¶ السيناريو الثالث: اكتشاف إشارات احتياجات المنتج من أسئلة المستخدمين
غالبًا لا تظهر احتياجات المنتج في شكل وثائق متطلبات معيارية، بل تختبئ في حيرة المستخدمين وشكاواهم: «هل توجد طريقة أبسط؟» «لماذا يجب الاعتماد على هذه الخدمة؟» «أنا فقط أنفذ مشروعًا صغيرًا، فهل أحتاج إلى هذا التعقيد؟»
في المعاينة العامة، يتناول منشور «كيفية تخزين مقالات المدونة» مسائل مثل قواعد البيانات وMarkdown وطرق عرض المقالات.[1]
يمكن لفريق المنتج أن يشكل بناءً على ذلك فرضيات تحتاج إلى التحقق: قد يفتقر المستخدمون إلى تدفق كامل من الكتابة إلى النشر، وقد لا يكونون واضحين بشأن حدود تطبيق قواعد البيانات وإدارة الملفات، وقد يرغبون أيضًا في تقليل تكلفة إعداد إدارة المحتوى. بعد ذلك، يتم التحقق من خلال المزيد من النقاشات المماثلة أو المقابلات أو بيانات المنتج.
المشاريع المناسبة: أدوات المطورين، وأنظمة إدارة المحتوى، وأبحاث احتياجات الخدمات السحابية والبرمجيات المتخصصة.
النصيحة الأساسية: تعامل مع نقاشات المجتمع باعتبارها مواد بحث نوعي، ولا تعمم عددًا قليلًا من المنشورات مباشرةً على نسبة الطلب في السوق بأكمله.
¶ السيناريو الرابع: دراسة التغيرات في الموضوعات التقنية واهتمامات المجتمع
على فرض استمرارية النطاق الزمني وقابلية مقارنة معايير الجمع، يمكن ملاحظة ما إذا كانت النقاشات تنتقل من «ما هذا؟» إلى «كيف يتم النشر»، وما اختلاف الصعوبات التي تهم مجتمعات المبتدئين والمجتمعات المهنية، وما الشروط التي يوليها المستخدمون اهتمامًا متزايدًا عند مقارنة الحلول البديلة.
المشاريع المناسبة: أبحاث الاتجاهات التقنية، وتشغيل المجتمعات، وتخطيط محتوى المطورين.
النصيحة الأساسية: زيادة عدد المنشورات لا تعني بالضرورة ارتفاع مستوى الاهتمام العام، فقد تنتج أيضًا عن تغيرات في نطاق التغطية أو قواعد التصفية. وينبغي أن تستند استنتاجات الاتجاهات إلى بيانات قابلة للمقارنة.
¶ السيناريو الخامس: بناء تقييمات للذكاء الاصطناعي أقرب إلى النقاشات الحقيقية
يتضمن محتوى المجتمع ردودًا قصيرة، وإشارات مبهمة، وتصحيحًا لما سبق، واختلافات في الآراء، وهو مناسب لاستخدامه في تصميم مهام فهم السياق. وبعد الحصول على الأذونات المناسبة وإتمام الوسم، يمكن دراسة:
| مهمة التقييم | القدرات التي يجب اختبارها |
|---|---|
| الحكم على صلة الرد | ما إذا كان التعليق يستجيب فعليًا للسؤال |
| تحديد وظيفة التعليق | التمييز بين الإجابة، والاستيضاح، والتصحيح، والدحض |
| فهم السياق | فهم ما الذي تشير إليه «هذه الطريقة» و«الحل السابق» |
| التلخيص متعدد الآراء | الاحتفاظ بالمواقف المختلفة وشروط انطباقها |
| تقييم الاسترجاع | استرجاع مقاطع النقاش الكافية لدعم الإجابة |
المشاريع المناسبة: تقييم أنظمة الأسئلة والأجوبة، وتقييم نماذج التلخيص، وأبحاث فهم النقاشات.
النصيحة الأساسية: التعليقات الأصلية ليست إجابات معيارية بطبيعتها. يلزم التحقق من الحقائق، ووضع معايير للوسم، وتجنب تسريب المعلومات الناتج عن تقسيم النقاش نفسه بين مجموعة التدريب ومجموعة الاختبار.
¶ السيناريو السادس: تحديد الأسئلة المكررة ومشكلات جودة المحتوى
بالنسبة إلى تشغيل المجتمع وأبحاث حوكمة المحتوى، يمكن إجراء تجميع للأسئلة المتشابهة، واكتشاف الأسئلة المكررة، وتحديد التعليقات الخارجة عن الموضوع ومنخفضة المعلومات، وتصنيف الإعلانات والمحتوى المزعج، وتنظيم فهرس للأسئلة الشائعة حول المحتوى.
عندما تسأل منشورات متعددة بشكل متكرر عن النوع نفسه من مسائل الإعداد، يمكن تنظيمها كإشارات للأسئلة الشائعة، لمساعدة الفريق على اكتشاف التفسيرات المفقودة في الوثائق.
المشاريع المناسبة: إدارة معرفة المجتمع، وتحسين الوثائق، وأبحاث جودة المحتوى.
النصيحة الأساسية: أعطِ الأولوية للتحليل على مستوى المحتوى والمستوى التجميعي، وتجنب التنميط الشخصي غير الضروري؛ وإزالة أسماء المستخدمين لا تعني أن النص الأساسي قد أصبح مجهول الهوية.
¶ خامسًا: كيف تختار البيانات المناسبة فعليًا للمشروع؟
عند مواجهة بيانات واسعة النطاق، غالبًا ما تكون نقطة البداية الأكثر فعالية هي تحديد الحدود، وليس توسيع النطاق. تعرض صفحة الخدمة طرق اختيار النطاق، مثل التصفية حسب القسم، واستبعاد محتوى NSFW والمحتوى غير الصالح، والتصفية حسب عدد تعليقات المنشور، بينما تحتاج القواعد والتأثيرات المحددة إلى التحقق على دفعات.[1]
¶ 1. اختر الموضوع أولًا، ثم انظر إلى الحجم
如果目标是技术问答,应先验证相关板块和问题类型;如果目标是产品研究,则应优先寻找包含使用背景、具体困难和替代方案的内容。不要因为某个子集数量大,就默认它适合当前任务。
¶ 2. 先看有效内容,再看互动数量
高评论量可能意味着信息丰富,也可能意味着争论激烈或大量跑题。当前字段参考没有列出点赞分数、浏览量或“最佳答案”标记,不能默认可以按这些指标筛选高质量内容。[2]
更稳妥的做法是结合相关性、信息完整度、来源和人工抽查判断质量。
¶ 3. 先验证关系,再构建上下文应用
如果项目依赖讨论树,应重点检查父级帖子或评论能否找到、回复链是否中断、删除内容是否影响理解、时间顺序是否可用,以及去除身份信息后上下文是否仍然足够。
“存在父级字段”和“能够完整还原讨论”是两个不同的验收目标。
¶ 六、从样本到应用:一条可执行的落地路径
¶ 第一步:用一句话说明业务目标
例如:“构建面向 Web 开发问题的检索助手,保留原始问题与相关回复,支持按板块和时间筛选,并在回答中提供可追溯依据。”
比起“需要一批 Reddit 数据”,这样的描述更容易形成清晰的数据范围和验收标准。
¶ 第二步:查看公开样本,再申请代表性验证样本
公开样例包提供 5 条预览记录,以及 JSON、CSV、字段参考和 README,可用于初步了解数据形式,但不足以评估整体质量。[2]
进入正式验证后,建议检查字段缺失、重复内容、有效正文比例、回复关联成功率及目标主题覆盖情况。
¶ 第三步:建立清洗与上下文处理流程
一个可参考的工程流程是:
数据接入 → 字段校验 → 去重与过滤 → 隐私处理 → 回复关系重建 → 任务数据组织 → 索引或分析 → 质量评估
不同任务可以采用不同的组织方式:RAG 按问题与相关回复链组织检索单元;摘要保留主要分支并控制上下文长度;需求研究聚合相似问题和使用约束;模型评测按完整讨论划分数据,并增加人工标注。
这是应用侧的实施建议,而非服务默认包含的交付流程。
¶ 第四步:用业务指标验证,而不是只统计导入数量
| 应用方向 | 建议关注的指标 |
|---|---|
| 知识检索 | 相关内容召回、证据充分性、回答可追溯性 |
| 讨论摘要 | 观点覆盖、事实一致性、争议保留 |
| 产品研究 | 有效需求线索、人工复核通过情况 |
| 讨论结构分析 | 父子关联成功率、有效回复链比例 |
| 模型评测 | 标注一致性、样本多样性、泄漏检查 |
只有当数据改善了实际任务效果,规模才真正转化为价值。
¶ 七、使用前,确认数据与权利边界
数据可访问,不等于可以用于所有用途。
服务页面明确说明:目录展示与公开预览访问,并不授予全量数据的模型训练、商业使用或再分发权利;所选版本的来源、许可及允许用途,需要在交付前确认。[1]
建议在项目启动前明确:
- **版本范围:**覆盖哪些板块、时间段和语言;
- **交付内容:**记录数、实际字段、格式和压缩方式;
- **质量口径:**有效记录、失效内容及完整讨论如何定义;
- **隐私处理:**用户名、正文个人信息和删除内容如何处理;
- **授权用途:**是否允许内部分析、检索展示、训练及商业应用;
- **维护机制:**是否提供更新,以及删除、更正如何同步。
同时,该页面属于数据目录与需求咨询,不应据此假定包含实时 Reddit API 或持续更新订阅。[2]
¶ 结语:让 AI 理解观点,也理解观点之间的关系
社区讨论的价值,不只在于用户说了什么,还在于他们为什么提出问题、在什么条件下接受某个方案,以及如何通过追问和反驳逐渐澄清答案。
对于 AI 应用而言,保留这些关系,有助于将孤立文本转化为更有上下文的信息基础。Ace Data Cloud Reddit 数据集为探索这类应用提供了一个入口。
无论目标是知识检索、讨论摘要、用户需求研究,还是模型评测,都建议从同一条路径出发:先明确任务,再验证样本;先确认质量与许可,再扩展应用规模。
让 AI 读懂讨论,不只是让它读到更多文字,而是让它更准确地理解:一条回答在回应什么,一个观点在什么条件下成立。
¶ 开始探索
¶ 资料来源
[1] Ace Data Cloud Reddit 数据集服务介绍。
[2] Reddit 数据集公开样例包,包括字段参考、预览数据及 README。
配图说明:封面与文内配图为 AI 生成的概念设计,不代表实际数据截图或已交付产品界面。封面规模数字为目录登记估算,具体版本、交付范围和使用许可需确认。Reddit 标识用于标识本文讨论对象,不表示合作或背书。