
GPT-6 帶來的變化,不只是模型更聰明,而是我們可以更細地分配任務、控制推理投入、重複使用上下文。對於做內容和 GEO 的團隊來說,真正值得研究的不是「哪個模型最強」,而是怎樣讓檢索、寫作、核驗和發布這條流程更可靠,同時把每篇合格內容的成本降下來。
¶ 一、模型越來越強,為什麼內容還是不好用?
如果你用 AI 批量寫過文章,大機率遇到過這種情況:第一眼看,結構完整、語句順暢,連總結都挺像那麼回事。可認真檢查一下,就發現資料沒出處、產品版本對不上,或者寫了兩千字,還是沒回答讀者最關心的問題。
這時候,最容易想到的解決辦法就是:換一個更強的模型。
但我更建議先問一句:問題到底出在模型能力,還是工作流程?
如果沒有可靠資料,沒有清晰的任務邊界,也沒有發布前的核驗環節,換模型未必能解決根本問題。
OpenAI 的 GPT-6 使用指南實際上也沒有只圍繞「能力升級」展開,而是把模型選擇、推理等級、快取、上下文壓縮和多智慧體協作放在了一起討論。它強調的是:讓不同能力服務於具體任務,並在上線前衡量成功率、延遲和每次成功任務的成本。
對於內容團隊,這個思路很實用:別只想著讓 AI 寫得更多,先讓它交付得更穩。
¶ 二、Astra、Sol、Luna 怎麼選?把它們當成不同崗位
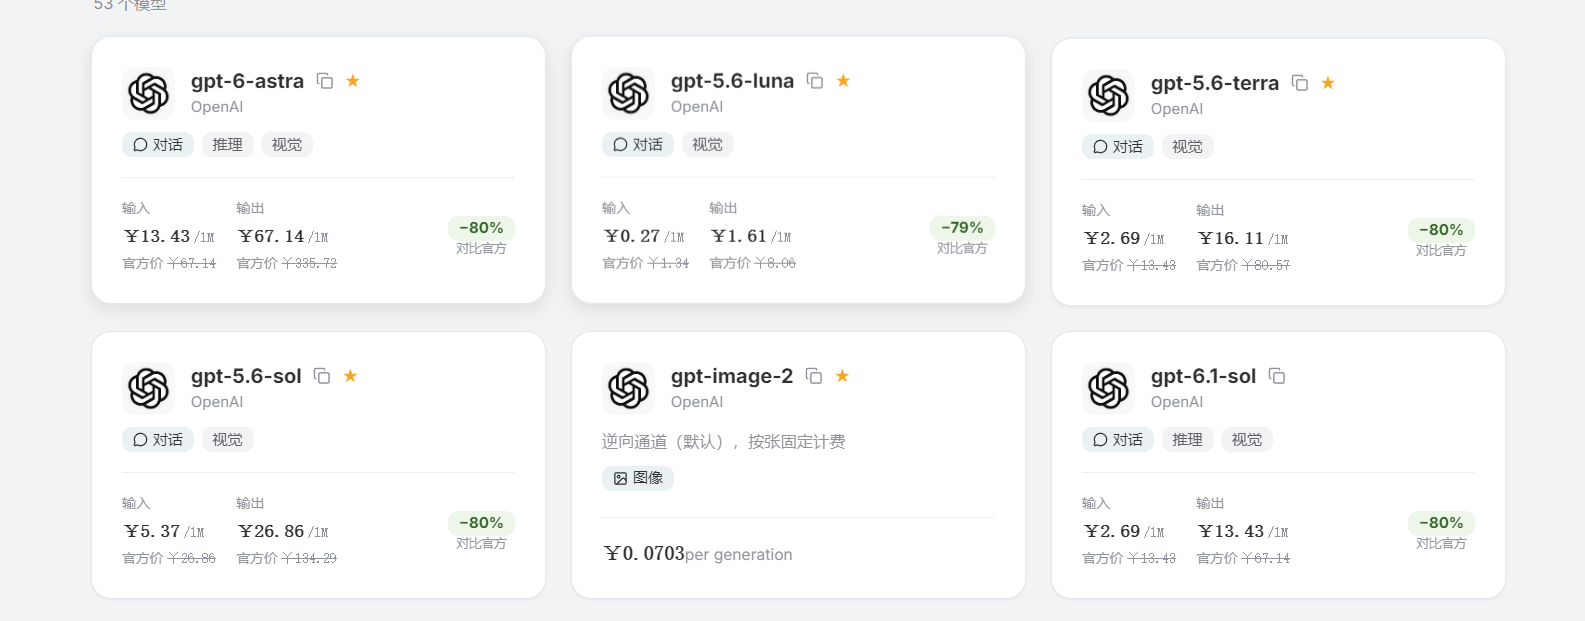
按照上述 OpenAI 官方指南的定位,GPT-6 Astra 面向最困難的推理工作;GPT-6.1 Sol 面向複雜編碼、研究和電腦操作;GPT-6 Luna 則更偏向目標明確、需要規模化處理的重複任務,例如欄位擷取、分類和結構化摘要。
與其死記參數,不如把它們理解成團隊裡的不同崗位。
下面這張表是結合內容業務給出的選型建議,並不是官方效能排名:
| 內容環節 | 建議優先評估的模型 | 主要考量 |
|---|---|---|
| 文章分類、欄位擷取、固定格式摘要 | GPT-6 Luna | 任務清楚,先看格式正確率和單位成本 |
| 多來源研究、資料整理、文章整合 | GPT-6.1 Sol | 需要跨資料判斷和多步驟執行 |
| 爭議分析、複雜論證、重點內容審查 | GPT-6 Astra | 錯誤代價更高,需要更深入的判斷 |
例如,我們準備寫一篇「企業如何選擇 AI 介面」的文章。擷取各家文件裡的價格和功能欄位,不必一開始就動用最強模型;分析不同方案在複雜業務中的取捨,則值得投入更多推理資源。
當然,這不是說「小模型負責的內容不用檢查」。價格、計費單位、版本號這類資訊,即便只是擷取,也可能出錯。
任務簡單,只代表處理方式可以更輕,不代表驗收標準可以更鬆。
¶ 三、推理等級不是越高越好,要看這一步值不值得
模型選好之後,還有一個容易被忽略的變數:推理投入。
OpenAI 的指南把推理等級描述為能力與價格之間的權衡:Low 對應常規擷取或小幅編輯,Medium 用於需要判斷的工作,High 用於深度分析和仔細審查;更高檔位則應在模型支援、且額外收益值得時間與成本時再使用。
說得直白一點:
- 改一個標題,沒必要讓模型反覆推演。
- 比較三種業務方案,可以多給一些思考空間。
- 判斷兩份資料是否存在實質衝突,值得認真分析。
可以從下面這套方式開始測試:
| 任務 | 建議起點 | 什麼時候升級 |
|---|---|---|
| 標籤歸類、格式轉換 | 低推理投入 | 出現明顯歧義或規則衝突 |
| 文章提綱、方案比較 | 中等推理投入 | 無法解釋取捨,遺漏關鍵條件 |
| 事實衝突分析、重要結論審查 | 高推理投入 | 仍未解決關鍵問題,再測試更高檔位 |
這裡有個重要區別:多想一會兒,不等於多知道一些事實。
如果任務需要最新價格或剛發布的產品資訊,首先要補齊來源,而不是單純提高推理等級。缺少證據時,最好的輸出可能是「這項資訊還無法確認」,而不是一段更流暢的猜測。
另外,上表是工作流程建議,不是通用 API 參數表。實際可用的檔位與參數名稱,要以具體模型和接入文件為準。
¶ 四、「快取省 95%」很吸引人,但別算錯帳
快取可能是批量內容生產中最值得關注的最佳化點之一。
品牌介紹、寫作規範、固定術語表、審核要求……這些材料經常在每次請求裡重複出現。OpenAI 建議把穩定指令和參考材料放在變化的任務細節之前,並保持工具定義一致,以便重複使用共享上下文。官方指南提到,快取輸入的費用相較未快取輸入最高可降低 95%,具體取決於模型。
但這裡一定要看清楚:
快取輸入便宜 95%,不等於整篇文章的生產成本下降 95%。 以官方公布的 GPT-6.1 Sol 標準 API 價格為例:每百萬輸入 token 為 2 美元,快取輸入為 0.10 美元,輸出為 10 美元。這裡引用的是 OpenAI 官方標準價格,不代表本站或第三方接入管道的實際報價,價格變動請以服務方最新頁面為準。
我們做一個示範算例,不是實測結果:
假設一次任務有:
- 20,000 個輸入 token;
- 其中 15,000 個可以命中快取;
- 3,000 個輸出 token。
| 費用項目 | 全部輸入未命中快取 | 15,000 個輸入命中快取 |
|---|---|---|
| 未快取輸入 | $0.0400 | $0.0100 |
| 快取輸入 | $0 | $0.0015 |
| 輸出 | $0.0300 | $0.0300 |
| 合計 | $0.0700 | $0.0415 |
按這個假設計算,token 費用下降約 40.7%,並不是 95%。
而且,這還沒有計入工具呼叫、失敗重試、人工審核,以及可能適用的其他費用。
所以,比較可靠的做法是把提示詞拆成兩層:
穩定層:品牌規範、寫作風格、輸出格式、審核規則。
動態層:本次主題、目標讀者、新檢索到的資料、目前任務要求。
然後觀察真實請求中的快取命中情況,而不是看到「最高優惠」就直接寫進專案預算。
¶ 五、多智慧體很適合做研究,但不適合為了熱鬧而分工
一篇研究型文章,往往包含幾個可以獨立推進的任務:
- 查官方文件;
- 找實際案例;
- 收集常見問題;
- 核對價格和功能;
- 整理不同來源之間的分歧。
這些任務有一定獨立性,適合平行處理。
OpenAI 的指南介紹,GPT-6.1 Sol 可以在 Responses API 中把獨立任務分派給子智慧體,再彙整結果;該多智慧體能力在指南中標註為 beta。
不過,多智慧體不是免費的效率提升。
Anthropic 在其研究系統的工程復盤中提到,多智慧體適合向多個獨立方向展開的研究,但會顯著增加 token 消耗;在他們觀察的資料裡,多智慧體系統的 token 使用量約為一般聊天的 15 倍。這個數字屬於其特定系統的經驗,不能直接套用到所有產品。
因此,我更建議這樣安排:
讓多個智慧體分別找證據,讓一個編輯統一組織文章,再由人工把關。
不要讓五個智慧體分別寫五段,然後直接拼起來。這樣很容易出現重複、矛盾和文風不一致。
下面是一個適合內容團隊起步的流程示意:
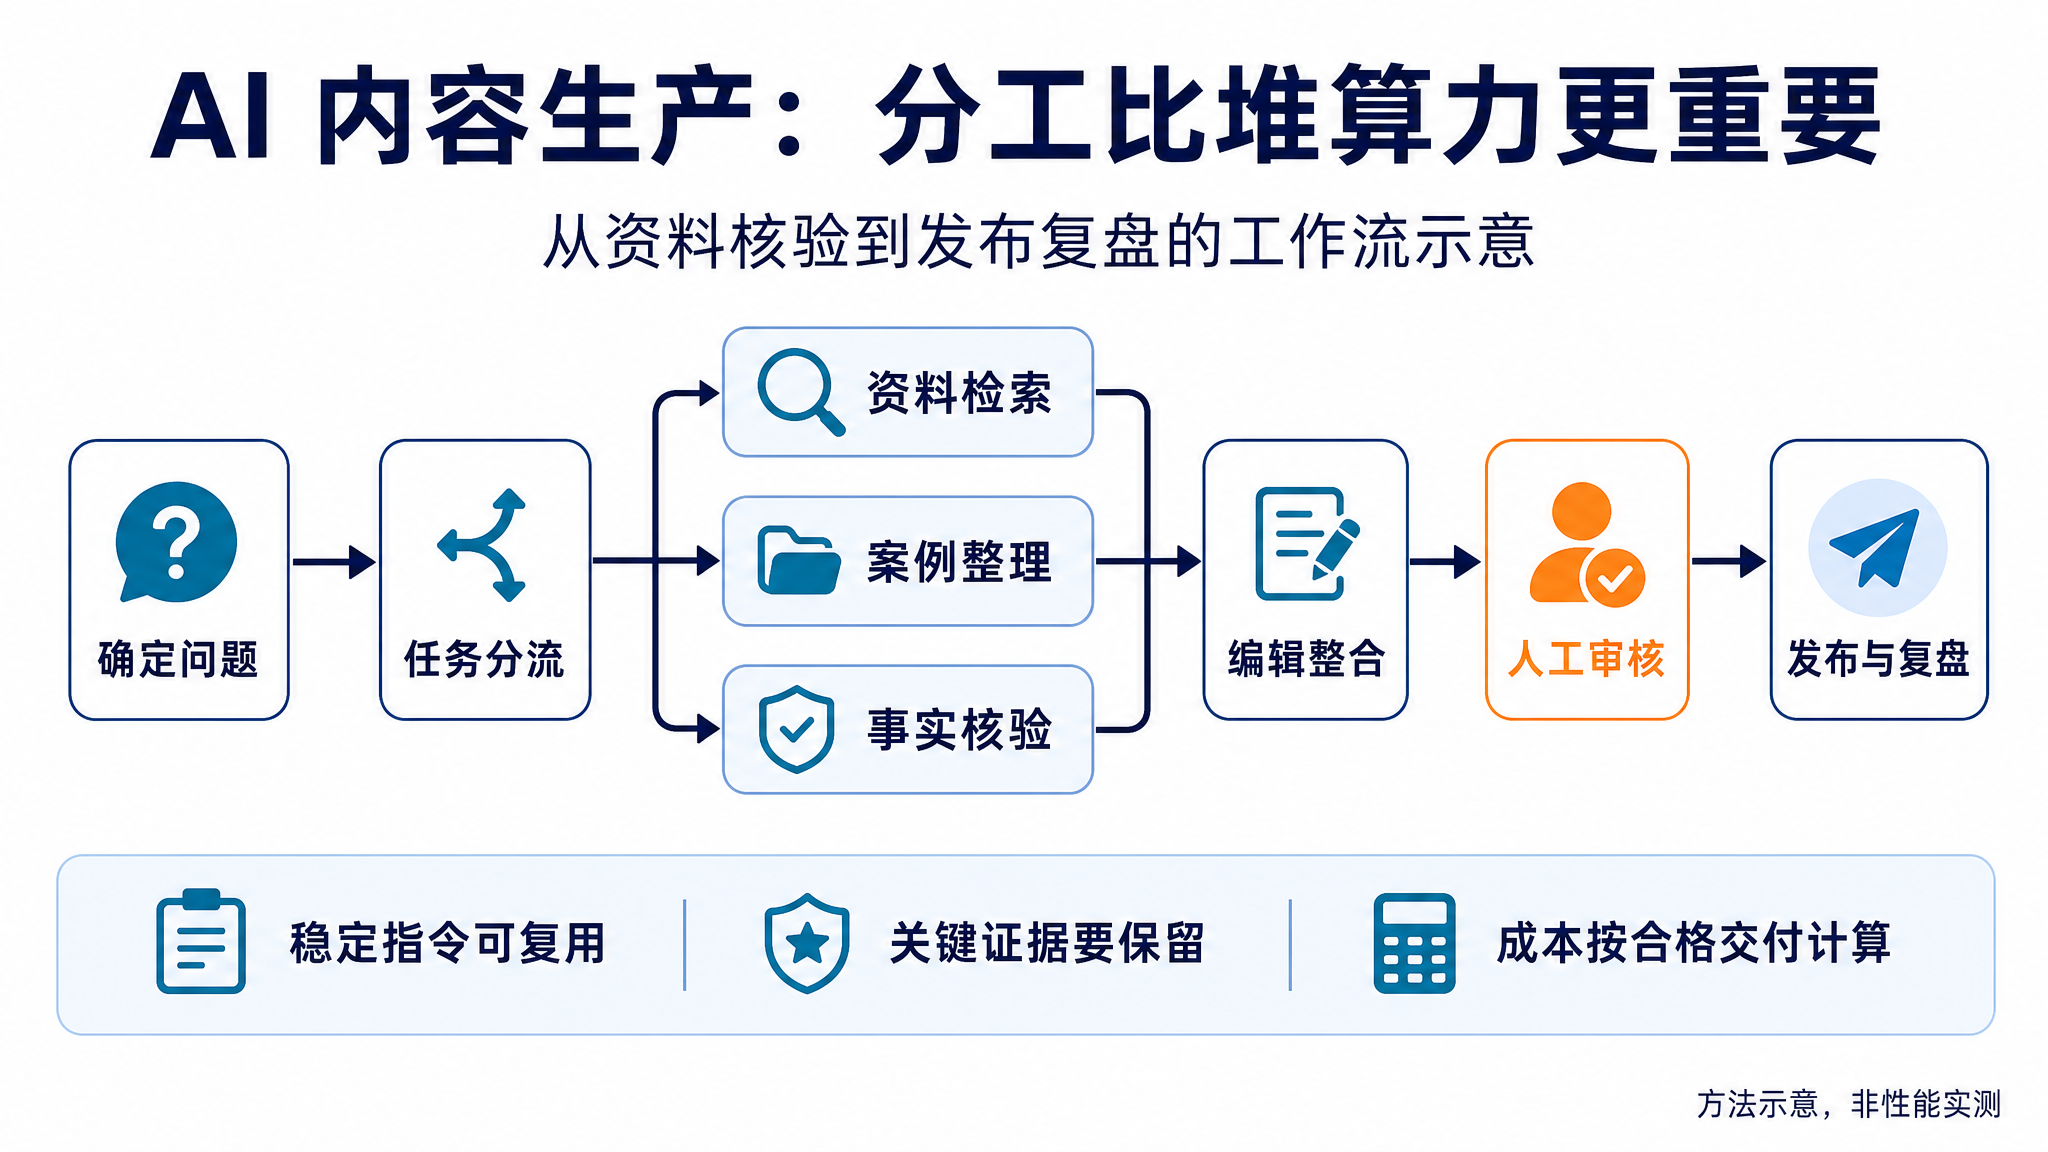
配圖為 GPT Image 2 生成的方法示意,不代表效能實測。
要讓這個流程真正有用,每個子任務最好交付四樣東西:
- 結論:發現了什麼。
- 來源:證據在哪裡。
- 限制:哪些情況不適用。
- 待確認項:還有什麼不能下結論。
特別要注意:事實核驗不是讓另一個模型「覺得這段話沒問題」,而是讓它重新對照來源。
多個智慧體意見一致,不等於事實已經被證明。
¶ 六、長任務要保存狀態,自動操作要劃清權限
做一篇短文,把資料放進上下文可能就夠了。做系列專題、持續維護產品文件,問題就不一樣了。
OpenAI 的指南介紹了上下文壓縮,用於減少長對話的上下文體積,同時保留繼續任務所需的狀態。
對於內容工作,我建議無論採用哪種壓縮方式,都單獨維護一份任務記錄:
- 已確認的事實及其來源;
- 目前使用的產品版本;
- 尚未解決的資料衝突;
- 已完成和未完成的環節;
- 必須人工確認的決定。
不要只留下「我們已經研究過這個問題」這樣的模糊摘要。後續寫作真正需要的是證據和邊界。
自動操作也是一樣。官方指南建議,能用 API 或已連接工具直接完成的步驟,優先使用這些方式;需要讀取螢幕、點擊或填寫表單時,再考慮電腦操作能力。
對於部落格流程,可以允許 AI 自動整理草稿、檢查連結、生成配圖,但把正式發布、刪除文章和修改線上設定放在人工確認之後。
會操作後台,不代表應該擁有無限權限。
¶ 七、回到 GEO:寫得更快,不等於更容易被 AI 引用
說到這裡,需要把兩個問題分開:
- 用 AI 提高內容生產效率;
- 讓內容在生成式搜尋回答中更容易被發現和引用。
前者是工作流程問題,後者才是 GEO 關注的核心。
早期 GEO 研究圍繞生成式引擎中的內容可見性展開,並報告了在其評測設定下最高約 40% 的可見性提升,同時指出不同領域的效果存在差異。這個結果不能直接理解為「照著做,本站流量就會漲 40%」。
Google 的官方說明則更務實:對於 AI Overviews 和 AI Mode,不需要一套額外的特殊最佳化要求;基礎 SEO、可靠且以人為本的內容,仍然重要。頁面要具備被索引和展示摘要的資格,才有機會作為支援連結出現。
這並不能代表所有 AI 搜尋產品的規則,但至少提醒我們:別急著尋找所謂的「萬用 GEO 範本」。 對於本站部落格,我更建議先把下面幾件事做好。
¶ 1. 一篇文章解決一個真實問題
「全面解析 AI 的未來」聽起來很大,卻不一定有用。
「批次生成產品文案,怎樣判斷快取是否真的省錢」,反而更容易講清楚,也更方便讀者直接應用。
¶ 2. 給數字補上適用條件
不要只寫「成本下降 40%」。
要說明使用什麼模型、怎麼算的、是否包含輸出、工具和人工費用,以及這個數字是實驗結果還是示範算例。
¶ 3. 關鍵內容不要只藏在圖片裡
Google 明確建議重要內容以文字形式呈現,結構化資料也應與頁面可見內容保持一致。
所以,圖表可以幫助理解,但正文仍要交代結論、資料和條件。
¶ 4. 把事實、建議和預測分開
「官方文件支援某項功能」是一類資訊。
「我們建議內容團隊這樣用」是另一類。
「未來可能帶來某種變化」又是第三類。
明確區分它們,比把所有句子都寫得斬釘截鐵更有價值。
¶ 5. 觀察真實結果,不迷信自評分數
可以建立一個固定問題集,定期記錄不同 AI 搜尋產品是否引用本站、引用了哪篇文章、引用是否準確,再結合實際造訪和轉換分析。
這樣的追蹤仍然會受到時間、地區和產品差異影響,但至少比給文章打一個沒有公開依據的「GEO 高分」更有參考價值。
¶ 八、真正該優化的是「每篇合格文章的成本」
內容團隊很容易盯著兩個數字:一天生成多少篇,每篇消耗多少 token。
但如果生成了 100 篇,最後只有 20 篇能發布,這個效率可能並不高。
我更建議看這個指標:
單篇合格內容成本 = 總生產成本 ÷ 通過審核的文章數量
其中,總生產成本應該包含模型呼叫、檢索工具、返工和人工審核,而不只是第一次生成的費用。
實際落地時,可以先選一批有代表性的任務做小規模測試,不要一開始就全站鋪開。
重點記錄:
| 指標 | 要回答的問題 |
|---|---|
| 事實錯誤率 | 有沒有編造、過時資訊或版本混淆? |
| 來源可追溯性 | 關鍵結論能不能找到原始依據? |
| 首輪審核通過率 | 有多少內容不需要大幅返工? |
| 單篇合格成本 | 包括失敗任務和人工之後,究竟花了多少? |
| 交付時長 | 從開始檢索到可以發布,需要多久? |
| 發布後的效果 | 是否帶來有效造訪、引用或業務轉換? |
測試後再決定:哪些任務降級處理,哪些環節提高推理投入,哪些研究值得平行處理,哪些步驟必須交給人。
¶ 寫在最後:把聰明用在該用的地方
GPT-6 給內容團隊提供了更多選擇,但選擇變多,並不意味著每一步都要用最強配置。
更值得嘗試的方向是:
簡單任務輕量處理,複雜判斷認真推理,重複上下文盡量重複使用,獨立研究適度平行處理,正式發布之前保留審核。
對 GEO 來說,也一樣。
沒有哪個模型能替一篇文章保證被引用。我們能做的,是讓它回答真實問題、提供可追溯的證據,並把適用範圍講清楚。
說到底,真正值得追求的不是「讓 AI 多寫一點」,而是:
讓每一篇發布出去的內容,都更值得讀,也更經得起檢查。
¶ 參考資料
- OpenAI:GPT-6 實踐指南
- OpenAI:Introducing GPT-6.1 Sol
- Anthropic:How we built our multi-agent research system
- GEO: Generative Engine Optimization(KDD 2024)
- Google Search Central:AI features and your website
本文為資料整理與應用分析,不屬於本站效能實測。模型能力、測試階段和價格可能變化,請以服務方最新文件為準。