
Изменения, которые приносит GPT-6, заключаются не только в том, что модель стала умнее, но и в том, что мы можем более детально распределять задачи, контролировать затраты на рассуждения и повторно использовать контекст. Для команд, занимающихся контентом и GEO, действительно стоит изучать не то, «какая модель сильнее», а то, как сделать процесс поиска, написания, проверки и публикации более надёжным, одновременно снижая стоимость каждой соответствующей требованиям единицы контента.
¶ I. Модели становятся всё сильнее, почему контент всё ещё неудобно использовать?
Если вы массово писали статьи с помощью ИИ, вы, скорее всего, сталкивались с такой ситуацией: на первый взгляд структура полная, предложения гладкие, даже выводы выглядят вполне убедительно. Но при внимательной проверке оказывается, что у данных нет источников, версии продукта не совпадают или написано две тысячи иероглифов, а вопрос, который больше всего волнует читателя, так и не получил ответа.
В этот момент самое очевидное решение: заменить модель на более сильную.
Но я скорее предложил бы сначала задать вопрос: проблема действительно в возможностях модели или в рабочем процессе?
Если нет надёжных материалов, чётких границ задачи и этапа проверки перед публикацией, смена модели не обязательно решит коренную проблему.
Практическое руководство OpenAI по использованию GPT-6 на самом деле также не строится исключительно вокруг «улучшения возможностей», а рассматривает вместе выбор модели, уровень рассуждений, кэширование, сжатие контекста и совместную работу нескольких агентов. В нём подчёркивается: нужно направлять разные возможности на конкретные задачи и до запуска измерять процент успешности, задержку и стоимость каждой успешно выполненной задачи.
Для контент-команд этот подход очень практичен: не думайте только о том, как заставить ИИ писать больше, сначала добейтесь того, чтобы он выдавал результат стабильнее.
¶ II. Как выбирать между Astra, Sol и Luna? Считайте их разными должностями
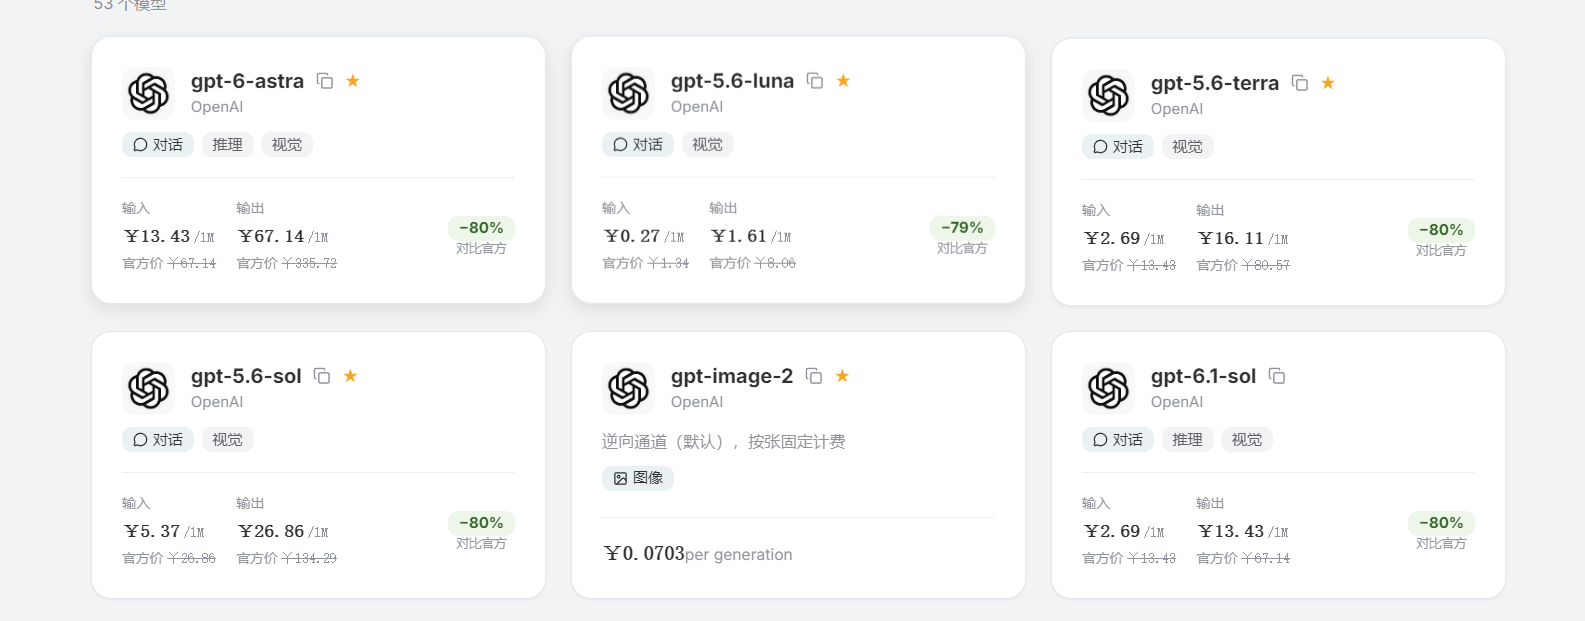
Согласно позиционированию в упомянутом выше официальном руководстве OpenAI, GPT-6 Astra предназначена для самых сложных задач рассуждения; GPT-6.1 Sol — для сложного программирования, исследований и работы с компьютером; GPT-6 Luna больше ориентирована на повторяющиеся задачи с чётко определённой целью, требующие масштабной обработки, например извлечение полей, классификацию и структурированные резюме.
Вместо того чтобы механически запоминать параметры, лучше воспринимать их как разные должности в команде.
В следующей таблице приведены рекомендации по выбору, составленные с учётом контент-бизнеса, а не официальный рейтинг производительности:
| Этап работы с контентом | Модель, которую рекомендуется оценить в первую очередь | Основные соображения |
|---|---|---|
| Классификация статей, извлечение полей, резюме в фиксированном формате | GPT-6 Luna | Задача понятна, сначала оцените точность формата и стоимость за единицу |
| Исследование по нескольким источникам, упорядочивание материалов, объединение статьи | GPT-6.1 Sol | Требуются суждения на основе разных материалов и многошаговое выполнение |
| Анализ спорных вопросов, сложная аргументация, проверка ключевого контента | GPT-6 Astra | Цена ошибки выше, требуется более глубокое суждение |
Например, мы готовимся написать статью «Как предприятиям выбирать API для ИИ». Для извлечения полей цен и функций из документации разных компаний не обязательно сразу использовать самую сильную модель; а для анализа компромиссов разных решений в сложном бизнесе стоит вложить больше ресурсов в рассуждения.
Конечно, это не означает, что контент, за который отвечают «маленькие модели», не нужно проверять. Такая информация, как цены, единицы тарификации и номера версий, может содержать ошибки, даже если требуется лишь извлечение.
Простая задача означает лишь, что способ обработки может быть легче, а не то, что стандарты приёмки могут быть ниже.
¶ III. Уровень рассуждений — не чем выше, тем лучше, нужно смотреть, стоит ли этот шаг того
После выбора модели есть ещё одна переменная, которую легко упустить из виду: вложения в рассуждения.
В руководстве OpenAI уровни рассуждений описываются как компромисс между возможностями и ценой: Low соответствует обычному извлечению или небольшому редактированию, Medium используется для работы, требующей суждений, High — для глубокого анализа и тщательной проверки; более высокие уровни следует использовать только если модель их поддерживает и дополнительная выгода оправдывает время и стоимость.
Если говорить прямо:
- Чтобы изменить заголовок, нет необходимости заставлять модель снова и снова проводить рассуждения.
- При сравнении трёх бизнес-решений можно дать больше пространства для размышлений.
- Чтобы определить, есть ли существенное противоречие между двумя материалами, стоит провести серьёзный анализ.
Можно начать тестирование со следующего подхода:
| Задача | Рекомендуемая отправная точка | Когда повышать уровень |
|---|---|---|
| Классификация тегов, преобразование формата | Низкие вложения в рассуждения | Появляется очевидная неоднозначность или конфликт правил |
| План статьи, сравнение решений | Средние вложения в рассуждения | Невозможно объяснить компромиссы, упущены ключевые условия |
| Анализ фактических противоречий, проверка важных выводов | Высокие вложения в рассуждения | Ключевая проблема всё ещё не решена — затем тестируйте более высокий уровень |
Здесь есть важное различие: думать дольше не значит знать больше фактов.
Если задача требует актуальных цен или только что опубликованной информации о продукте, прежде всего нужно восполнить источники, а не просто повышать уровень рассуждений. Когда доказательств не хватает, лучшим ответом может быть «эту информацию пока невозможно подтвердить», а не более гладкое предположение.
Кроме того, таблица выше — это рекомендация по рабочему процессу, а не универсальная таблица параметров API. Доступные на практике уровни и названия параметров следует сверять с конкретной моделью и документацией по интеграции.
¶ IV. «Кэширование экономит 95%» очень привлекательно, но не ошибитесь в расчётах
Кэширование может быть одним из самых достойных внимания направлений оптимизации при массовом производстве контента.
Описание бренда, правила написания, фиксированный глоссарий, требования к проверке… эти материалы часто повторяются в каждом запросе. OpenAI рекомендует размещать стабильные инструкции и справочные материалы перед изменяющимися деталями задачи, а также сохранять определения инструментов единообразными, чтобы повторно использовать общий контекст. В официальном руководстве упоминается, что стоимость кэшированного ввода по сравнению с некэшированным может снижаться до 95%, в зависимости от модели.
Но здесь обязательно нужно чётко понимать:
То, что кэшированный ввод дешевле на 95%, не означает, что стоимость производства всей статьи снизится на 95%. 以официально опубликованных стандартных API-цен GPT-6.1 Sol в качестве примера: за миллион входных token взимается 2 доллара, за кэшированный ввод — 0,10 доллара, за вывод — 10 долларов. Здесь указаны официальные стандартные цены OpenAI, они не представляют фактические расценки данного сайта или сторонних каналов подключения; при изменении цен ориентируйтесь на последнюю страницу поставщика услуг.
Сделаем демонстрационный расчёт, это не результат фактического тестирования:
Предположим, одна задача включает:
- 20 000 входных token;
- из них 15 000 могут попасть в кэш;
- 3 000 выходных token.
| Статья расходов | Все входные данные не попали в кэш | 15 000 входных данных попали в кэш |
|---|---|---|
| Некэшированный ввод | $0.0400 | $0.0100 |
| Кэшированный ввод | $0 | $0.0015 |
| Вывод | $0.0300 | $0.0300 |
| Итого | $0.0700 | $0.0415 |
При расчёте по этому предположению расходы на token снижаются примерно на 40,7%, а не на 95%.
Кроме того, сюда ещё не включены вызовы инструментов, повторные попытки после сбоев, ручная проверка, а также другие возможные применимые расходы.
Поэтому более надёжный подход — разделить промпт на два слоя:
Стабильный слой: брендовые нормы, стиль письма, формат вывода, правила проверки.
Динамический слой: текущая тема, целевые читатели, недавно найденные материалы, требования текущей задачи.
Затем наблюдать за ситуацией с попаданиями в кэш в реальных запросах, а не сразу вносить в бюджет проекта увиденную «максимальную скидку».
¶ V. Мультиагентный подход хорошо подходит для исследований, но не для разделения работы ради оживления
Исследовательская статья часто включает несколько задач, которые можно продвигать независимо:
- изучить официальную документацию;
- найти реальные примеры;
- собрать часто задаваемые вопросы;
- сверить цены и функции;
- упорядочить расхождения между различными источниками.
Эти задачи обладают определённой независимостью и подходят для параллельной обработки.
В руководстве OpenAI говорится, что GPT-6.1 Sol может через Responses API распределять независимые задачи между подагентами, а затем сводить результаты; эта мультиагентная возможность отмечена в руководстве как beta.
Однако мультиагентный подход — не бесплатное повышение эффективности.
В инженерном разборе своей исследовательской системы Anthropic упоминает, что мультиагентный подход подходит для исследований, разворачиваемых в нескольких независимых направлениях, но значительно увеличивает расход token; по наблюдаемым ими данным, использование token мультиагентной системой примерно в 15 раз выше, чем в обычном чате. Эта цифра относится к опыту их конкретной системы и не может напрямую применяться ко всем продуктам.
Поэтому я скорее рекомендую такой подход:
Пусть несколько агентов отдельно ищут доказательства, один редактор единообразно организует статью, а затем её проверяет человек.
Не стоит поручать пяти агентам написать по пять абзацев, а затем напрямую склеивать их вместе. Так легко появляются повторы, противоречия и несогласованный стиль.
Ниже приведена схема процесса, подходящего для старта контент-команды:
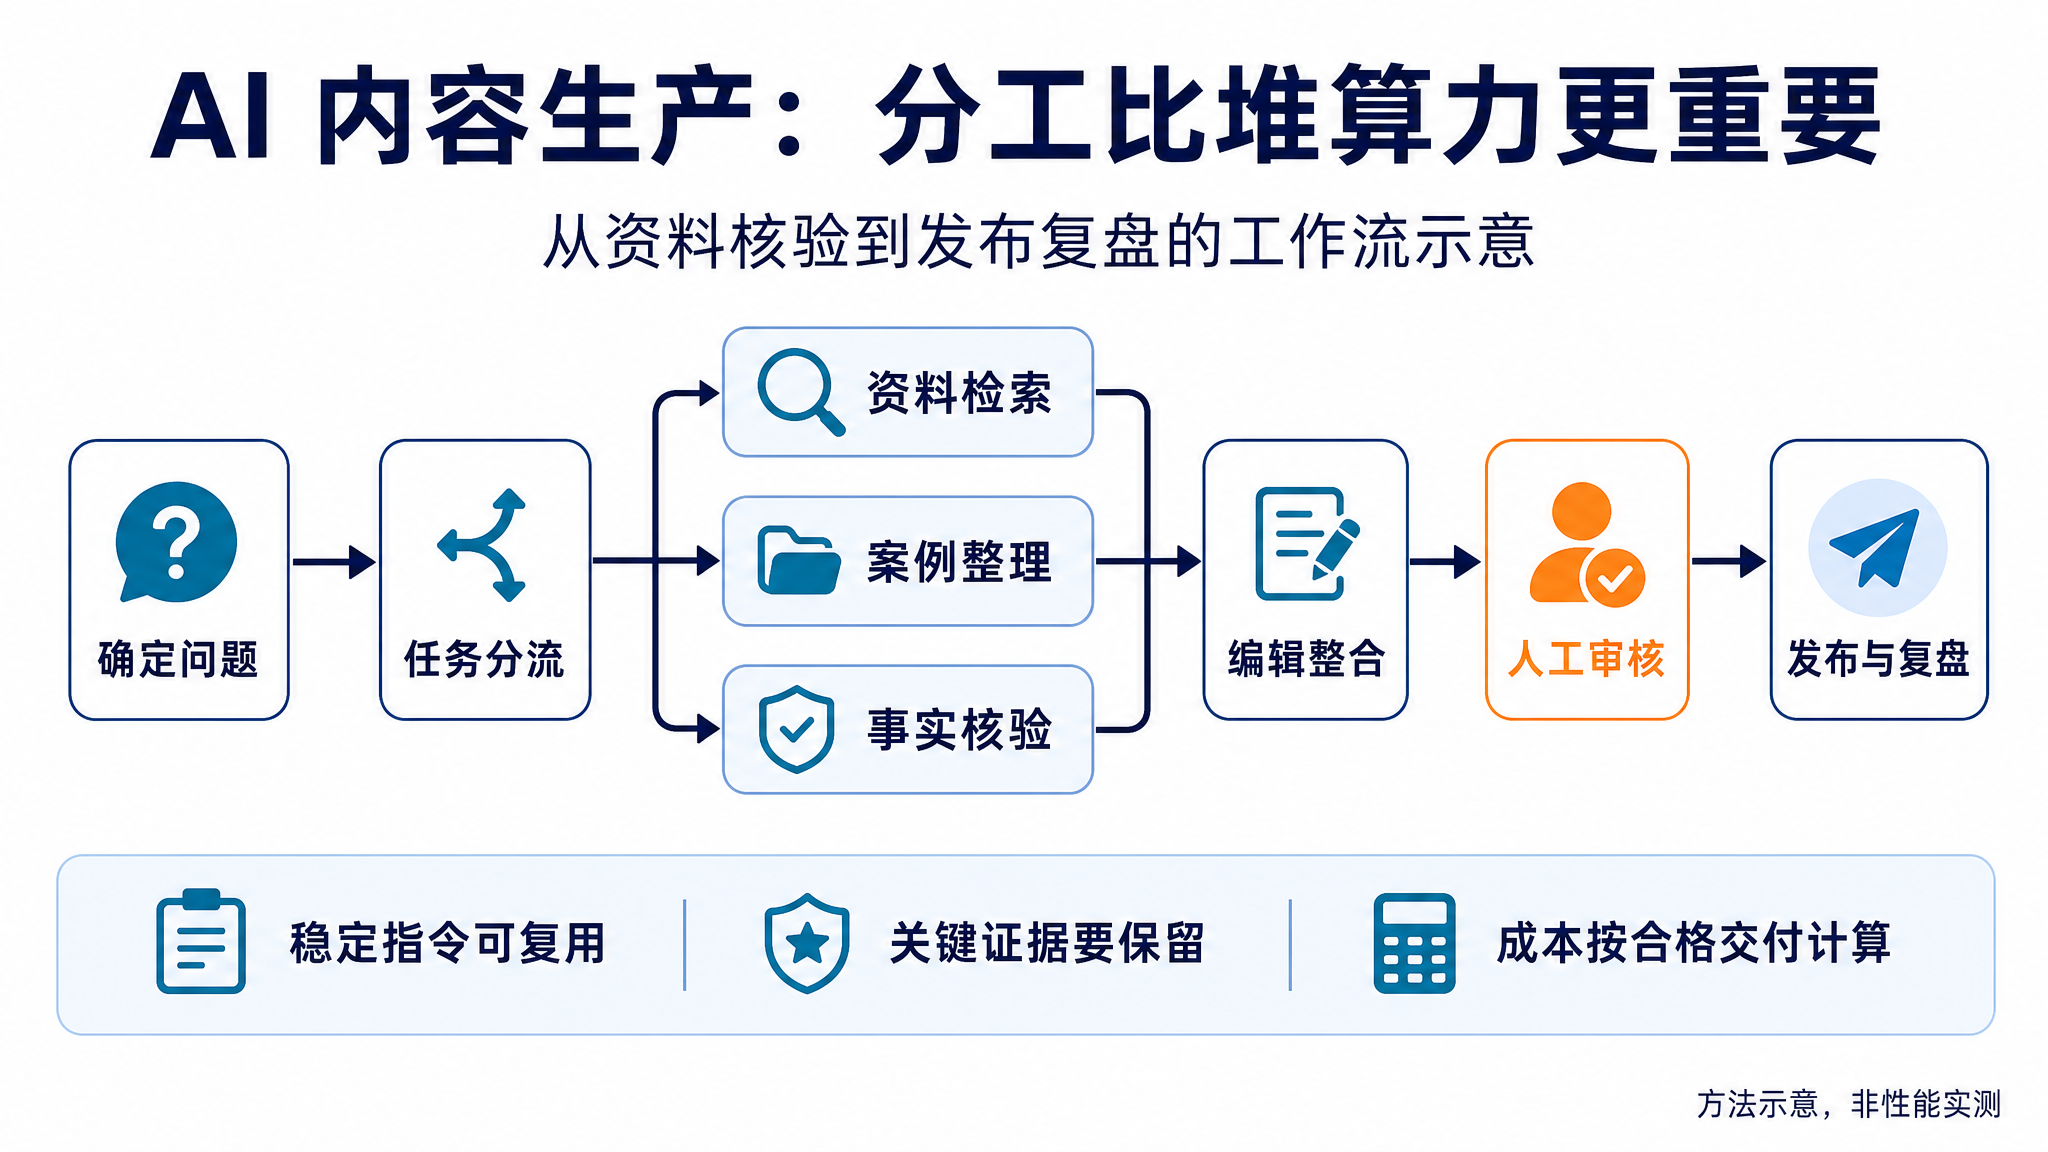
Иллюстрация представляет собой схему метода, созданную GPT Image 2, и не является результатом тестирования производительности.
Чтобы этот процесс действительно был полезным, каждая подзадача должна по возможности предоставлять четыре вещи:
- Вывод: что было обнаружено.
- Источник: где находятся доказательства.
- Ограничения: в каких случаях это неприменимо.
- Требующие подтверждения пункты: по чему ещё нельзя сделать вывод.
Особенно важно: проверка фактов — это не просьба к другой модели «считать, что с этим текстом всё в порядке», а повторное сопоставление с источниками.
Единодушие нескольких агентов не означает, что факт уже доказан.
¶ VI. Для долгих задач нужно сохранять состояние, а для автоматических операций — чётко разграничивать права
При написании короткого текста может быть достаточно поместить материалы в контекст. При создании серии тематических материалов и постоянном сопровождении продуктовой документации ситуация уже иная.
В руководстве OpenAI описано сжатие контекста, используемое для уменьшения объёма контекста длинных диалогов при сохранении состояния, необходимого для продолжения задачи.
Для работы с контентом я рекомендую независимо от выбранного способа сжатия отдельно вести запись задачи:
- подтверждённые факты и их источники;
- используемая в данный момент версия продукта;
- ещё не разрешённые противоречия в материалах;
- выполненные и невыполненные этапы;
- решения, которые обязательно должен подтвердить человек.
Не оставляйте только размытые сводки вроде «мы уже исследовали этот вопрос». Для последующей работы над текстом действительно нужны доказательства и границы применимости.
То же самое относится к автоматическим операциям. Официальное руководство рекомендует в первую очередь использовать API или подключённые инструменты для шагов, которые можно выполнить напрямую этими способами; к возможностям компьютерных операций следует обращаться только тогда, когда нужно читать экран, нажимать или заполнять формы.
Для процесса ведения блога можно разрешить AI автоматически упорядочивать черновики, проверять ссылки и генерировать иллюстрации, но официальную публикацию, удаление статей и изменение онлайн-конфигурации следует выполнять только после подтверждения человеком.
Умение работать с панелью управления не означает, что следует предоставлять неограниченные права.
¶ VII. Возвращаясь к GEO: писать быстрее не означает, что AI будет легче вас цитировать
На этом этапе нужно разделить два вопроса:
- использовать AI для повышения эффективности производства контента;
- сделать так, чтобы контент было легче находить и цитировать в ответах генеративного поиска.
Первое — вопрос рабочего процесса, второе и есть ядро внимания GEO.
Раннее исследование GEO посвящено видимости контента в генеративных движках и сообщает о максимальном повышении видимости примерно на 40% в рамках его настроек оценки, одновременно отмечая, что эффект различается в разных областях. Этот результат нельзя напрямую понимать как «сделайте так же, и трафик этого сайта вырастет на 40%».
Официальное пояснение Google более прагматично: для AI Overviews и AI Mode не требуется отдельный набор специальных требований по оптимизации; базовое SEO, надёжный и ориентированный на людей контент по-прежнему важны. Страница должна иметь право на индексацию и отображение сниппета, чтобы получить возможность появиться в качестве поддерживающей ссылки.
Это не означает, что правила всех AI-продуктов поиска именно таковы, но как минимум напоминает нам: не спешите искать так называемый «универсальный шаблон GEO». Для блога этого сайта я больше рекомендую сначала хорошо сделать следующие несколько вещей.
¶ 1. Одна статья решает одну реальную проблему
«Всесторонний разбор будущего ИИ» звучит масштабно, но не обязательно полезно.
«При массовой генерации описаний товаров, как определить, действительно ли кэширование экономит деньги», напротив, легче ясно объяснить и удобнее сразу применить читателям.
¶ 2. Дополняйте цифры условиями применимости
Не пишите только «затраты снизились на 40%».
Нужно указать, какая модель используется, как это рассчитывается, включены ли выходные данные, расходы на инструменты и ручной труд, а также является ли эта цифра результатом эксперимента или демонстрационным расчётом.
¶ 3. Не прячьте ключевой контент только в изображениях
Google ясно рекомендует представлять важный контент в текстовой форме, а структурированные данные также должны соответствовать видимому содержимому страницы.
Поэтому диаграммы могут помогать пониманию, но основной текст всё равно должен объяснять выводы, данные и условия.
¶ 4. Разделяйте факты, рекомендации и прогнозы
«Официальная документация поддерживает определённую функцию» — это один тип информации.
«Мы рекомендуем команде контента использовать это таким образом» — другой.
«В будущем это может привести к определённым изменениям» — уже третий.
Чётко различать их ценнее, чем писать все предложения с безапелляционной уверенностью.
¶ 5. Наблюдайте реальные результаты, не верьте слепо самооценочным баллам
Можно сформировать фиксированный набор вопросов, регулярно фиксировать, ссылаются ли разные продукты ИИ-поиска на этот сайт, на какую статью они ссылаются и точна ли ссылка, а затем сочетать это с анализом реальных посещений и конверсий.
Такое отслеживание всё равно будет зависеть от времени, региона и различий между продуктами, но оно как минимум имеет большую справочную ценность, чем присваивать статье «высокий GEO-балл» без публично доступных оснований.
¶ VIII. На самом деле оптимизировать нужно «стоимость каждой прошедшей проверку статьи»
Командам контента легко сосредоточиться на двух цифрах: сколько статей генерируется за день и сколько токенов потребляет каждая статья.
Но если сгенерировано 100 статей, а в итоге можно опубликовать только 20, такая эффективность может быть не слишком высокой.
Я больше рекомендую смотреть на этот показатель:
Стоимость одной подходящей публикации = общая стоимость производства ÷ количество статей, прошедших проверку
При этом общая стоимость производства должна включать вызовы моделей, инструменты поиска, доработку и ручную проверку, а не только расходы на первую генерацию.
При практическом внедрении можно сначала выбрать группу репрезентативных задач для небольшого тестирования, а не разворачивать всё сразу на весь сайт.
Особенно важно фиксировать:
| Показатель | Вопрос, на который нужно ответить |
|---|---|
| Доля фактических ошибок | Есть ли выдуманные, устаревшие сведения или путаница версий? |
| Прослеживаемость источников | Можно ли найти первоисточник для ключевых выводов? |
| Доля прохождения первой проверки | Какой объём контента не требует существенной доработки? |
| Стоимость одной подходящей публикации | Сколько в действительности потрачено с учётом неудачных задач и ручной работы? |
| Срок выполнения | Сколько времени требуется от начала поиска до готовности к публикации? |
| Результат после публикации | Приносит ли это полезные посещения, цитирования или бизнес-конверсии? |
После тестирования уже решайте: какие задачи обрабатывать на пониженном уровне, на каких этапах увеличить затраты на рассуждение, какие исследования стоит выполнять параллельно и какие шаги обязательно передавать человеку.
¶ В заключение: используйте интеллект там, где он нужен
GPT-6 предоставляет командам контента больше вариантов, но больше вариантов не означает, что на каждом этапе нужно использовать самую мощную конфигурацию.
Направление, которое стоит попробовать, заключается в следующем:
простые задачи обрабатывать облегчённо, над сложными решениями серьёзно рассуждать, повторяющийся контекст по возможности переиспользовать, независимые исследования умеренно выполнять параллельно, а перед официальной публикацией сохранять проверку.
Для GEO то же самое.
Ни одна модель не может гарантировать, что на статью будут ссылаться. Мы можем лишь сделать так, чтобы она отвечала на реальные вопросы, предоставляла прослеживаемые доказательства и ясно объясняла сферу применимости.
В конечном счёте, действительно стоит стремиться не к тому, чтобы «ИИ писал больше», а к следующему:
чтобы каждый опубликованный материал был более достойным прочтения и лучше выдерживал проверку.
¶ Справочные материалы
- OpenAI: Практическое руководство по GPT-6
- OpenAI: Представляем GPT-6.1 Sol
- Anthropic: Как мы построили нашу мультиагентную исследовательскую систему
- GEO: Оптимизация для генеративных движков (KDD 2024)
- Google Search Central: Функции ИИ и ваш сайт
Эта статья представляет собой сбор материалов и прикладной анализ и не является измерением производительности этого сайта. Возможности моделей, стадии тестирования и цены могут меняться; ориентируйтесь на актуальную документацию поставщика услуг.