
As mudanças trazidas pelo GPT-6 não se resumem a modelos mais inteligentes, mas ao fato de podermos distribuir tarefas com mais precisão, controlar o investimento em raciocínio e reutilizar contexto. Para equipes que trabalham com conteúdo e GEO, o que realmente vale a pena estudar não é “qual modelo é o mais forte”, mas como tornar mais confiável o fluxo de recuperação, escrita, verificação e publicação, ao mesmo tempo em que se reduz o custo de cada conteúdo qualificado.
¶ I. Os modelos estão cada vez mais fortes, então por que o conteúdo ainda não funciona bem?
Se você já usou IA para escrever artigos em massa, provavelmente encontrou esta situação: à primeira vista, a estrutura está completa, as frases fluem bem, e até o resumo parece bastante convincente. Mas, ao verificar com atenção, você percebe que os dados não têm fonte, as versões dos produtos não correspondem ou que, após escrever duas mil palavras, a questão mais importante para o leitor ainda não foi respondida.
Nesse momento, a solução mais fácil de imaginar é: trocar por um modelo mais forte.
Mas eu sugiro primeiro fazer uma pergunta: o problema está realmente na capacidade do modelo ou no fluxo de trabalho?
Se não houver materiais confiáveis, limites claros para a tarefa e uma etapa de verificação antes da publicação, trocar de modelo talvez não resolva o problema fundamental.
O guia de uso do GPT-6 da OpenAI, na verdade, também não se desenvolve apenas em torno de “atualizações de capacidade”, mas discute juntos a seleção de modelos, os níveis de raciocínio, o cache, a compactação de contexto e a colaboração multiagente. O que ele enfatiza é: fazer diferentes capacidades servirem a tarefas específicas e, antes do lançamento, medir a taxa de sucesso, a latência e o custo por tarefa bem-sucedida.
Para equipes de conteúdo, essa ideia é muito prática: não pense apenas em fazer a IA escrever mais; primeiro faça com que ela entregue de forma mais estável.
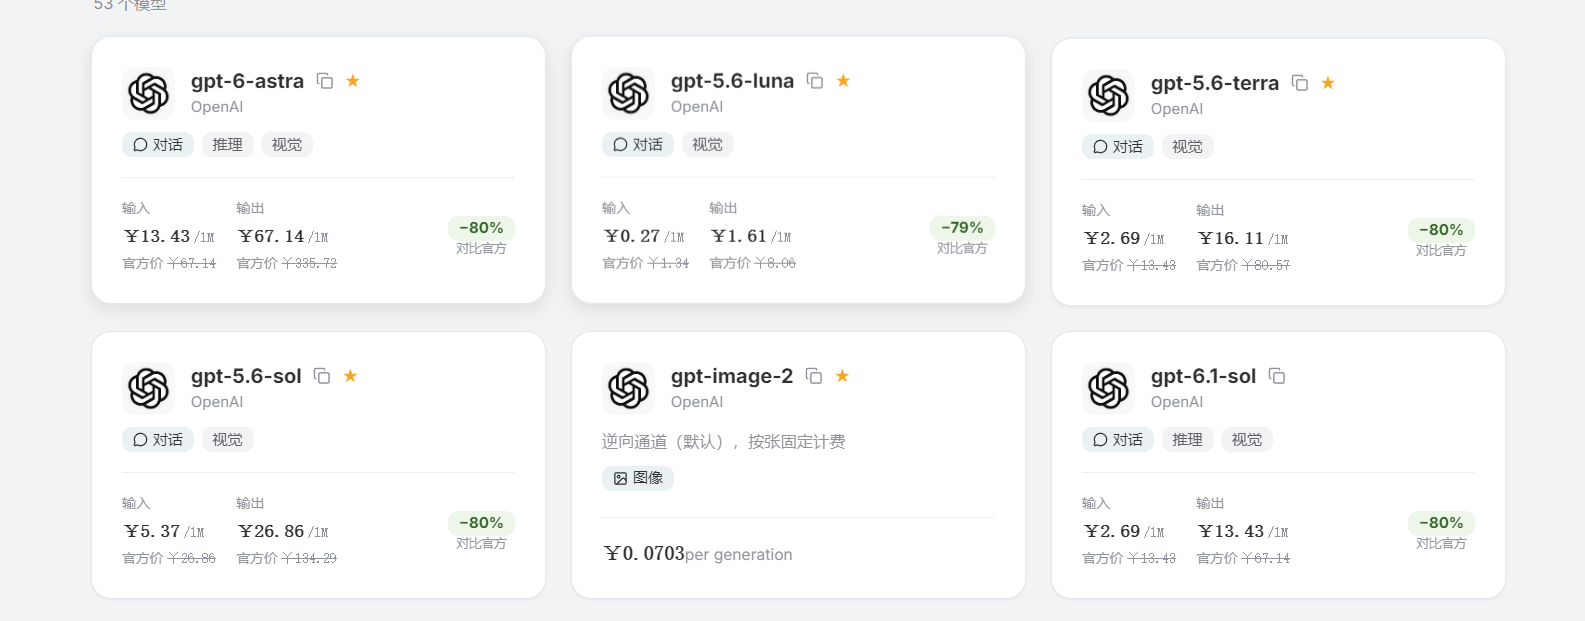
¶ II. Como escolher entre Astra, Sol e Luna? Pense neles como funções diferentes
De acordo com o posicionamento do guia oficial da OpenAI mencionado acima, o GPT-6 Astra é voltado aos trabalhos de raciocínio mais difíceis; o GPT-6.1 Sol é voltado para codificação complexa, pesquisa e operações de computador; já o GPT-6 Luna é mais indicado para tarefas repetitivas com objetivos claros e que exigem processamento em escala, como extração de campos, classificação e resumos estruturados.
Em vez de decorar parâmetros, é melhor entendê-los como funções diferentes dentro de uma equipe.
A tabela abaixo apresenta recomendações de seleção combinadas com o negócio de conteúdo e não é um ranking oficial de desempenho:
| Etapa de conteúdo | Modelo recomendado para avaliação prioritária | Principal consideração |
|---|---|---|
| Classificação de artigos, extração de campos, resumos em formato fixo | GPT-6 Luna | A tarefa é clara; primeiro avalie a taxa de correção do formato e o custo por unidade |
| Pesquisa com múltiplas fontes, organização de materiais, integração de artigos | GPT-6.1 Sol | Exige julgamento entre materiais e execução em múltiplas etapas |
| Análise de controvérsias, argumentação complexa, revisão de conteúdos importantes | GPT-6 Astra | O custo dos erros é maior e exige julgamentos mais aprofundados |
Por exemplo, estamos preparando um artigo sobre “como empresas devem escolher interfaces de IA”. Para extrair os campos de preços e funcionalidades da documentação de cada empresa, não é necessário usar o modelo mais forte logo de início; já para analisar as concessões entre diferentes soluções em negócios complexos, vale a pena investir mais recursos de raciocínio.
Claro, isso não quer dizer que o conteúdo pelo qual os “modelos menores” são responsáveis não precise de verificação. Informações como preços, unidades de cobrança e números de versão podem conter erros, mesmo quando se trata apenas de extração.
Uma tarefa simples apenas significa que a forma de processamento pode ser mais leve; não significa que os critérios de aceitação possam ser menos rigorosos.
¶ III. Um nível de raciocínio mais alto nem sempre é melhor; é preciso ver se esta etapa vale a pena
Depois de escolher o modelo, há outra variável que é facilmente ignorada: o investimento em raciocínio.
O guia da OpenAI descreve os níveis de raciocínio como uma troca entre capacidade e preço: Low corresponde à extração rotineira ou a pequenas edições, Medium é usado para trabalhos que exigem julgamento e High é usado para análises profundas e revisões cuidadosas; níveis mais altos devem ser usados apenas quando o modelo os suportar e quando o ganho adicional justificar o tempo e o custo.
Em termos simples:
- Para alterar um título, não é necessário fazer o modelo raciocinar repetidamente.
- Para comparar três soluções de negócio, pode-se dar mais espaço para reflexão.
- Para determinar se dois materiais apresentam um conflito substancial, vale a pena analisar com seriedade.
É possível começar os testes com a seguinte abordagem:
| Tarefa | Ponto de partida recomendado | Quando aumentar |
|---|---|---|
| Classificação de rótulos, conversão de formatos | Baixo investimento em raciocínio | Surgem ambiguidades evidentes ou conflitos de regras |
| Esboço de artigo, comparação de soluções | Investimento médio em raciocínio | Não é possível explicar as concessões, ou faltam condições-chave |
| Análise de conflitos factuais, revisão de conclusões importantes | Alto investimento em raciocínio | As questões-chave ainda não foram resolvidas; então teste níveis mais altos |
Há uma distinção importante aqui: pensar por mais tempo não significa saber mais fatos.
Se a tarefa exige o preço mais recente ou informações sobre um produto recém-lançado, o primeiro passo é complementar as fontes, e não simplesmente elevar o nível de raciocínio. Quando faltam evidências, a melhor resposta pode ser “esta informação ainda não pode ser confirmada”, e não uma suposição mais fluida.
Além disso, a tabela acima é uma recomendação de fluxo de trabalho, não uma tabela universal de parâmetros de API. Os níveis e nomes de parâmetros efetivamente disponíveis devem seguir o modelo específico e a documentação de integração.
¶ IV. “O cache economiza 95%” é muito atraente, mas não calcule errado
O cache pode ser um dos pontos de otimização mais dignos de atenção na produção de conteúdo em massa.
Apresentações da marca, normas de escrita, glossários de termos fixos, requisitos de revisão... esses materiais frequentemente aparecem repetidos em cada solicitação. A OpenAI recomenda colocar instruções estáveis e materiais de referência antes dos detalhes variáveis da tarefa e manter consistentes as definições de ferramentas, para reutilizar o contexto compartilhado. O guia oficial menciona que o custo de entradas em cache pode ser reduzido em até 95% em comparação com entradas sem cache, dependendo do modelo.
Mas aqui é preciso entender com clareza:
Uma entrada em cache 95% mais barata não significa que o custo de produção do artigo inteiro caia 95%. Tomando como exemplo os preços padrão de API do GPT-6.1 Sol publicados oficialmente: cada milhão de tokens de entrada custa 2 dólares, a entrada em cache custa 0,10 dólares e a saída custa 10 dólares. O que é citado aqui são os preços padrão oficiais da OpenAI, não representando as cotações reais deste site ou de canais de integração de terceiros; para alterações de preço, consulte a página mais recente do provedor de serviços.
Vamos fazer um exemplo demonstrativo, não um resultado de medição real:
Suponha que uma tarefa tenha:
- 20.000 tokens de entrada;
- Dos quais 15.000 podem atingir o cache;
- 3.000 tokens de saída.
| Item de custo | Toda a entrada sem atingir o cache | 15.000 entradas atingem o cache |
|---|---|---|
| Entrada sem cache | $0.0400 | $0.0100 |
| Entrada em cache | $0 | $0.0015 |
| Saída | $0.0300 | $0.0300 |
| Total | $0.0700 | $0.0415 |
Com base nessa hipótese, o custo de tokens cai cerca de 40,7%, e não 95%.
Além disso, isso ainda não inclui chamadas de ferramentas, novas tentativas após falhas, revisão humana e outros custos que possam ser aplicáveis.
Portanto, uma abordagem mais confiável é dividir o prompt em duas camadas:
Camada estável: diretrizes de marca, estilo de escrita, formato de saída e regras de revisão.
Camada dinâmica: tema desta vez, público-alvo, materiais recém-recuperados e requisitos da tarefa atual.
Em seguida, observe as taxas de acerto de cache em solicitações reais, em vez de incluir diretamente no orçamento do projeto o “maior desconto”.
¶ V. Múltiplos agentes são muito adequados para pesquisa, mas não para dividir o trabalho apenas por agitação
Um artigo de pesquisa geralmente contém várias tarefas que podem avançar de forma independente:
- Consultar documentação oficial;
- Encontrar casos reais;
- Coletar perguntas frequentes;
- Verificar preços e funcionalidades;
- Organizar divergências entre diferentes fontes.
Essas tarefas têm certo grau de independência e são adequadas para processamento paralelo.
O guia da OpenAI apresenta que o GPT-6.1 Sol pode distribuir tarefas independentes para subagentes na Responses API e, em seguida, consolidar os resultados; essa capacidade de múltiplos agentes é marcada como beta no guia.
No entanto, múltiplos agentes não representam um aumento de eficiência gratuito.
Em sua retrospectiva de engenharia sobre sistemas de pesquisa, a Anthropic menciona que múltiplos agentes são adequados para pesquisas que se expandem em diversas direções independentes, mas aumentam significativamente o consumo de tokens; nos dados que observaram, o uso de tokens de sistemas com múltiplos agentes foi cerca de 15 vezes maior que o de chats comuns. Esse número é uma experiência de seu sistema específico e não pode ser aplicado diretamente a todos os produtos.
Portanto, recomendo mais esta organização:
Deixe vários agentes encontrarem evidências separadamente, um editor organizar o artigo de forma unificada e, depois, faça a revisão humana.
Não deixe cinco agentes escreverem cinco parágrafos separadamente e depois simplesmente os juntem. Isso facilmente gera repetições, contradições e inconsistências de estilo.
Abaixo está um diagrama de fluxo adequado para uma equipe de conteúdo começar:
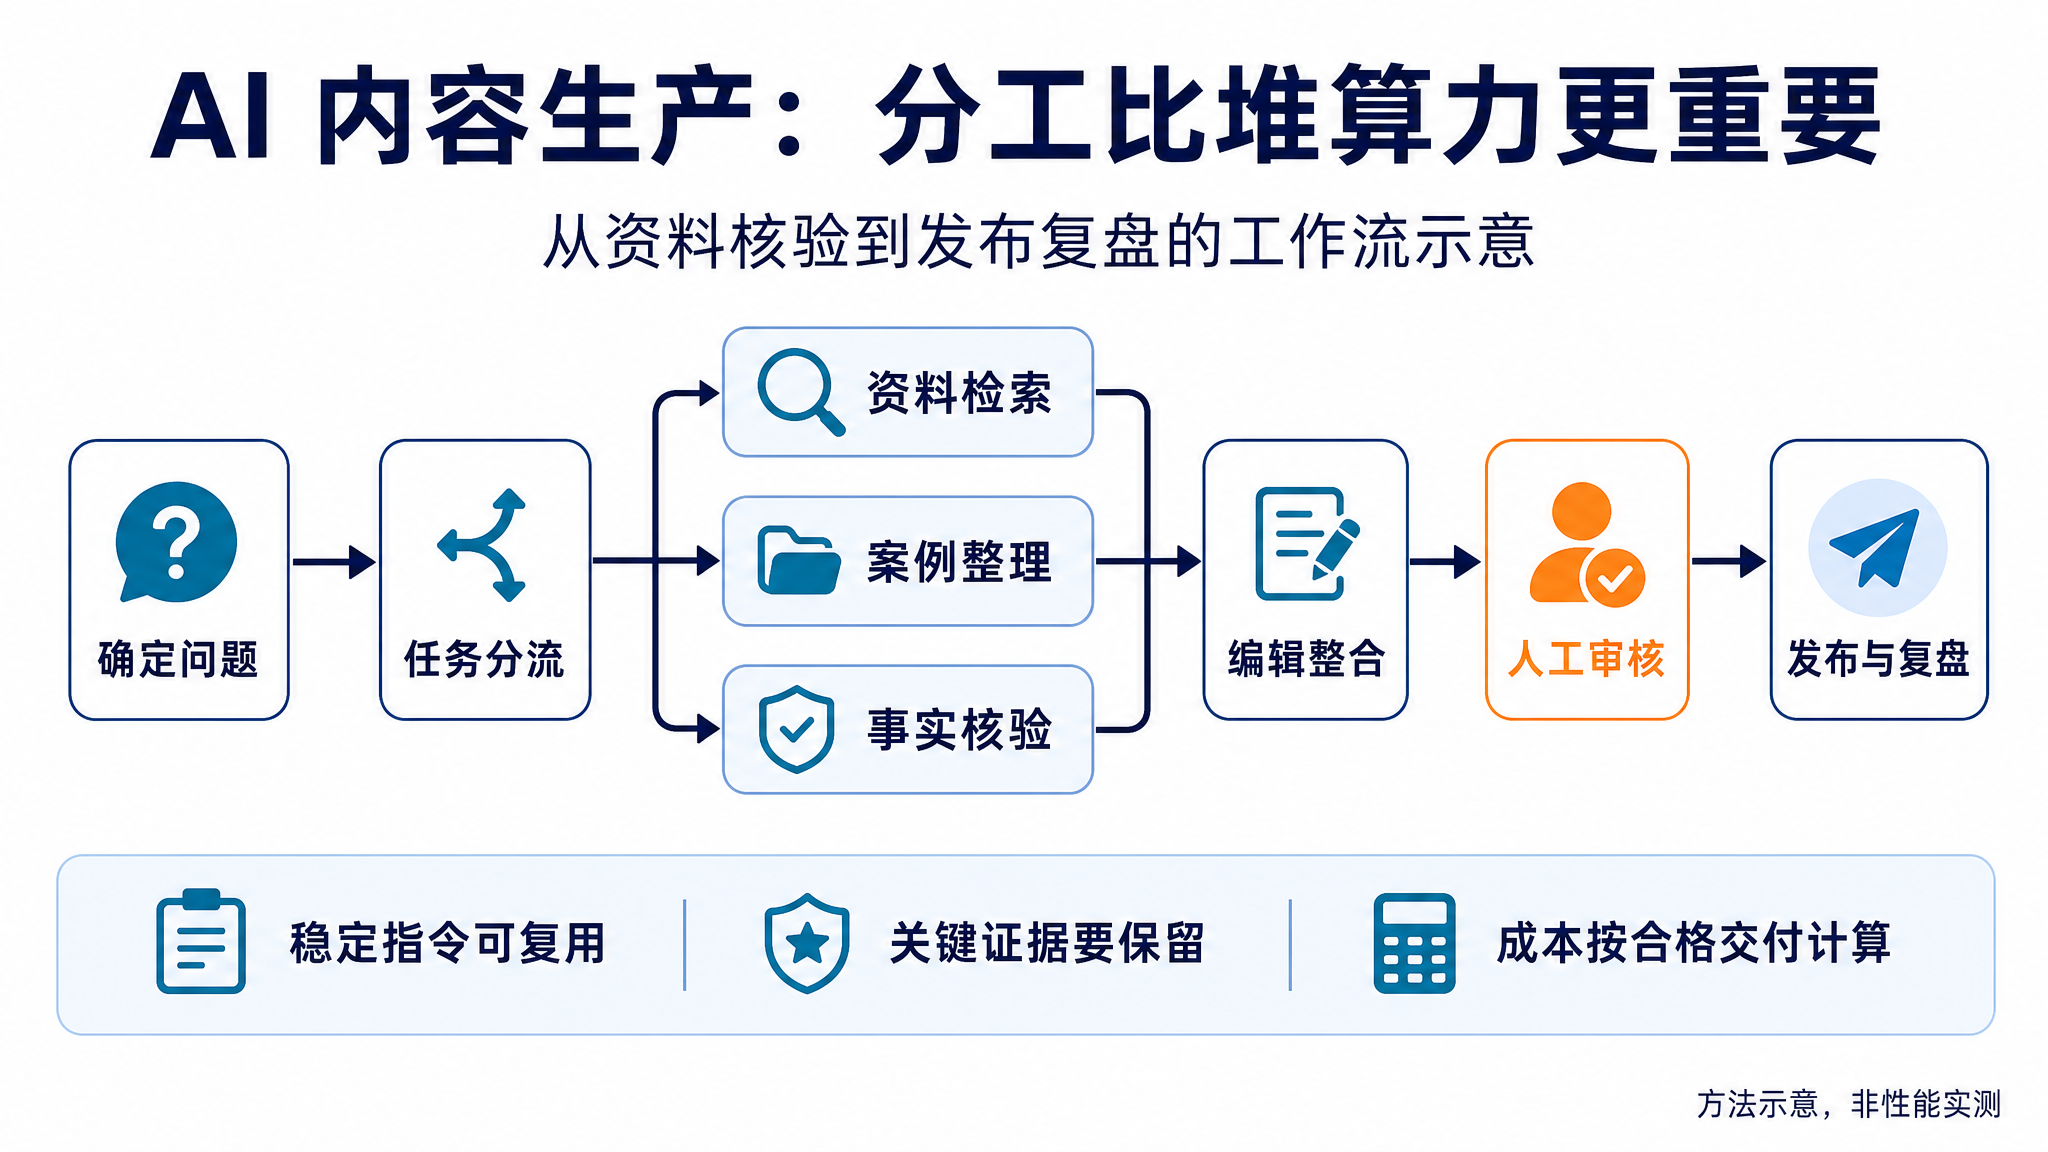
A ilustração é uma demonstração de método gerada pelo GPT Image 2 e não representa medições reais de desempenho.
Para que esse fluxo seja realmente útil, cada subtarefa deveria entregar quatro coisas:
- Conclusão: o que foi descoberto.
- Fonte: onde estão as evidências.
- Limitações: em quais situações não se aplica.
- Itens a confirmar: sobre o que ainda não é possível chegar a uma conclusão.
É especialmente importante observar: verificar fatos não é fazer outro modelo “achar que não há problema com este trecho”, mas fazê-lo comparar novamente com as fontes.
Vários agentes concordarem não significa que o fato já foi comprovado.
¶ VI. Tarefas longas devem salvar o estado, e operações automáticas devem delimitar permissões
Para escrever um texto curto, talvez seja suficiente colocar os materiais no contexto. Para produzir séries temáticas ou manter continuamente a documentação de produtos, a situação é diferente.
O guia da OpenAI apresenta a compressão de contexto, usada para reduzir o volume de contexto de conversas longas, preservando ao mesmo tempo o estado necessário para continuar a tarefa.
Para o trabalho de conteúdo, recomendo que, independentemente do método de compressão adotado, seja mantido separadamente um registro da tarefa:
- Fatos confirmados e suas fontes;
- A versão do produto atualmente utilizada;
- Conflitos de materiais que ainda não foram resolvidos;
- Etapas concluídas e não concluídas;
- Decisões que devem ser confirmadas por humanos.
Não deixe apenas resumos vagos como “já pesquisamos essa questão”. O que a escrita posterior realmente precisa são evidências e limites.
O mesmo vale para operações automáticas. O guia oficial recomenda priorizar as etapas que podem ser concluídas diretamente com APIs ou ferramentas já conectadas; quando for necessário ler a tela, clicar ou preencher formulários, considere então os recursos de operação do computador.
Para o fluxo de um blog, pode-se permitir que a IA organize automaticamente rascunhos, verifique links e gere ilustrações, mas deixe a publicação formal, a exclusão de artigos e a alteração de configurações online para depois da confirmação humana.
Saber operar o painel administrativo não significa que se deve ter permissões ilimitadas.
¶ VII. Voltando ao GEO: escrever mais rápido não significa ser citado mais facilmente por IA
Neste ponto, é preciso separar duas questões:
- Usar IA para aumentar a eficiência da produção de conteúdo;
- Fazer com que o conteúdo seja mais facilmente descoberto e citado em respostas de busca generativa.
A primeira é uma questão de fluxo de trabalho; a segunda é o verdadeiro foco do GEO.
A pesquisa inicial sobre GEO explora a visibilidade de conteúdo em mecanismos generativos e relata, em sua configuração de avaliação, uma melhoria máxima de visibilidade de cerca de 40%, ao mesmo tempo em que aponta diferenças de efeito entre diferentes áreas. Esse resultado não pode ser entendido diretamente como “faça isso e o tráfego deste site aumentará 40%”.
A explicação oficial do Google é mais pragmática: para AI Overviews e AI Mode, não é necessário um conjunto adicional de requisitos especiais de otimização; SEO básico e conteúdo confiável e centrado nas pessoas continuam importantes. A página precisa estar qualificada para ser indexada e exibir resumos para ter a chance de aparecer como um link de apoio.
Isso não representa as regras de todos os produtos de busca com IA, mas ao menos nos lembra: não se apresse em procurar o chamado “modelo GEO universal”. Para o blog deste site, recomendo mais que, primeiro, façam bem as seguintes coisas.
¶ 1. Um artigo resolve um problema real
“Análise abrangente do futuro da IA” parece muito amplo, mas não é necessariamente útil.
“Como determinar se o cache realmente economiza dinheiro ao gerar textos de produtos em lote” é, ao contrário, mais fácil de explicar claramente e também mais conveniente para os leitores aplicarem diretamente.
¶ 2. Acrescente as condições aplicáveis aos números
Não escreva apenas “redução de custo de 40%”.
É preciso explicar qual modelo foi usado, como foi calculado, se inclui saída, ferramentas e custos humanos, e se esse número é um resultado experimental ou um exemplo demonstrativo.
¶ 3. Não esconda o conteúdo principal apenas em imagens
O Google recomenda claramente que o conteúdo importante seja apresentado em formato de texto, e que os dados estruturados também permaneçam consistentes com o conteúdo visível da página.
Portanto, os gráficos podem ajudar na compreensão, mas o corpo do texto ainda deve explicar as conclusões, os dados e as condições.
¶ 4. Separe fatos, recomendações e previsões
“A documentação oficial oferece suporte a determinado recurso” é um tipo de informação.
“Recomendamos que a equipe de conteúdo o utilize desta forma” é outro tipo.
“Isso poderá trazer determinado tipo de mudança no futuro” é ainda um terceiro tipo.
Distingui-los claramente é mais valioso do que escrever todas as frases de forma categórica.
¶ 5. Observe resultados reais, não confie cegamente em pontuações de autoavaliação
É possível estabelecer um conjunto fixo de perguntas e registrar periodicamente se diferentes produtos de busca por IA citam este site, qual artigo citam e se a citação é precisa, combinando isso depois com análises de visitas e conversões reais.
Esse acompanhamento ainda será afetado por diferenças de tempo, região e produto, mas, pelo menos, tem mais valor de referência do que atribuir a um artigo uma “pontuação GEO alta” sem base pública.
¶ VIII. O que realmente deve ser otimizado é o “custo de cada artigo aprovado”
É fácil para equipes de conteúdo se concentrarem em dois números: quantos artigos são gerados por dia e quantos tokens cada artigo consome.
Mas, se 100 artigos forem gerados e, no final, apenas 20 puderem ser publicados, essa eficiência talvez não seja tão alta.
Recomendo mais observar esta métrica:
Custo por conteúdo aprovado = custo total de produção ÷ quantidade de artigos aprovados na revisão
Entre eles, o custo total de produção deve incluir chamadas ao modelo, ferramentas de recuperação, retrabalho e revisão humana, e não apenas o custo da primeira geração.
Na implementação prática, pode-se primeiro selecionar um conjunto de tarefas representativas para testes em pequena escala, sem expandir para o site inteiro logo no início.
Registre principalmente:
| Métrica | Pergunta a responder |
|---|---|
| Taxa de erros factuais | Há informações inventadas, desatualizadas ou confusão entre versões? |
| Rastreabilidade das fontes | É possível encontrar a fonte original para as conclusões principais? |
| Taxa de aprovação na primeira revisão | Quantos conteúdos não precisam de grande retrabalho? |
| Custo por artigo aprovado | Após incluir tarefas malsucedidas e trabalho humano, quanto foi realmente gasto? |
| Tempo de entrega | Do início da recuperação até estar pronto para publicação, quanto tempo é necessário? |
| Efeito após a publicação | Traz visitas efetivas, citações ou conversões de negócio? |
Após os testes, decida: quais tarefas devem ser tratadas em um nível inferior, em quais etapas aumentar o investimento em raciocínio, quais pesquisas valem a execução em paralelo e quais passos devem obrigatoriamente ser entregues a pessoas.
¶ Considerações finais: use a inteligência onde ela deve ser usada
O GPT-6 oferece mais opções às equipes de conteúdo, mas ter mais opções não significa que seja necessário usar a configuração mais poderosa em cada etapa.
Direções mais dignas de tentativa são:
tarefas simples com processamento leve, julgamentos complexos com raciocínio cuidadoso, reutilização máxima de contextos repetidos, paralelização moderada de pesquisas independentes e manutenção da revisão antes da publicação oficial.
Para GEO, é o mesmo.
Nenhum modelo pode garantir que um artigo será citado. O que podemos fazer é fazer com que ele responda a problemas reais, forneça evidências rastreáveis e explique claramente seu escopo de aplicação.
Em última análise, o que realmente vale a pena buscar não é “fazer a IA escrever um pouco mais”, mas sim:
fazer com que cada conteúdo publicado seja mais digno de leitura e também resista melhor à verificação.
¶ Referências
- OpenAI: Guia prático do GPT-6
- OpenAI: Introducing GPT-6.1 Sol
- Anthropic: How we built our multi-agent research system
- GEO: Generative Engine Optimization(KDD 2024)
- Google Search Central: Recursos de IA e seu site
Este artigo é uma compilação de materiais e uma análise de aplicação, não constituindo testes de desempenho deste site. As capacidades dos modelos, as fases de teste e os preços podem mudar; consulte a documentação mais recente do provedor de serviço.