
GPT-6 がもたらす変化は、単にモデルがより賢くなることだけではなく、私たちがより細かくタスクを配分し、推論への投入を制御し、コンテキストを再利用できるようになることです。コンテンツと GEO に取り組むチームにとって、本当に研究する価値があるのは「どのモデルが最強か」ではなく、検索、執筆、検証、公開というプロセスをどうすればより信頼できるものにし、同時に合格コンテンツ 1 本あたりのコストを下げられるかです。
¶ 一、モデルがますます強くなっているのに、なぜコンテンツは依然として使いにくいのか?
AI で記事を大量に書いたことがあるなら、おそらくこのような状況に遭遇したことがあるでしょう。ぱっと見では、構成は整っており、文章も滑らかで、要約までなかなかそれらしく見えます。しかし真剣に確認すると、データに出典がない、製品バージョンが一致していない、あるいは二千字書いても、読者が最も知りたい問題に答えていないことに気づきます。
このとき、最も思いつきやすい解決策は、より強いモデルに替えることです。
しかし私は、まず次のように問いかけることをよりおすすめします:問題は結局、モデルの能力にあるのか、それともワークフローにあるのか?
信頼できる資料がなく、明確なタスク境界もなく、公開前の検証プロセスもなければ、モデルを替えても根本的な問題を解決できるとは限りません。
OpenAI の GPT-6 利用ガイドも実際には「能力のアップグレード」だけを中心に展開しているのではなく、モデル選択、推論レベル、キャッシュ、コンテキスト圧縮、多エージェント協調をまとめて議論しています。それが強調しているのは、異なる能力を具体的なタスクに役立て、導入前に成功率、レイテンシー、成功したタスク 1 回あたりのコストを測定することです。
コンテンツチームにとって、この考え方は非常に実用的です:AI により多く書かせることだけを考えず、まずはより安定して成果を納品させましょう。
¶ 二、Astra、Sol、Luna はどう選ぶ?それぞれを異なる役割として捉える
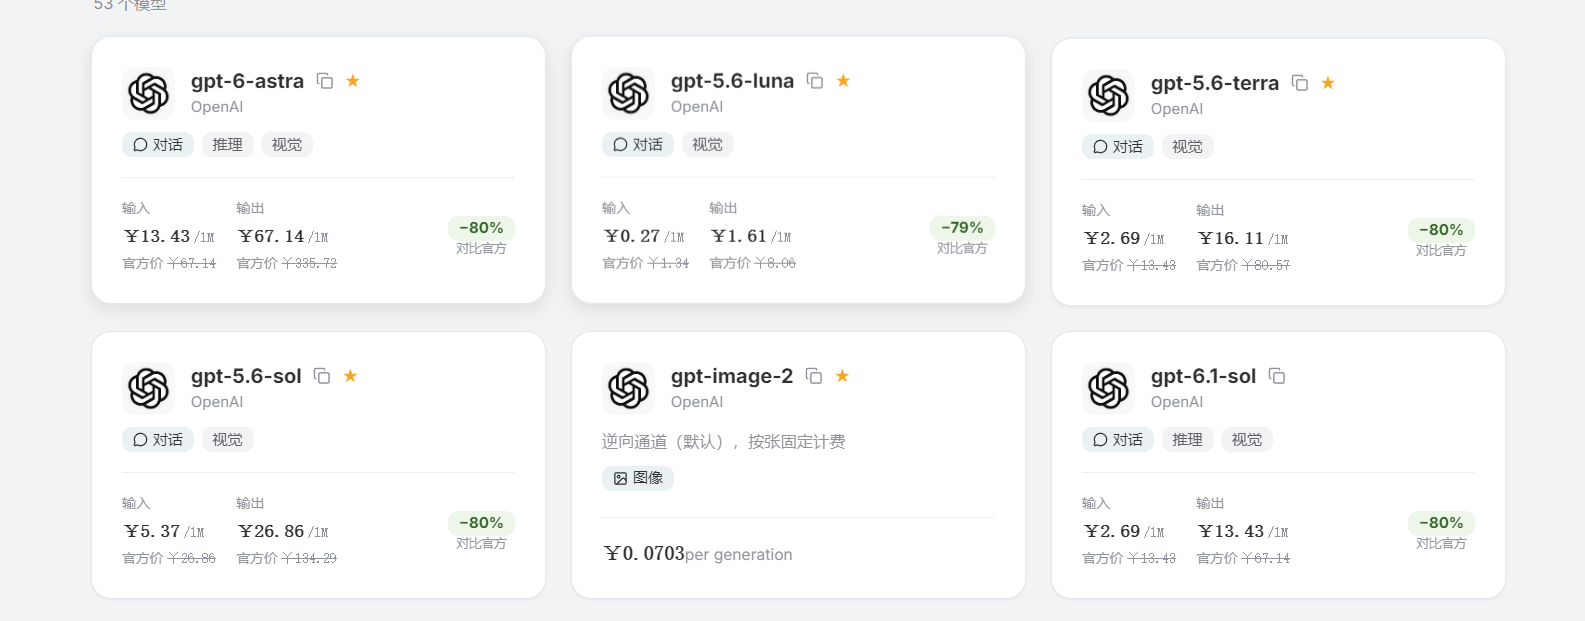
上記の OpenAI 公式ガイドでの位置づけによると、GPT-6 Astra は最も困難な推論作業向け、GPT-6.1 Sol は複雑なコーディング、研究、コンピュータ操作向け、GPT-6 Luna はフィールド抽出、分類、構造化要約のような、目的が明確でスケール処理が必要な反復タスク向けです。
パラメータを暗記するよりも、チーム内の異なる役割として理解したほうがよいでしょう。
以下の表は、コンテンツ業務を踏まえた選定に関する提案であり、公式の性能ランキングではありません:
| コンテンツ工程 | 優先して評価を推奨するモデル | 主な考慮点 |
|---|---|---|
| 記事分類、フィールド抽出、固定形式の要約 | GPT-6 Luna | タスクが明確であり、まず形式の正確性と単位コストを見る |
| 複数ソースの調査、資料整理、記事統合 | GPT-6.1 Sol | 資料をまたぐ判断と複数ステップの実行が必要 |
| 論争の分析、複雑な論証、重要コンテンツのレビュー | GPT-6 Astra | 誤りの代償がより大きく、より深い判断が必要 |
たとえば、「企業はいかに AI インターフェースを選択すべきか」という記事を書く準備をしているとします。各社のドキュメントから価格や機能のフィールドを抽出するだけなら、最初から最強のモデルを使う必要はありません。異なる選択肢の複雑な業務におけるトレードオフを分析するなら、より多くの推論リソースを投入する価値があります。
もちろん、これは「小さなモデルが担当するコンテンツは確認不要」という意味ではありません。価格、課金単位、バージョン番号のような情報は、単なる抽出であっても誤る可能性があります。
タスクが簡単であることは、処理方法をより軽くできることを意味するだけであり、受け入れ基準をより緩くできることを意味するわけではありません。
¶ 三、推論レベルは高ければよいわけではない、そのステップに価値があるかを見る
モデルを選んだ後、もう一つ見落とされがちな変数があります:推論への投入です。
OpenAI のガイドでは、推論レベルを能力と価格の間のトレードオフとして説明しています。Low は通常の抽出や軽微な編集に対応し、Medium は判断を必要とする作業に用いられ、High は深い分析と慎重なレビューに用いられます。さらに高いレベルは、モデルが対応しており、追加の利益が時間とコストに見合う場合に使用すべきです。
より率直に言えば:
- タイトルを一つ修正するだけなら、モデルに何度も推論させる必要はありません。
- 3 種類の業務案を比較するなら、より多くの思考の余地を与えてもよいでしょう。
- 2 つの資料に実質的な矛盾があるかを判断するなら、真剣に分析する価値があります。
以下のような方法からテストを始められます:
| タスク | 推奨する開始点 | いつ引き上げるか |
|---|---|---|
| タグ分類、形式変換 | 低い推論投入 | 明らかな曖昧さやルールの衝突が発生したとき |
| 記事のアウトライン、案の比較 | 中程度の推論投入 | トレードオフを説明できず、重要な条件を見落としたとき |
| 事実の矛盾分析、重要な結論のレビュー | 高い推論投入 | 依然として重要な問題を解決できない場合、さらに高いレベルをテストする |
ここには重要な違いがあります:より長く考えることは、より多くの事実を知っていることと同じではありません。
タスクに最新価格や公開されたばかりの製品情報が必要なら、まず情報源を補うべきであり、単に推論レベルを上げるべきではありません。証拠が不足している場合、最善の出力は、より流暢な推測の文章ではなく、「この情報はまだ確認できない」である可能性があります。
また、上表はワークフローの提案であり、汎用的な API パラメータ表ではありません。実際に利用可能なレベルとパラメータ名は、具体的なモデルと連携ドキュメントに従う必要があります。
¶ 四、「キャッシュで 95% 節約」は魅力的だが、計算を間違えないように
キャッシュは、大量コンテンツ制作において最も注目すべき最適化ポイントの一つかもしれません。
ブランド紹介、執筆ガイドライン、固定用語集、レビュー要件……これらの資料は、毎回のリクエストで繰り返し表示されることがよくあります。OpenAI は、安定した指示と参考資料を変更されるタスクの詳細より前に置き、ツール定義を一貫させることで、共有コンテキストを再利用しやすくすることを推奨しています。公式ガイドでは、キャッシュされた入力の料金は、モデルによってはキャッシュされていない入力と比べて最大 95% 削減できると述べられています。
ただし、ここでは必ず明確に理解する必要があります:
キャッシュ入力が 95% 安くなることは、記事全体の制作コストが 95% 下がることを意味しません。 公式発表の GPT-6.1 Sol 標準 API 価格を例にすると:100万入力 token あたり2ドル、キャッシュ入力は0.10ドル、出力は10ドルです。ここで引用しているのは OpenAI 公式の標準価格であり、当サイトまたは第三者の接続チャネルにおける実際の見積もりを示すものではありません。価格変更については、サービス提供者の最新ページをご確認ください。
デモ用の計算例であり、実測結果ではありません:
あるタスクに以下があると仮定します:
- 20,000 個の入力 token;
- そのうち 15,000 個はキャッシュにヒットできる;
- 3,000 個の出力 token。
| 費用項目 | すべての入力がキャッシュ未ヒット | 15,000 個の入力がキャッシュヒット |
|---|---|---|
| 非キャッシュ入力 | $0.0400 | $0.0100 |
| キャッシュ入力 | $0 | $0.0015 |
| 出力 | $0.0300 | $0.0300 |
| 合計 | $0.0700 | $0.0415 |
この仮定で計算すると、token 費用は約 40.7% 下がるのであり、95% ではありません。
さらに、ここにはツール呼び出し、失敗時の再試行、人的レビュー、および適用される可能性があるその他の費用は含まれていません。
したがって、より信頼できるやり方は、プロンプトを2層に分けることです:
安定層:ブランドガイドライン、文体、出力形式、レビュー規則。
動的層:今回のテーマ、対象読者、新たに検索された資料、現在のタスク要件。
そして、「最大割引」を見ただけでそのままプロジェクト予算に書き込むのではなく、実際のリクエストにおけるキャッシュヒット状況を観察します。
¶ 五、マルチエージェントは調査に非常に適しているが、にぎやかにするための分業には適していない
研究型の記事には、多くの場合、独立して進められるいくつかのタスクが含まれます:
- 公式ドキュメントを調べる;
- 実際の事例を探す;
- よくある質問を収集する;
- 価格と機能を照合する;
- 異なる情報源の間にある相違を整理する。
これらのタスクには一定の独立性があり、並列処理に適しています。
OpenAI のガイドでは、GPT-6.1 Sol は Responses API において独立したタスクをサブエージェントに割り当て、その後に結果を統合できると紹介されています。このマルチエージェント機能はガイド内で beta と表記されています。
ただし、マルチエージェントは無料で得られる効率向上ではありません。
Anthropic がその研究システムをエンジニアリング面から振り返った記事では、マルチエージェントは複数の独立した方向へ展開する調査に適している一方で、token 消費を大幅に増やすと言及されています。彼らが観察したデータでは、マルチエージェントシステムの token 使用量は通常のチャットの約15倍でした。この数字は特定のシステムにおける経験則であり、すべての製品にそのまま当てはめることはできません。
そのため、私は次のように進めることをよりおすすめします:
複数のエージェントにそれぞれ証拠を探させ、1人の編集者が記事を統一的に構成し、その後に人間がチェックする。
5つのエージェントにそれぞれ5つの段落を書かせ、そのままつなぎ合わせてはいけません。そうすると、重複、矛盾、文体の不統一が起こりやすくなります。
以下は、コンテンツチームが始める際に適したフローのイメージです:
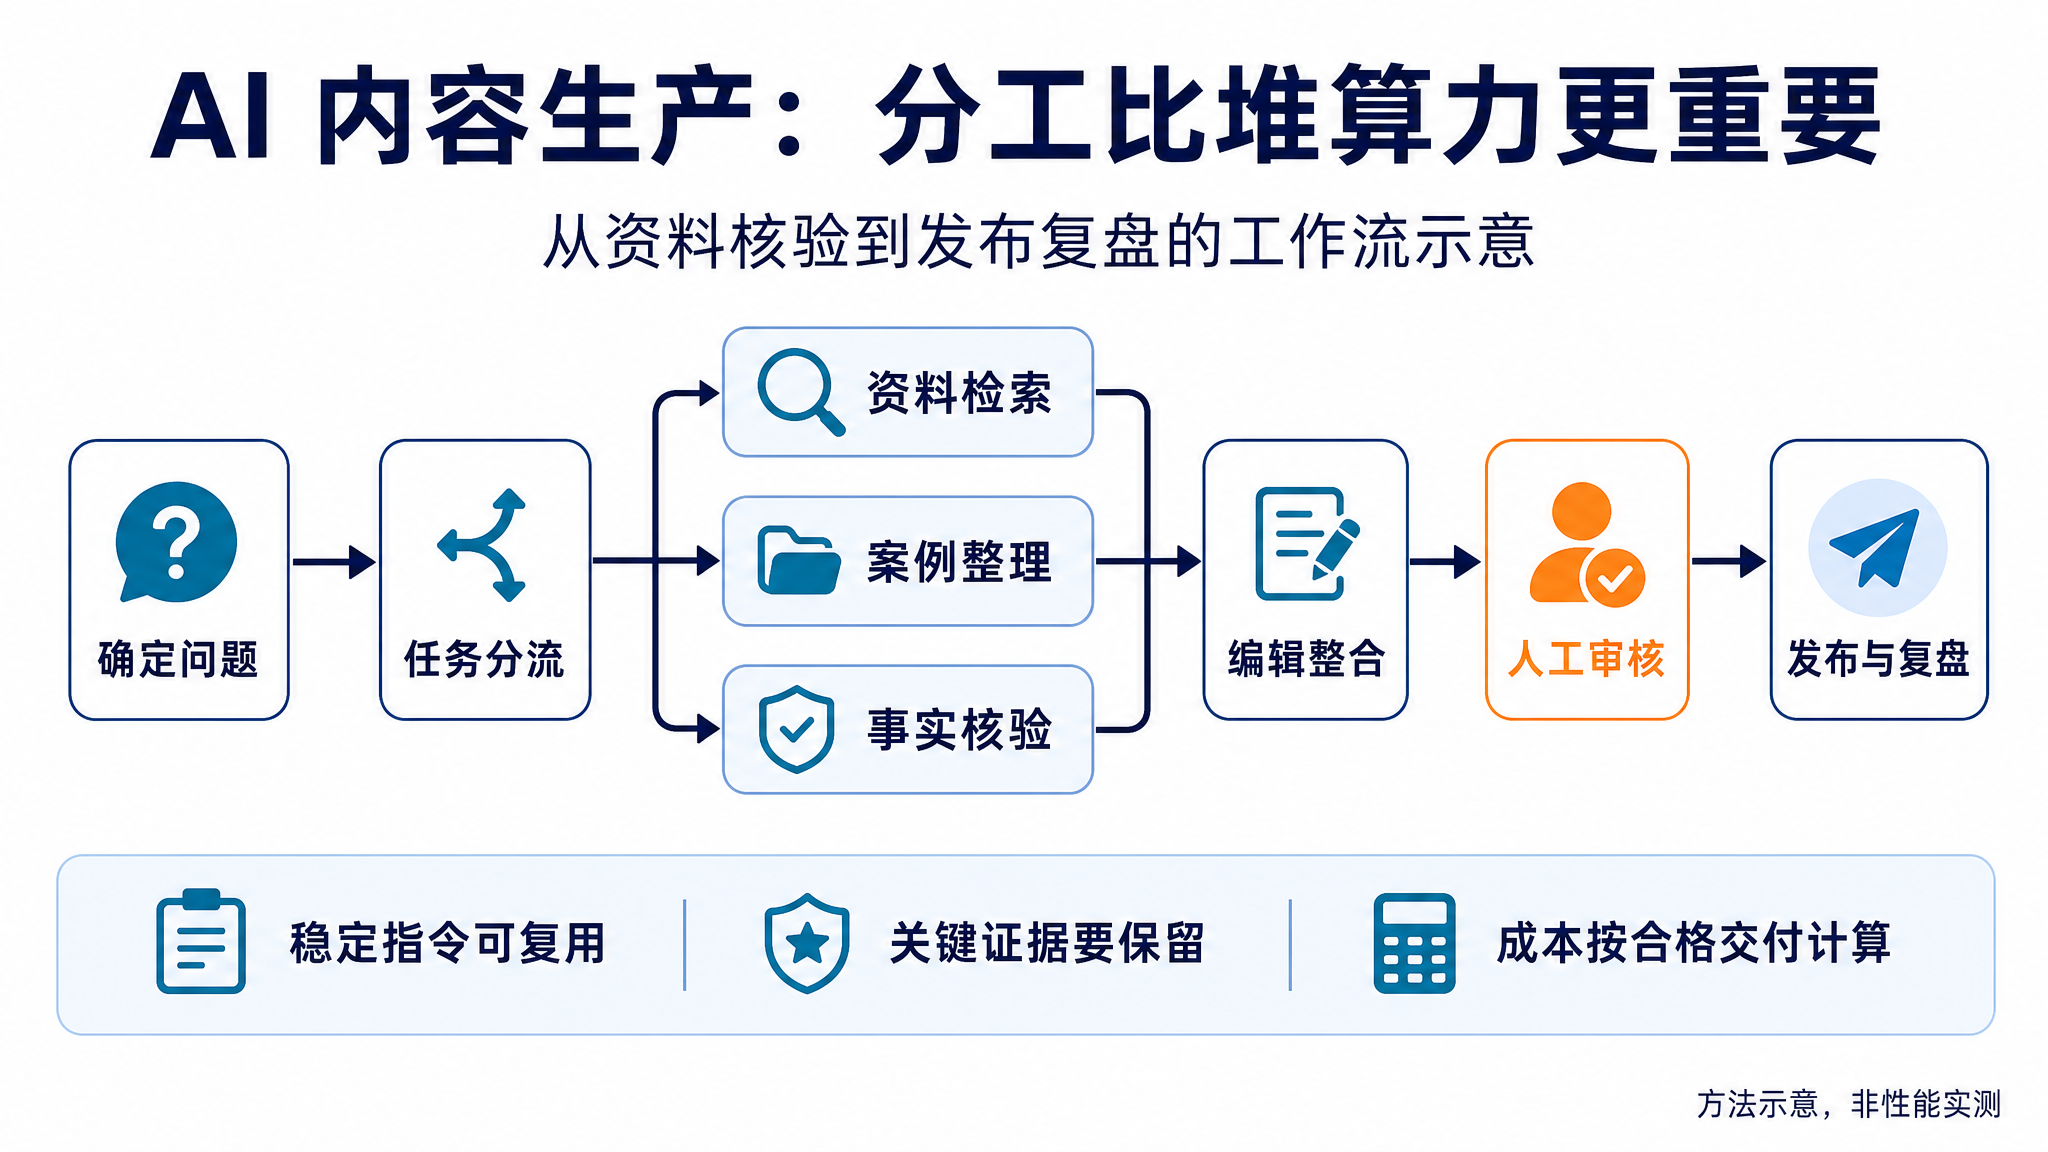
図は GPT Image 2 により生成された方法のイメージであり、性能の実測を示すものではありません。
このフローを本当に役立つものにするには、各サブタスクで4つのものを提出するのが望ましいです:
- 結論:何を発見したか。
- 情報源:証拠はどこにあるか。
- 制限:どのような状況では適用できないか。
- 確認待ちの項目:まだ結論を出せないことは何か。
特に注意すべきなのは、ファクトチェックとは別のモデルに「この文章は問題ない」と思わせることではなく、情報源と改めて照合させることです。
複数のエージェントの意見が一致しても、事実が証明されたことにはなりません。
¶ 六、長いタスクでは状態を保存し、自動操作では権限を明確に区切る
短い文章を作るのであれば、資料をコンテキストに入れるだけで十分かもしれません。シリーズ特集を作ったり、製品ドキュメントを継続的に保守したりする場合は、話が変わります。
OpenAI のガイドでは、長い対話のコンテキスト量を減らしつつ、タスク継続に必要な状態を保持するためのコンテキスト圧縮が紹介されています。
コンテンツ業務においては、どのような圧縮方式を採用するかにかかわらず、タスク記録を別途維持することをおすすめします:
- 確認済みの事実とその情報源;
- 現在使用している製品バージョン;
- まだ解消されていない資料間の矛盾;
- 完了済みおよび未完了の工程;
- 人間による確認が必須の判断。
「この問題はすでに調査した」のような曖昧な要約だけを残してはいけません。その後の執筆で本当に必要なのは、証拠と境界です。
自動操作についても同様です。公式ガイドでは、API または接続済みのツールで直接完了できる手順については、これらの方法を優先して使用し、画面の読み取り、クリック、フォーム入力が必要な場合にのみ、コンピュータ操作能力を検討することを推奨しています。
ブログのフローでは、AI に草稿の自動整理、リンクチェック、画像生成を許可してもよいですが、正式公開、記事の削除、オンライン設定の変更は人間の確認後に行うべきです。
管理画面を操作できることは、無制限の権限を持つべきことを意味しません。
¶ 七、GEO に戻る:速く書けることは、AI に引用されやすくなることと同義ではない
ここまで来たら、2つの問題を分ける必要があります:
- AI を使ってコンテンツ制作の効率を上げる;
- コンテンツを生成検索の回答で発見・引用されやすくする。
前者はワークフローの問題であり、後者こそが GEO が注目する核心です。
初期の GEO 研究では、生成エンジンにおけるコンテンツの可視性が扱われ、その評価設定において最大約40%の可視性向上が報告されるとともに、分野ごとに効果の違いがあることも指摘されています。この結果を、「その通りにやれば当サイトのトラフィックが40%増える」と直接理解することはできません。
Google の公式説明は、より実務的です:AI Overviews と AI Mode について、追加の特別な最適化要件は必要ありません。基礎的な SEO、信頼できる人間中心のコンテンツは、依然として重要です。ページがインデックスされ、要約として表示される資格を備えて初めて、サポートリンクとして表示される機会を得られます。
これはすべての AI 検索製品のルールを代表するものではありませんが、少なくとも、いわゆる「万能 GEO テンプレート」を急いで探さないよう私たちに注意を促しています。 本サイトのブログについては、まず以下の点をしっかり行うことをよりおすすめします。
¶ 1. 1本の記事で1つの実際の問題を解決する
「AIの未来を徹底解説する」は大きく聞こえますが、必ずしも役に立つとは限りません。
「商品説明文を一括生成する際、キャッシュが本当にコスト削減につながっているかをどう判断するか」のほうが、かえって説明しやすく、読者も直接活用しやすくなります。
¶ 2. 数字に適用条件を補う
「コストが40%低下」とだけ書かないでください。
どのモデルを使用したのか、どのように計算したのか、出力・ツール・人件費を含むのか、またその数字が実験結果なのかデモ用の試算例なのかを説明する必要があります。
¶ 3. 重要な内容を画像だけに隠さない
Googleは、重要な内容をテキスト形式で表示し、構造化データもページ上で見える内容と一致させることを明確に推奨しています。
したがって、グラフは理解の助けになりますが、本文でも結論、データ、条件を説明する必要があります。
¶ 4. 事実、提案、予測を分ける
「公式ドキュメントがある機能をサポートしている」は一種の情報です。
「私たちはコンテンツチームにこのような使い方を勧める」は別の種類です。
「将来、ある変化をもたらす可能性がある」はさらに第三の種類です。
これらを明確に区別することは、すべての文を断定的に書くことよりも価値があります。
¶ 5. 実際の結果を観察し、自己評価スコアを盲信しない
固定の質問セットを作成し、異なるAI検索製品が定期的に本サイトを引用しているか、どの記事を引用しているか、その引用は正確かを記録し、実際のアクセスやコンバージョン分析と組み合わせることができます。
このような追跡も時間、地域、製品差の影響を受けますが、少なくとも公開された根拠のない「GEO高スコア」を記事につけるよりは参考価値があります。
¶ 8. 本当に最適化すべきなのは「1本の合格記事のコスト」
コンテンツチームは、1日に何本生成できるか、1本あたり何token消費するかという2つの数字に注目しがちです。
しかし、100本生成して、最終的に公開できるのが20本だけなら、その効率は必ずしも高くありません。
私がよりおすすめするのは、次の指標を見ることです。
1本の合格コンテンツコスト = 総制作コスト ÷ 審査を通過した記事数
そのうち、総制作コストには、最初の生成費用だけでなく、モデル呼び出し、検索ツール、手戻り、人的レビューを含めるべきです。
実際に導入する際は、まず代表的なタスクをいくつか選んで小規模なテストを行い、最初からサイト全体に展開しないようにできます。
重点的に記録する項目は次のとおりです。
| 指標 | 答えるべき問題 |
|---|---|
| 事実誤り率 | 捏造、古い情報、バージョンの混同はないか? |
| 情報源の追跡可能性 | 重要な結論の原典を見つけられるか? |
| 初回レビュー通過率 | 大幅な手戻りを必要としないコンテンツはどのくらいあるか? |
| 1本の合格コスト | 失敗したタスクと人手を含めた後、実際にいくらかかったか? |
| 納品までの時間 | 検索開始から公開可能になるまで、どれくらいかかるか? |
| 公開後の効果 | 有効なアクセス、引用、またはビジネスコンバージョンにつながるか? |
テスト後に、どのタスクを低優先度で処理するか、どの工程で推論への投入を増やすか、どの調査を並行して行う価値があるか、どの手順を必ず人に任せるかを決定します。
¶ 最後に:賢さを使うべきところで使う
GPT-6はコンテンツチームにより多くの選択肢を提供しますが、選択肢が増えたからといって、すべての工程で最強の構成を使う必要があるわけではありません。
より試す価値のある方向性は次のとおりです。
単純なタスクは軽量に処理し、複雑な判断は真剣に推論し、繰り返されるコンテキストはできるだけ再利用し、独立した調査は適度に並行して進め、正式公開前にはレビューを残す。
GEOについても同じです。
どのモデルも、1本の記事が引用されることを保証することはできません。私たちにできるのは、実際の問題に答え、追跡可能な証拠を提供し、適用範囲を明確に説明することです。
結局のところ、本当に追求すべきなのは「AIにもっと書かせること」ではなく、次のことです。
公開するすべてのコンテンツを、より読む価値があり、より検証に耐えられるものにすること。
¶ 参考資料
- OpenAI:GPT-6 実践ガイド
- OpenAI:Introducing GPT-6.1 Sol
- Anthropic:How we built our multi-agent research system
- GEO: Generative Engine Optimization(KDD 2024)
- Google Search Central:AI features and your website
本稿は資料の整理および応用分析であり、本サイトにおける性能実測ではありません。モデルの能力、テスト段階、価格は変更される可能性があるため、サービス提供者の最新ドキュメントを基準にしてください。