Il cambiamento portato da GPT-6 non è solo che il modello è più intelligente, ma che possiamo distribuire i compiti in modo più granulare, controllare l’investimento nel ragionamento e riutilizzare il contesto. Per i team che si occupano di contenuti e GEO, ciò che vale davvero la pena studiare non è “quale modello è il più forte”, ma come rendere più affidabile il flusso di ricerca, scrittura, verifica e pubblicazione, riducendo al tempo stesso il costo di ogni contenuto idoneo.
¶ 1. I modelli sono sempre più forti, perché i contenuti continuano a non funzionare bene?
Se hai usato l’AI per scrivere articoli in blocco, molto probabilmente hai incontrato una situazione del genere: a prima vista, la struttura è completa, le frasi sono fluide e perfino il riepilogo sembra piuttosto sensato. Ma controllando attentamente, scopri che i dati non hanno fonti, che le versioni dei prodotti non corrispondono, oppure che sono state scritte duemila parole senza comunque rispondere alla domanda che più interessa al lettore.
A questo punto, la soluzione che viene più facilmente in mente è: cambiare con un modello più forte.
Ma io suggerisco prima di chiedersi: il problema risiede davvero nelle capacità del modello o nel flusso di lavoro?
Se non ci sono materiali affidabili, confini chiari del compito e nemmeno una fase di verifica prima della pubblicazione, cambiare modello potrebbe non risolvere il problema alla radice.
La guida all’uso di GPT-6 di OpenAI, in realtà, non si sviluppa solo attorno al “potenziamento delle capacità”, ma discute insieme selezione del modello, livello di ragionamento, caching, compressione del contesto e collaborazione multi-agente. Ciò che enfatizza è: far sì che capacità diverse servano compiti specifici e misurare, prima del rilascio, il tasso di successo, la latenza e il costo di ogni compito completato con successo.
Per i team di contenuti, questo approccio è molto pratico: non pensare solo a far scrivere di più all’AI, prima fai in modo che consegni in modo più stabile.
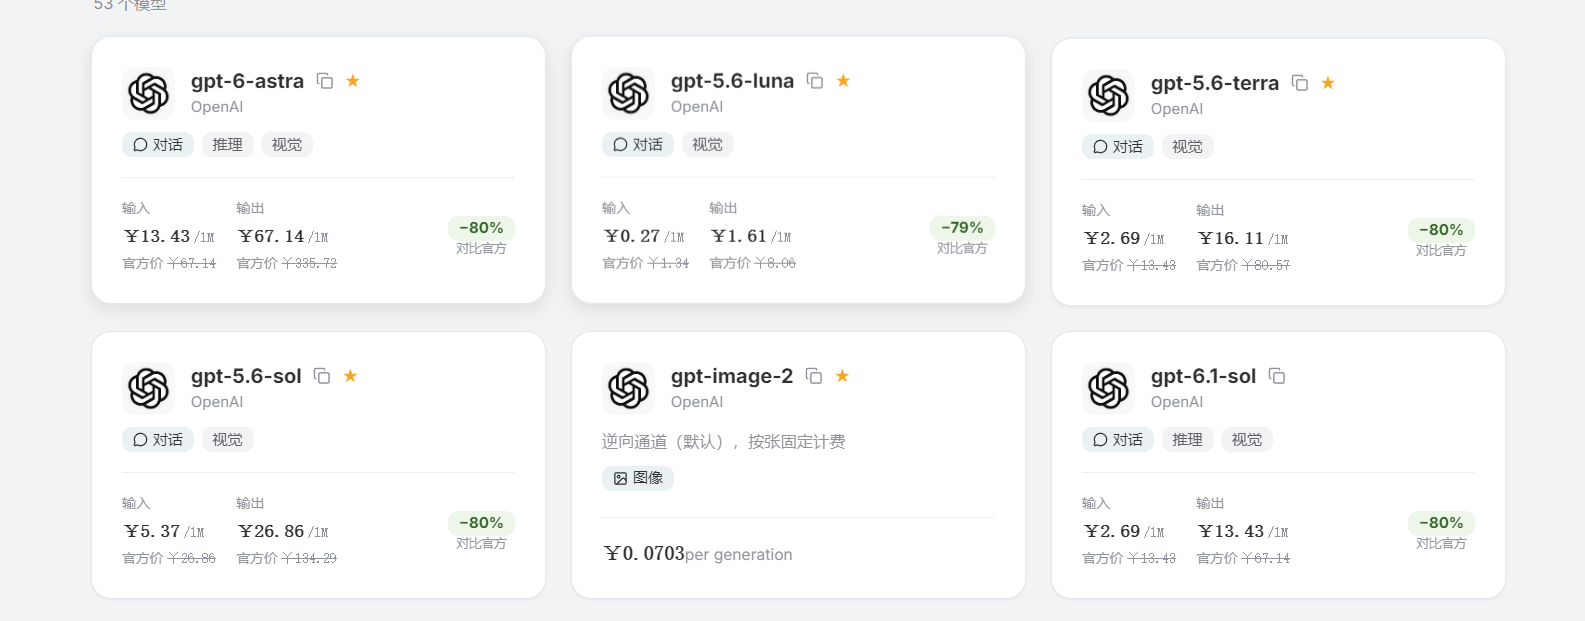
¶ 2. Come scegliere Astra, Sol e Luna? Considerali come ruoli diversi
Secondo il posizionamento della suddetta guida ufficiale di OpenAI, GPT-6 Astra è rivolto ai lavori di ragionamento più difficili; GPT-6.1 Sol è rivolto alla programmazione complessa, alla ricerca e alle operazioni al computer; GPT-6 Luna è invece più orientato a compiti ripetitivi con obiettivi chiari e che richiedono elaborazione su larga scala, come estrazione di campi, classificazione e riepiloghi strutturati.
Piuttosto che memorizzare rigidamente i parametri, è meglio intenderli come ruoli diversi all’interno di un team.
La tabella seguente contiene consigli di selezione basati sul business dei contenuti, e non è una classifica ufficiale delle prestazioni:
| Fase dei contenuti | Modello consigliato da valutare prioritariamente | Considerazione principale |
|---|---|---|
| Classificazione degli articoli, estrazione di campi, riepiloghi in formato fisso | GPT-6 Luna | Il compito è chiaro, prima si valutano la correttezza del formato e il costo unitario |
| Ricerca da più fonti, organizzazione dei materiali, integrazione degli articoli | GPT-6.1 Sol | Sono necessari giudizi trasversali tra materiali ed esecuzione in più passaggi |
| Analisi di controversie, argomentazioni complesse, revisione di contenuti importanti | GPT-6 Astra | Il costo degli errori è più alto, sono necessari giudizi più approfonditi |
Per esempio, stiamo preparando un articolo su “come le imprese scelgono le interfacce AI”. Per estrarre i campi relativi a prezzi e funzionalità dalla documentazione di ciascun fornitore, non è necessario usare fin dall’inizio il modello più forte; per analizzare i compromessi tra diverse soluzioni in contesti aziendali complessi, invece, vale la pena investire più risorse di ragionamento.
Naturalmente, questo non significa che i contenuti gestiti dai “modelli piccoli” non debbano essere controllati. Informazioni come prezzi, unità di fatturazione e numeri di versione possono contenere errori, anche se si tratta soltanto di estrazione.
Un compito semplice significa solo che il metodo di elaborazione può essere più leggero, non che gli standard di accettazione possano essere più permissivi.
¶ 3. Il livello di ragionamento non è migliore quanto più è alto, dipende dal fatto che questo passaggio ne valga la pena
Dopo aver scelto il modello, c’è un’altra variabile facilmente trascurata: l’investimento nel ragionamento.
La guida di OpenAI descrive il livello di ragionamento come un compromesso tra capacità e prezzo: Low corrisponde a estrazioni convenzionali o piccole modifiche, Medium è usato per lavori che richiedono giudizio, High è usato per analisi approfondite e revisioni attente; livelli superiori dovrebbero essere utilizzati solo quando il modello li supporta e i benefici aggiuntivi valgono il tempo e il costo.
Detto più chiaramente:
- Per modificare un titolo, non è necessario far ragionare il modello ripetutamente.
- Per confrontare tre soluzioni aziendali, si può dare più spazio alla riflessione.
- Per stabilire se due materiali presentano un conflitto sostanziale, vale la pena analizzare seriamente.
Puoi iniziare i test con questo approccio:
| Compito | Punto di partenza consigliato | Quando aumentare |
|---|---|---|
| Classificazione delle etichette, conversione di formato | Basso investimento nel ragionamento | Compaiono evidenti ambiguità o conflitti tra regole |
| Scaletta dell’articolo, confronto tra soluzioni | Medio investimento nel ragionamento | Non riesce a spiegare i compromessi, omette condizioni chiave |
| Analisi dei conflitti fattuali, revisione di conclusioni importanti | Alto investimento nel ragionamento | I problemi chiave non sono ancora risolti, quindi si testano livelli superiori |
C’è qui una distinzione importante: pensare più a lungo non equivale a conoscere più fatti.
Se il compito richiede prezzi aggiornati o informazioni su prodotti appena rilasciati, la priorità è integrare le fonti, non semplicemente aumentare il livello di ragionamento. In assenza di prove, il miglior output potrebbe essere “questa informazione non può ancora essere confermata”, anziché una supposizione più fluida.
Inoltre, la tabella sopra è un consiglio di flusso di lavoro, non una tabella universale dei parametri API. I livelli e i nomi dei parametri effettivamente disponibili devono fare riferimento al modello specifico e alla documentazione di integrazione.
¶ 4. “La cache fa risparmiare il 95%” è molto allettante, ma non fare male i conti
La cache potrebbe essere uno dei punti di ottimizzazione più degni di attenzione nella produzione di contenuti in blocco.
Presentazioni del brand, linee guida di scrittura, glossari terminologici fissi, requisiti di revisione… questi materiali compaiono spesso ripetutamente in ogni richiesta. OpenAI suggerisce di collocare istruzioni stabili e materiali di riferimento prima dei dettagli variabili del compito, mantenendo al contempo coerenti le definizioni degli strumenti, così da riutilizzare il contesto condiviso. La guida ufficiale menziona che il costo degli input memorizzati nella cache può ridursi fino al 95% rispetto agli input non memorizzati nella cache, a seconda del modello.
Ma qui bisogna assolutamente vedere con chiarezza:
Che gli input memorizzati nella cache costino il 95% in meno non significa che il costo di produzione dell’intero articolo diminuisca del 95%. Prendiamo come esempio i prezzi API standard ufficialmente pubblicati per GPT-6.1 Sol: 2 dollari per milione di token in input, 0,10 dollari per input memorizzato nella cache e 10 dollari per output. Qui sono citati i prezzi standard ufficiali di OpenAI, che non rappresentano le offerte effettive di questo sito o di canali di accesso di terze parti; per le variazioni di prezzo, fare riferimento all'ultima pagina del fornitore di servizi.
Facciamo un esempio dimostrativo, non un risultato misurato:
Supponiamo che un'attività abbia:
- 20.000 token in input;
- di cui 15.000 possono colpire la cache;
- 3.000 token in output.
| Voce di costo | Tutti gli input non colpiscono la cache | 15.000 input colpiscono la cache |
|---|---|---|
| Input non memorizzato nella cache | $0.0400 | $0.0100 |
| Input memorizzato nella cache | $0 | $0.0015 |
| Output | $0.0300 | $0.0300 |
| Totale | $0.0700 | $0.0415 |
Calcolando secondo questa ipotesi, il costo dei token diminuisce di circa il 40,7%, non del 95%.
Inoltre, questo non include ancora chiamate agli strumenti, tentativi falliti, revisione umana e altri costi eventualmente applicabili.
Pertanto, un approccio più affidabile è dividere il prompt in due livelli:
Livello stabile: linee guida del brand, stile di scrittura, formato di output, regole di revisione.
Livello dinamico: argomento di questa volta, lettori target, materiali appena recuperati, requisiti dell'attività corrente.
Poi osservare la situazione reale dei colpi in cache nelle richieste, invece di inserire direttamente nel budget del progetto lo “sconto massimo” non appena lo si vede.
¶ V. I multi-agenti sono molto adatti alla ricerca, ma non alla divisione del lavoro solo per vivacità
Un articolo di ricerca spesso include diversi compiti che possono procedere in modo indipendente:
- consultare la documentazione ufficiale;
- trovare casi reali;
- raccogliere domande frequenti;
- verificare prezzi e funzionalità;
- organizzare le divergenze tra fonti diverse.
Questi compiti hanno una certa indipendenza e sono adatti all'elaborazione parallela.
La guida di OpenAI presenta come GPT-6.1 Sol possa assegnare compiti indipendenti a sub-agenti nella Responses API e poi raccogliere i risultati; questa capacità multi-agente è indicata nella guida come beta.
Tuttavia, i multi-agenti non sono un aumento gratuito dell'efficienza.
Nella sua retrospettiva ingegneristica sul sistema di ricerca, Anthropic afferma che i multi-agenti sono adatti a ricerche che si sviluppano in più direzioni indipendenti, ma aumentano significativamente il consumo di token; nei dati da loro osservati, l'uso di token di un sistema multi-agente era circa 15 volte quello di una normale chat. Questo numero appartiene all'esperienza del loro sistema specifico e non può essere applicato direttamente a tutti i prodotti.
Pertanto, consiglio maggiormente questa organizzazione:
Lasciare che più agenti trovino separatamente le prove, lasciare che un editor organizzi uniformemente l'articolo e poi farlo verificare da una persona.
Non lasciare che cinque agenti scrivano cinque paragrafi separatamente per poi unirli direttamente. In questo modo è molto facile che compaiano ripetizioni, contraddizioni e incoerenze nello stile.
Di seguito è riportato uno schema di processo adatto a un team di contenuti agli inizi:
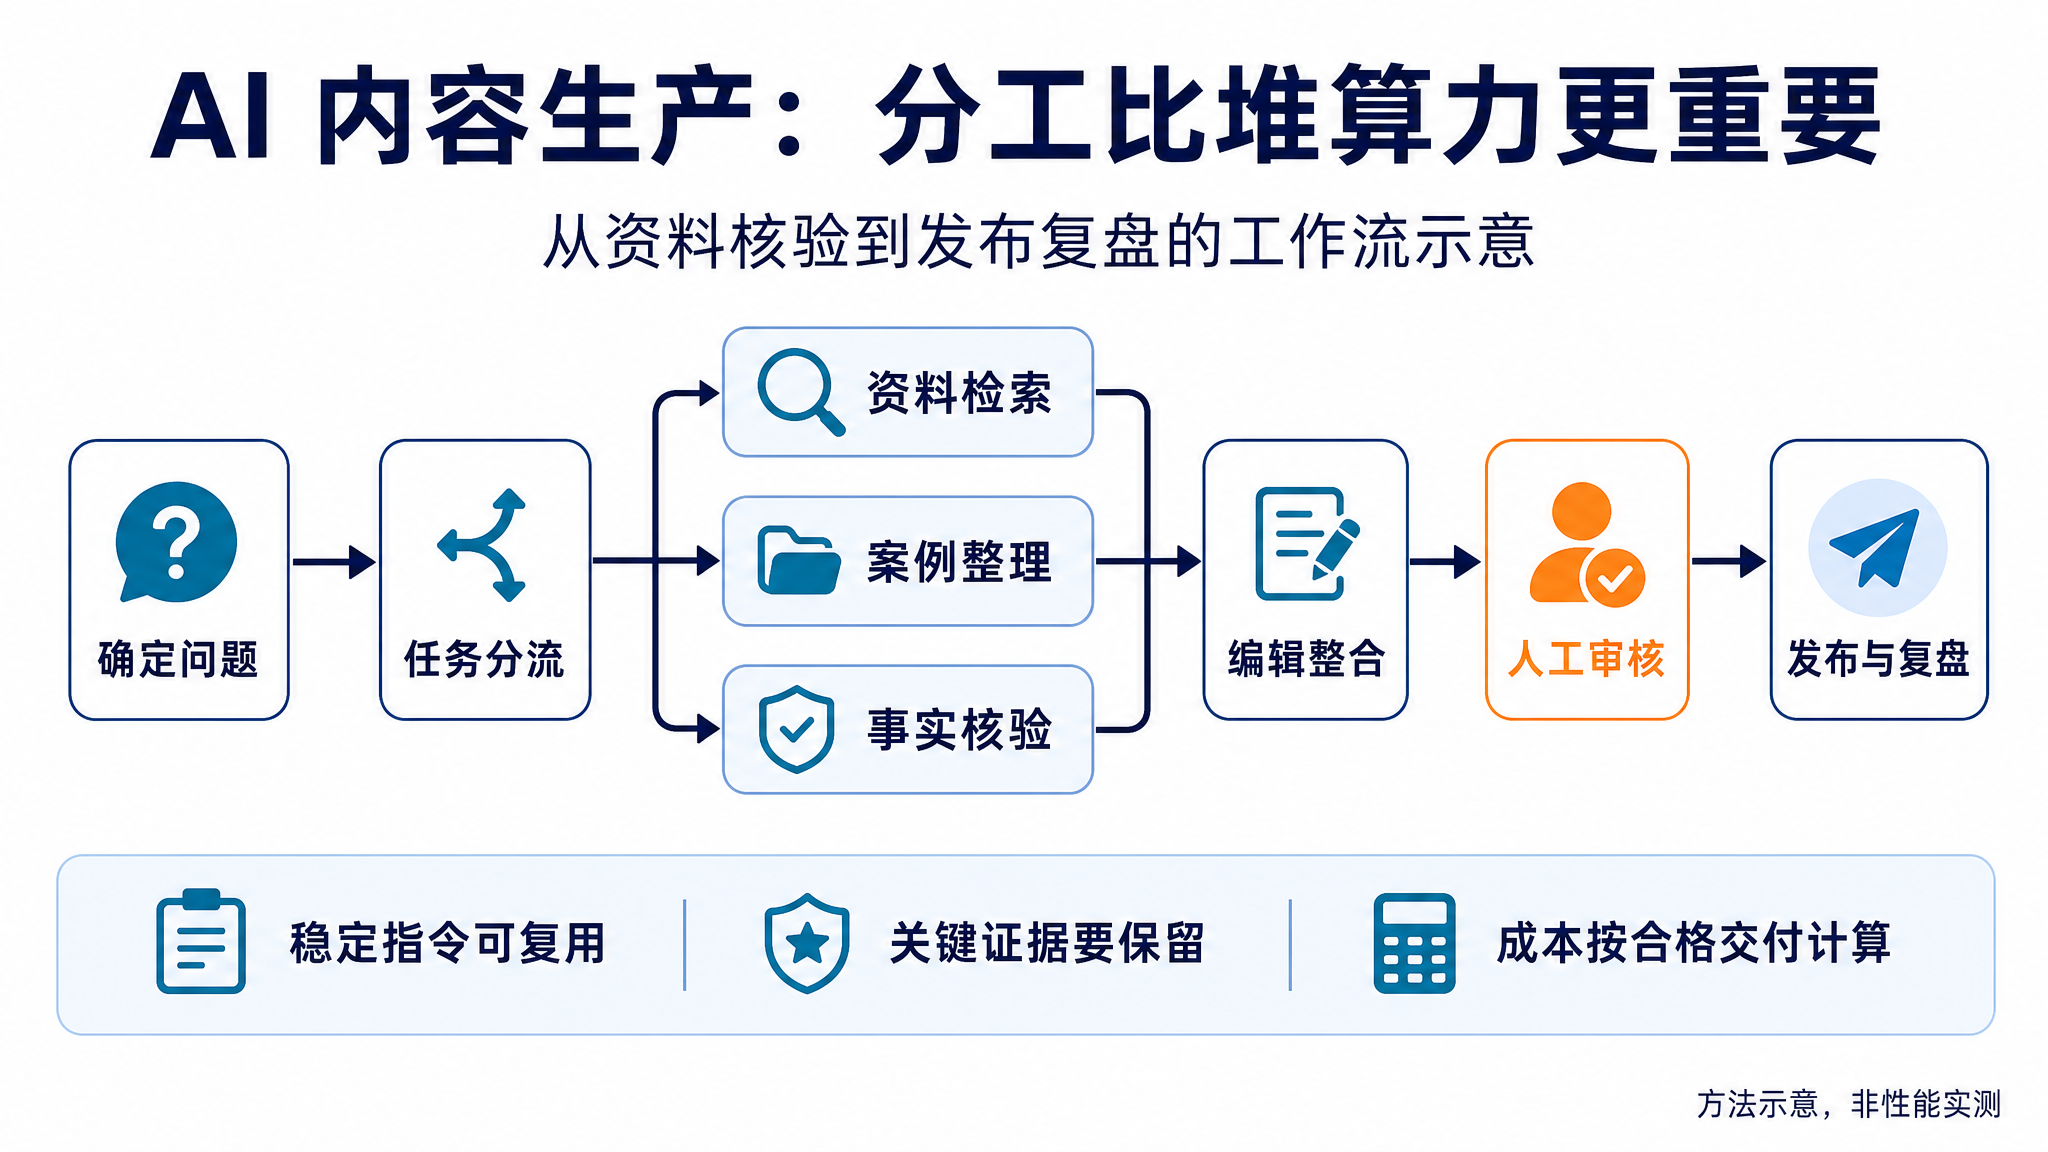
L'immagine è uno schema del metodo generato da GPT Image 2 e non rappresenta test misurati delle prestazioni.
Per rendere questo processo davvero utile, ogni sottoattività dovrebbe preferibilmente consegnare quattro elementi:
- Conclusione: che cosa è stato scoperto.
- Fonte: dove si trovano le prove.
- Limitazioni: a quali situazioni non si applica.
- Elementi da confermare: su che cosa non è ancora possibile trarre conclusioni.
Occorre prestare particolare attenzione: la verifica dei fatti non consiste nel far “ritenere a un altro modello che questo passaggio non abbia problemi”, ma nel fargli confrontare nuovamente le fonti.
Il fatto che più agenti siano d'accordo non significa che il fatto sia già stato dimostrato.
¶ VI. Le attività lunghe devono salvare lo stato, le operazioni automatiche devono delimitare chiaramente i permessi
Per scrivere un breve testo, potrebbe bastare inserire i materiali nel contesto. Per realizzare dossier in serie o mantenere continuamente la documentazione di prodotto, il problema è diverso.
La guida di OpenAI presenta la compressione del contesto, utilizzata per ridurre il volume del contesto delle conversazioni lunghe mantenendo al contempo lo stato necessario per continuare l'attività.
Per il lavoro sui contenuti, consiglio di mantenere separatamente una registrazione dell'attività, indipendentemente dal metodo di compressione adottato:
- fatti confermati e relative fonti;
- versione del prodotto attualmente utilizzata;
- conflitti tra materiali non ancora risolti;
- fasi completate e non completate;
- decisioni che devono essere confermate da una persona.
Non lasciare soltanto un riepilogo vago come “abbiamo già studiato questo problema”. Ciò di cui la scrittura successiva ha realmente bisogno sono prove e confini.
Lo stesso vale per le operazioni automatiche. La guida ufficiale suggerisce di dare priorità ai passaggi che possono essere completati direttamente tramite API o strumenti già collegati; quando è necessario leggere lo schermo, fare clic o compilare moduli, considerare allora le capacità di operazione al computer.
Per il flusso del blog, si può consentire all'AI di organizzare automaticamente le bozze, controllare i link e generare immagini, ma lasciare la pubblicazione formale, l'eliminazione degli articoli e la modifica delle configurazioni online dopo la conferma umana.
Saper operare nel backend non significa dover avere permessi illimitati.
¶ VII. Torniamo alla GEO: scrivere più velocemente non significa essere citati più facilmente dall'AI
A questo punto, è necessario separare due questioni:
- usare l'AI per aumentare l'efficienza della produzione di contenuti;
- rendere i contenuti più facili da trovare e citare nelle risposte della ricerca generativa.
La prima è una questione di flusso di lavoro, mentre la seconda è il vero fulcro dell'attenzione della GEO.
La ricerca GEO iniziale si è concentrata sulla visibilità dei contenuti nei motori generativi e ha riportato, nella sua configurazione di valutazione, un miglioramento della visibilità fino a circa il 40%, sottolineando al contempo che gli effetti variano tra i diversi settori. Questo risultato non può essere interpretato direttamente come “facendo così, il traffico di questo sito aumenterà del 40%”.
La spiegazione ufficiale di Google è invece più pragmatica: per AI Overviews e AI Mode non è necessaria una serie aggiuntiva di requisiti di ottimizzazione speciali; SEO di base e contenuti affidabili e incentrati sulle persone restano importanti. Una pagina deve essere idonea all'indicizzazione e alla visualizzazione di riepiloghi per avere la possibilità di apparire come link di supporto.
Questo non può rappresentare le regole di tutti i prodotti di ricerca AI, ma almeno ci ricorda: non affrettiamoci a cercare il cosiddetto “modello GEO universale”. Per il blog di questo sito, consiglio maggiormente di fare prima bene le seguenti cose.
¶ 1. Un articolo risolve un problema reale
“Analisi completa del futuro dell’IA” suona molto importante, ma non è necessariamente utile.
“Generare in batch testi per prodotti: come valutare se la cache fa davvero risparmiare”, al contrario, è più facile da spiegare chiaramente e più comodo da applicare direttamente per i lettori.
¶ 2. Aggiungere le condizioni di applicabilità ai numeri
Non scrivere solo “costo ridotto del 40%”.
Bisogna spiegare quale modello viene usato, come viene calcolato, se include output, strumenti e costi umani, e se questo numero è un risultato sperimentale o un esempio dimostrativo.
¶ 3. Non nascondere i contenuti chiave solo nelle immagini
Google consiglia chiaramente di presentare i contenuti importanti in forma testuale e i dati strutturati dovrebbero anche essere coerenti con i contenuti visibili della pagina.
Quindi, i grafici possono aiutare la comprensione, ma il testo principale deve comunque spiegare conclusioni, dati e condizioni.
¶ 4. Separare fatti, consigli e previsioni
“La documentazione ufficiale supporta una certa funzionalità” è un tipo di informazione.
“Noi consigliamo al team dei contenuti di usarla in questo modo” è un altro tipo.
“In futuro potrebbe portare un certo cambiamento” è un terzo tipo.
Distinguerli chiaramente ha più valore che scrivere tutte le frasi in modo categorico.
¶ 5. Osservare i risultati reali, senza credere ciecamente ai punteggi di autovalutazione
Si può creare un insieme fisso di domande e registrare periodicamente se diversi prodotti di ricerca IA citano questo sito, quale articolo citano e se la citazione è accurata, per poi combinarlo con l’analisi delle visite effettive e delle conversioni.
Questo tipo di monitoraggio sarà comunque influenzato da tempo, area geografica e differenze tra prodotti, ma almeno ha più valore di riferimento rispetto all’assegnare a un articolo un “alto punteggio GEO” senza basi pubbliche.
¶ Otto, ciò che va davvero ottimizzato è il “costo di ogni articolo idoneo”
I team dei contenuti tendono facilmente a concentrarsi su due numeri: quanti articoli vengono generati in un giorno e quanti token consuma ogni articolo.
Ma se vengono generati 100 articoli e alla fine solo 20 possono essere pubblicati, questa efficienza potrebbe non essere molto alta.
Consiglio maggiormente di considerare questo indicatore:
Costo per singolo contenuto idoneo = costo totale di produzione ÷ numero di articoli che superano la revisione
Tra questi, il costo totale di produzione dovrebbe includere chiamate al modello, strumenti di recupero, rifacimenti e revisione umana, e non solo il costo della prima generazione.
Nell’implementazione pratica, si può prima scegliere un gruppo di attività rappresentative per effettuare test su piccola scala, senza estendere tutto al sito fin dall’inizio.
Concentrarsi sulla registrazione di:
| Indicatore | Domanda a cui rispondere |
|---|---|
| Tasso di errori fattuali | Ci sono invenzioni, informazioni obsolete o confusioni tra versioni? |
| Tracciabilità delle fonti | È possibile trovare le fonti originali delle conclusioni chiave? |
| Tasso di approvazione alla prima revisione | Quanti contenuti non richiedono grandi rifacimenti? |
| Costo per singolo contenuto idoneo | Dopo aver incluso attività fallite e lavoro umano, quanto si è realmente speso? |
| Durata della consegna | Dall’inizio del recupero fino alla possibilità di pubblicare, quanto tempo serve? |
| Effetti dopo la pubblicazione | Produce visite efficaci, citazioni o conversioni commerciali? |
Dopo il test, decidere quali attività gestire a un livello inferiore, in quali passaggi aumentare l’investimento nel ragionamento, quali ricerche meritano di essere svolte in parallelo e quali passaggi devono essere affidati alle persone.
¶ In conclusione: usare l’intelligenza dove serve
GPT-6 offre più scelte ai team dei contenuti, ma avere più scelte non significa che ogni passaggio debba usare la configurazione più potente.
Una direzione più degna di essere provata è:
gestire in modo leggero le attività semplici, ragionare seriamente sulle valutazioni complesse, riutilizzare il più possibile i contesti ripetuti, svolgere in parallelo in modo moderato le ricerche indipendenti e mantenere la revisione prima della pubblicazione ufficiale.
Per il GEO, vale lo stesso.
Nessun modello può garantire che un articolo venga citato. Ciò che possiamo fare è fare in modo che risponda a problemi reali, fornisca prove tracciabili e spieghi chiaramente il proprio ambito di applicazione.
In definitiva, ciò che vale davvero la pena perseguire non è “far scrivere di più all’IA”, ma:
fare in modo che ogni contenuto pubblicato valga maggiormente la lettura e resista maggiormente alle verifiche.
¶ Riferimenti
- OpenAI: Guida pratica a GPT-6
- OpenAI: Presentazione di GPT-6.1 Sol
- Anthropic: Come abbiamo costruito il nostro sistema di ricerca multi-agente
- GEO: Generative Engine Optimization(KDD 2024)
- Google Search Central: Funzionalità IA e il tuo sito web
Questo articolo è una raccolta di materiali e un’analisi applicativa e non costituisce una misurazione delle prestazioni di questo sito. Le capacità dei modelli, le fasi di test e i prezzi possono cambiare: fare riferimento alla documentazione più recente del fornitore del servizio.