
Les changements apportés par GPT-6 ne concernent pas seulement des modèles plus intelligents, mais aussi la possibilité de répartir les tâches plus finement, de contrôler l’investissement en raisonnement et de réutiliser le contexte. Pour les équipes qui font du contenu et du GEO, ce qui mérite vraiment d’être étudié n’est pas « quel modèle est le plus puissant », mais comment rendre le processus de recherche, rédaction, vérification et publication plus fiable, tout en réduisant le coût de chaque contenu qualifié.
¶ I. Les modèles sont de plus en plus puissants, alors pourquoi le contenu reste-t-il difficile à utiliser ?
Si vous avez utilisé l’IA pour rédiger des articles en lot, vous avez probablement rencontré ce genre de situation : au premier regard, la structure est complète, les phrases sont fluides, et même le résumé semble assez convaincant. Mais en vérifiant sérieusement, on découvre que les données n’ont pas de source, que les versions de produit ne correspondent pas, ou qu’après deux mille mots, la question qui préoccupe le plus les lecteurs n’a toujours pas reçu de réponse.
À ce moment-là, la solution la plus évidente est : changer pour un modèle plus puissant.
Mais je recommande plutôt de poser d’abord une question : le problème vient-il réellement des capacités du modèle, ou du processus de travail ?
S’il n’y a pas de sources fiables, pas de limites claires pour la tâche, ni d’étape de vérification avant publication, changer de modèle ne résoudra pas nécessairement le problème fondamental.
Le guide d’utilisation de GPT-6 d’OpenAI ne s’articule d’ailleurs pas uniquement autour de « l’amélioration des capacités », mais aborde ensemble le choix du modèle, le niveau de raisonnement, le cache, la compression du contexte et la collaboration multi-agents. Il met l’accent sur ceci : faire servir différentes capacités à des tâches concrètes, et mesurer avant la mise en ligne le taux de réussite, la latence et le coût de chaque tâche réussie.
Pour les équipes de contenu, cette approche est très pratique : ne cherchez pas seulement à faire écrire davantage l’IA, faites d’abord en sorte qu’elle livre des résultats plus fiables.
¶ II. Comment choisir entre Astra, Sol et Luna ? Considérez-les comme des postes différents
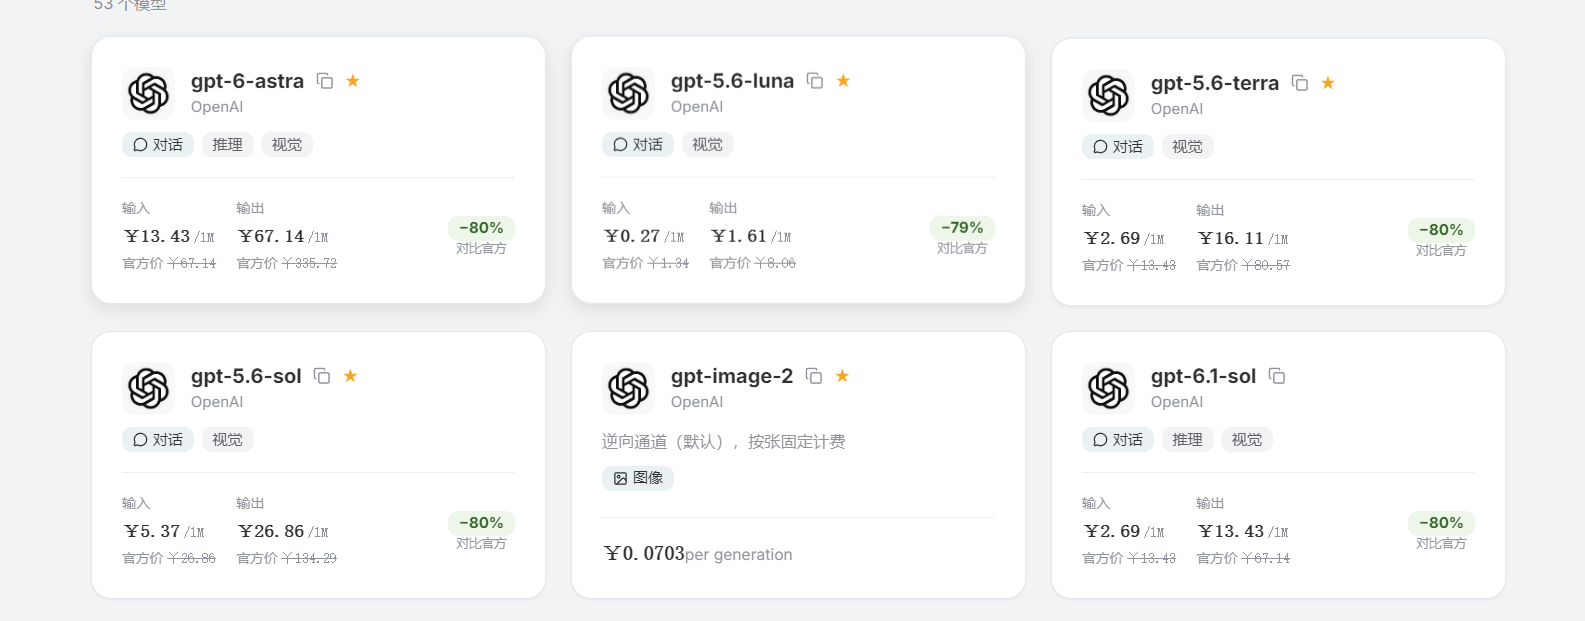
Selon le positionnement présenté dans le guide officiel d’OpenAI mentionné ci-dessus, GPT-6 Astra est destiné aux tâches de raisonnement les plus difficiles ; GPT-6.1 Sol aux tâches complexes de code, de recherche et d’utilisation d’ordinateur ; tandis que GPT-6 Luna est davantage orienté vers les tâches répétitives aux objectifs clairs, nécessitant un traitement à grande échelle, comme l’extraction de champs, la classification et les résumés structurés.
Plutôt que de mémoriser des paramètres, il vaut mieux les comprendre comme différents postes au sein d’une équipe.
Le tableau ci-dessous présente des recommandations de sélection basées sur les activités de contenu, et non un classement officiel des performances :
| Étape du contenu | Modèle à évaluer en priorité | Principales considérations |
|---|---|---|
| Classification d’articles, extraction de champs, résumés au format fixe | GPT-6 Luna | La tâche est claire, examinez d’abord le taux d’exactitude du format et le coût unitaire |
| Recherche multi-sources, organisation de documents, intégration d’articles | GPT-6.1 Sol | Nécessite un jugement entre plusieurs sources et une exécution en plusieurs étapes |
| Analyse de controverses, argumentation complexe, vérification de contenus importants | GPT-6 Astra | Le coût des erreurs est plus élevé, un jugement plus approfondi est nécessaire |
Par exemple, nous préparons un article intitulé « Comment les entreprises choisissent-elles une interface IA ». Pour extraire les champs de prix et de fonctionnalités dans les documents de différents fournisseurs, il n’est pas nécessaire de mobiliser dès le départ le modèle le plus puissant ; en revanche, analyser les compromis entre différentes solutions dans des activités complexes mérite d’investir davantage de ressources de raisonnement.
Bien sûr, cela ne signifie pas que « le contenu pris en charge par les petits modèles n’a pas besoin d’être vérifié ». Des informations comme les prix, les unités de facturation et les numéros de version peuvent contenir des erreurs, même s’il ne s’agit que d’extraction.
Une tâche simple signifie seulement que le mode de traitement peut être plus léger, pas que les critères d’acceptation peuvent être moins stricts.
¶ III. Un niveau de raisonnement plus élevé n’est pas toujours préférable, il faut voir si cette étape en vaut la peine
Après avoir choisi le modèle, il y a une autre variable facilement négligée : l’investissement en raisonnement.
Le guide d’OpenAI décrit les niveaux de raisonnement comme un compromis entre capacité et prix : Low correspond à l’extraction courante ou aux petites modifications, Medium est utilisé pour les tâches qui nécessitent du jugement, High pour l’analyse approfondie et la vérification minutieuse ; les niveaux supérieurs ne doivent être utilisés que lorsque le modèle les prend en charge et que le bénéfice supplémentaire justifie le temps et le coût.
Pour le dire plus simplement :
- Modifier un titre ne nécessite pas de faire raisonner le modèle à plusieurs reprises.
- Comparer trois solutions métier peut justifier de lui laisser davantage d’espace de réflexion.
- Déterminer s’il existe un conflit substantiel entre deux documents mérite une analyse sérieuse.
Vous pouvez commencer les tests avec l’approche suivante :
| Tâche | Point de départ recommandé | Quand passer au niveau supérieur |
|---|---|---|
| Classification de tags, conversion de formats | Faible investissement en raisonnement | Apparition d’ambiguïtés évidentes ou de conflits de règles |
| Plan d’article, comparaison de solutions | Investissement moyen en raisonnement | Impossible d’expliquer les compromis, omission de conditions clés |
| Analyse des conflits factuels, vérification de conclusions importantes | Investissement élevé en raisonnement | Les problèmes clés ne sont toujours pas résolus, tester alors un niveau supérieur |
Il y a ici une distinction importante : réfléchir plus longtemps ne signifie pas connaître davantage de faits.
Si la tâche nécessite les prix les plus récents ou des informations sur un produit tout juste publié, il faut d’abord compléter les sources, plutôt que d’augmenter simplement le niveau de raisonnement. En l’absence de preuves, la meilleure sortie peut être « cette information ne peut pas encore être confirmée », plutôt qu’une supposition plus fluide.
Par ailleurs, le tableau ci-dessus constitue une recommandation de flux de travail, et non un tableau universel de paramètres d’API. Les niveaux et noms de paramètres effectivement disponibles doivent dépendre du modèle spécifique et de la documentation d’intégration.
¶ IV. « Le cache permet d’économiser 95 % » est très attrayant, mais ne faites pas de mauvais calculs
Le cache est peut-être l’un des points d’optimisation les plus dignes d’attention dans la production de contenu en lot.
Présentation de la marque, règles de rédaction, glossaire fixe, exigences de validation… ces éléments se répètent souvent dans chaque requête. OpenAI recommande de placer les instructions stables et les documents de référence avant les détails variables de la tâche, et de maintenir des définitions d’outils cohérentes afin de réutiliser le contexte partagé. Le guide officiel indique que le coût des entrées mises en cache peut être réduit jusqu’à 95 % par rapport aux entrées non mises en cache, selon le modèle.
Mais il faut absolument bien comprendre ceci :
Une réduction de 95 % du coût des entrées mises en cache ne signifie pas que le coût de production de l’ensemble de l’article diminue de 95 %. En prenant comme exemple les prix API standard officiellement publiés de GPT-6.1 Sol : 2 dollars par million de tokens d’entrée, 0,10 dollar pour les entrées mises en cache, et 10 dollars pour les sorties. Ce qui est cité ici correspond aux prix standard officiels d’OpenAI et ne représente pas les devis réels de ce site ou de canaux d’intégration tiers ; pour les changements de prix, veuillez vous référer à la page la plus récente du fournisseur de services.
Faisons un exemple de démonstration, et non un résultat de mesure réelle :
Supposons qu’une tâche comporte :
- 20 000 tokens d’entrée ;
- dont 15 000 peuvent être atteints par le cache ;
- 3 000 tokens de sortie.
| Poste de coût | Toutes les entrées ne touchent pas le cache | 15 000 entrées touchent le cache |
|---|---|---|
| Entrée non mise en cache | $0.0400 | $0.0100 |
| Entrée mise en cache | $0 | $0.0015 |
| Sortie | $0.0300 | $0.0300 |
| Total | $0.0700 | $0.0415 |
Selon ce calcul hypothétique, les coûts de tokens diminuent d’environ 40,7 %, et non de 95 %.
De plus, cela ne tient pas encore compte des appels d’outils, des nouvelles tentatives après échec, de la révision humaine, ainsi que d’autres frais potentiellement applicables.
Par conséquent, une approche plus fiable consiste à diviser le prompt en deux couches :
Couche stable : normes de marque, style rédactionnel, format de sortie, règles de révision.
Couche dynamique : sujet de cette fois-ci, lecteurs cibles, documents nouvellement recherchés, exigences de la tâche actuelle.
Observez ensuite les situations réelles de réussite du cache dans les requêtes, au lieu d’inscrire directement dans le budget du projet la « remise maximale » dès que vous la voyez.
¶ V. Les systèmes multi-agents sont très adaptés à la recherche, mais pas à une répartition des tâches juste pour faire du bruit
Un article de recherche comprend souvent plusieurs tâches pouvant avancer indépendamment :
- consulter la documentation officielle ;
- trouver des cas réels ;
- recueillir les questions fréquentes ;
- vérifier les prix et les fonctionnalités ;
- organiser les divergences entre différentes sources.
Ces tâches présentent un certain degré d’indépendance et se prêtent à un traitement en parallèle.
Le guide d’OpenAI indique que GPT-6.1 Sol peut répartir des tâches indépendantes entre des sous-agents dans la Responses API, puis consolider les résultats ; cette capacité multi-agents est indiquée comme beta dans le guide.
Cependant, les systèmes multi-agents ne constituent pas un gain d’efficacité gratuit.
Dans son retour d’expérience d’ingénierie sur son système de recherche, Anthropic mentionne que les systèmes multi-agents conviennent à des recherches qui se déploient dans plusieurs directions indépendantes, mais qu’ils augmentent considérablement la consommation de tokens ; dans les données qu’ils ont observées, l’utilisation de tokens d’un système multi-agents est environ 15 fois celle d’une conversation ordinaire. Ce chiffre relève de l’expérience de leur système spécifique et ne peut pas être directement appliqué à tous les produits.
Par conséquent, je recommande plutôt cette organisation :
Demander à plusieurs agents de rechercher séparément les preuves, demander à un éditeur d’organiser uniformément l’article, puis faire vérifier le tout par un humain.
Ne demandez pas à cinq agents d’écrire chacun cinq paragraphes, puis de les assembler directement. Cela entraîne facilement des répétitions, des contradictions et une incohérence de style.
Voici un schéma de processus adapté au démarrage d’une équipe de contenu :
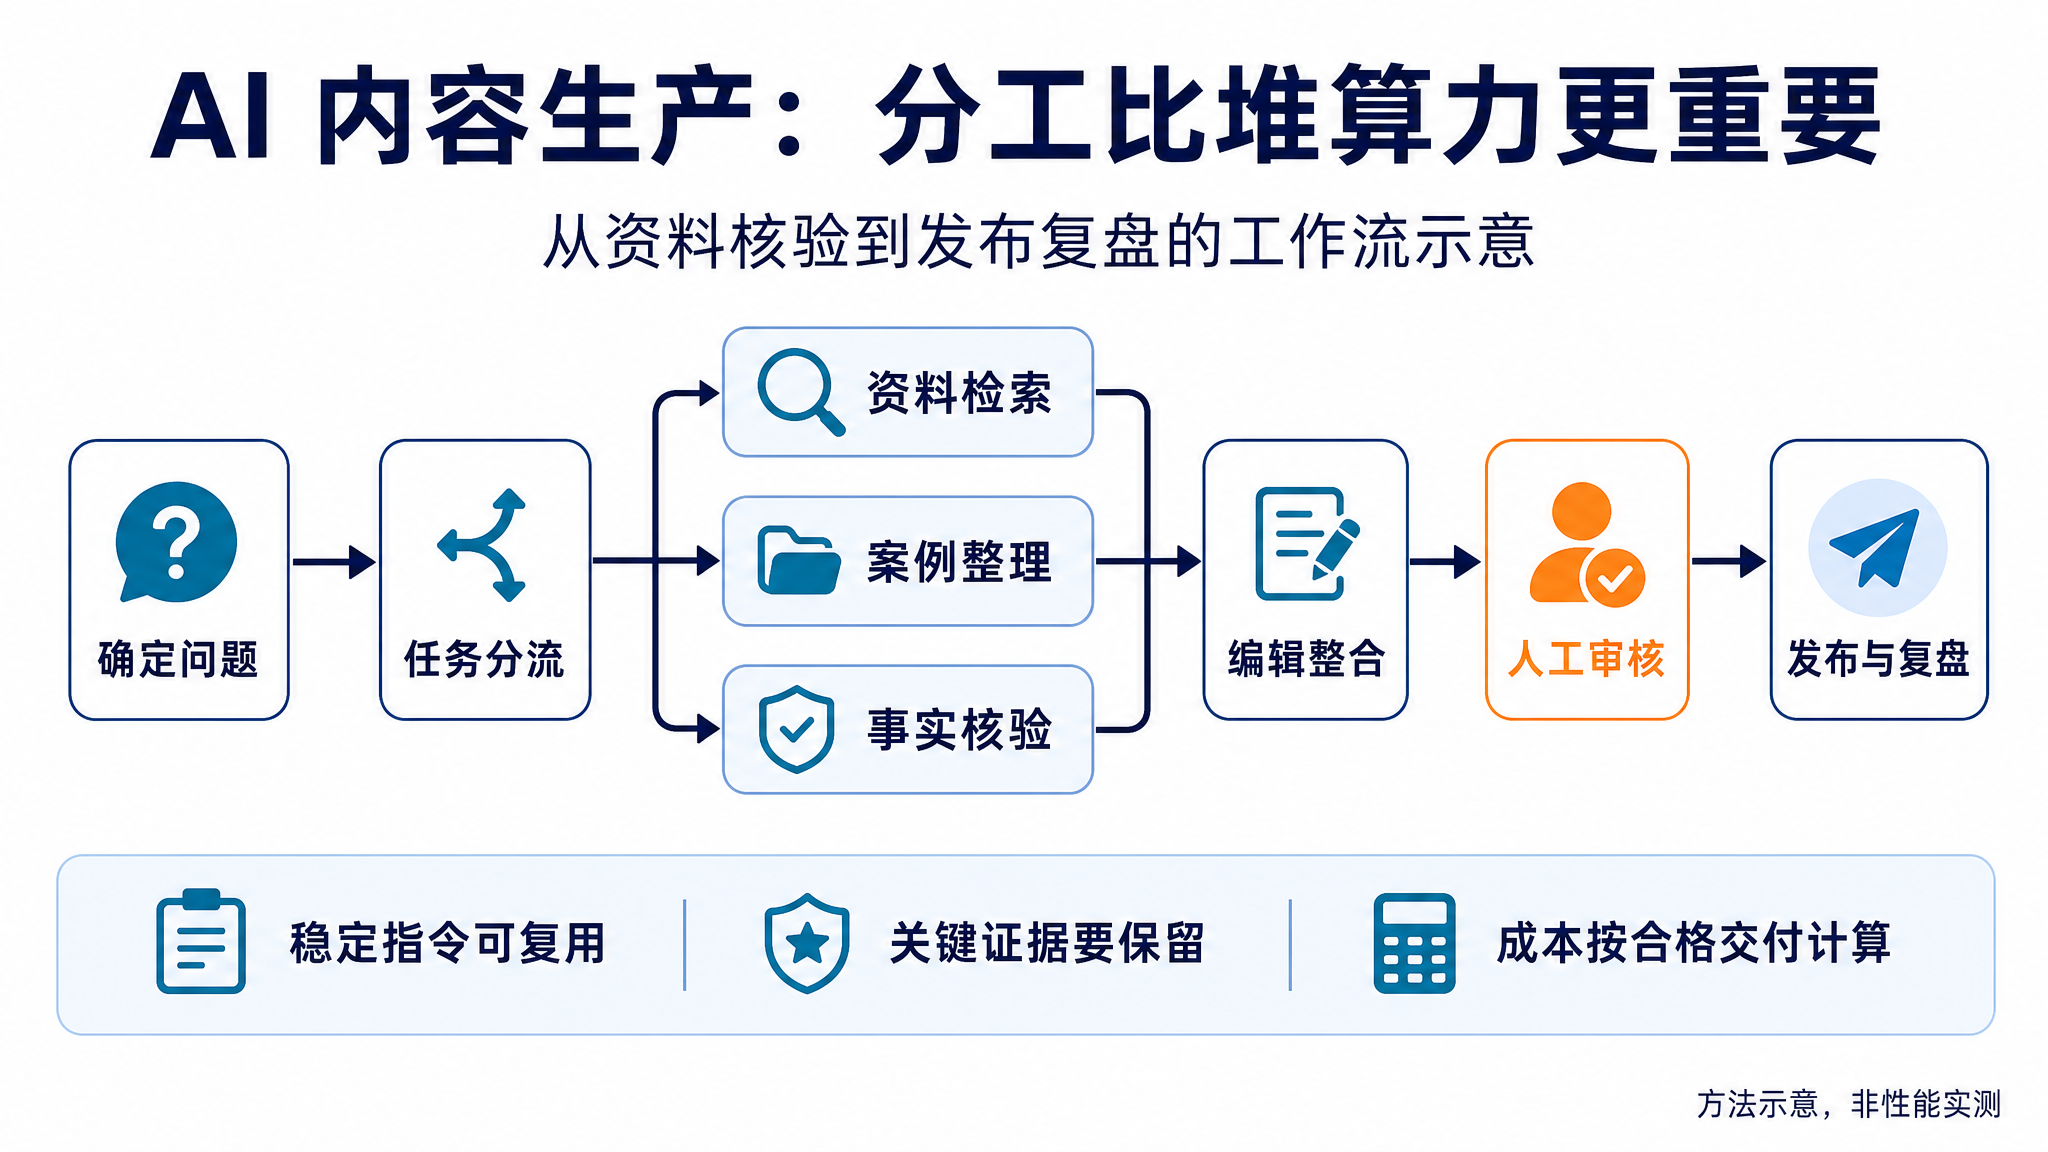
L’illustration est un schéma de méthode généré par GPT Image 2 et ne représente pas une mesure réelle des performances.
Pour que ce processus soit réellement utile, chaque sous-tâche devrait idéalement livrer quatre éléments :
- Conclusion : ce qui a été découvert.
- Sources : où se trouvent les preuves.
- Limites : les situations auxquelles cela ne s’applique pas.
- Éléments à confirmer : ce sur quoi aucune conclusion ne peut encore être tirée.
Il faut particulièrement noter que la vérification des faits ne consiste pas à demander à un autre modèle de « trouver que ce passage ne pose pas de problème », mais à lui faire comparer à nouveau le passage aux sources.
Le fait que plusieurs agents soient du même avis ne signifie pas que le fait a déjà été prouvé.
¶ VI. Les tâches longues doivent conserver leur état, et les opérations automatisées doivent délimiter clairement les autorisations
Pour rédiger un court texte, placer les documents dans le contexte peut suffire. Pour réaliser des dossiers en série ou maintenir continuellement une documentation produit, le problème est différent.
Le guide d’OpenAI présente la compression de contexte, utilisée pour réduire le volume de contexte des longues conversations tout en conservant l’état nécessaire à la poursuite de la tâche.
Pour le travail de contenu, je recommande, quelle que soit la méthode de compression employée, de maintenir séparément un registre des tâches :
- les faits confirmés et leurs sources ;
- la version de produit actuellement utilisée ;
- les conflits entre documents qui ne sont pas encore résolus ;
- les étapes terminées et non terminées ;
- les décisions qui doivent impérativement être confirmées par un humain.
Ne laissez pas uniquement un résumé vague tel que « nous avons déjà étudié cette question ». Ce dont la rédaction ultérieure a réellement besoin, ce sont des preuves et des limites.
Il en va de même pour les opérations automatisées. Le guide officiel recommande de privilégier les méthodes pouvant être réalisées directement avec des API ou des outils déjà connectés ; lorsqu’il est nécessaire de lire l’écran, de cliquer ou de remplir des formulaires, il faut alors envisager les capacités d’opération informatique.
Pour le flux de travail d’un blog, vous pouvez permettre à l’IA d’organiser automatiquement les brouillons, de vérifier les liens et de générer des illustrations, mais placer la publication officielle, la suppression d’articles et la modification de configurations en ligne après une confirmation humaine.
Être capable d’utiliser le back-office ne signifie pas qu’il faut disposer d’autorisations illimitées.
¶ VII. Retour au GEO : écrire plus vite ne signifie pas être plus facilement cité par l’IA
À ce stade, il faut distinguer deux questions :
- utiliser l’IA pour améliorer l’efficacité de la production de contenu ;
- rendre le contenu plus facile à découvrir et à citer dans les réponses de recherche générative.
La première est une question de flux de travail ; la seconde est le véritable cœur des préoccupations du GEO.
Les premières recherches sur le GEO portent sur la visibilité du contenu dans les moteurs génératifs et rapportent, dans leur cadre d’évaluation, une amélioration maximale de visibilité d’environ 40 %, tout en indiquant que les effets varient selon les domaines. Ce résultat ne peut pas être directement compris comme « faites cela, et le trafic de ce site augmentera de 40 % ».
Les explications officielles de Google sont plus pragmatiques : pour AI Overviews et AI Mode, aucune exigence particulière d’optimisation supplémentaire n’est nécessaire ; le SEO de base ainsi qu’un contenu fiable et centré sur les personnes restent importants. Une page doit être éligible à l’indexation et à l’affichage d’extraits pour avoir une chance d’apparaître comme lien de soutien.
Cela ne représente pas les règles de tous les produits de recherche par IA, mais cela nous rappelle au moins ceci : ne vous précipitez pas pour chercher un prétendu « modèle GEO universel ». Pour le blog de ce site, je recommande davantage de bien faire d’abord les quelques points suivants.
¶ 1. Un article résout un problème réel
« Analyse complète de l’avenir de l’IA » semble vaste, mais n’est pas forcément utile.
« Lors de la génération en lot de textes de produits, comment déterminer si le cache permet réellement d’économiser de l’argent », en revanche, est plus facile à expliquer clairement et plus pratique à appliquer directement pour les lecteurs.
¶ 2. Ajouter les conditions d’application aux chiffres
N’écrivez pas seulement « baisse des coûts de 40 % ».
Il faut préciser quel modèle est utilisé, comment le calcul est effectué, si cela inclut les coûts de sortie, d’outils et de main-d’œuvre, ainsi que si ce chiffre est un résultat expérimental ou un exemple de démonstration.
¶ 3. Ne pas cacher les contenus clés uniquement dans des images
Google recommande clairement de présenter les contenus importants sous forme de texte, et les données structurées doivent également rester cohérentes avec le contenu visible de la page.
Ainsi, les graphiques peuvent aider à la compréhension, mais le corps du texte doit tout de même expliquer les conclusions, les données et les conditions.
¶ 4. Séparer les faits, les recommandations et les prédictions
« La documentation officielle prend en charge une certaine fonctionnalité » est un type d’information.
« Nous recommandons aux équipes de contenu de l’utiliser ainsi » en est un autre.
« Cela pourrait entraîner un certain changement à l’avenir » en est encore un troisième.
Les distinguer clairement a plus de valeur que d’écrire toutes les phrases de manière catégorique.
¶ 5. Observer les résultats réels, sans croire aveuglément aux scores d’auto-évaluation
Il est possible d’établir un ensemble fixe de questions et de consigner régulièrement si différents produits de recherche par IA citent ce site, quel article ils citent et si la citation est exacte, puis de les combiner avec l’analyse du trafic réel et des conversions.
Un tel suivi reste influencé par le temps, les régions et les différences entre produits, mais il offre au moins davantage de valeur de référence que d’attribuer à un article un « score GEO élevé » sans fondement public.
¶ VIII. Ce qu’il faut réellement optimiser, c’est le « coût de chaque article conforme »
Les équipes de contenu ont facilement tendance à se concentrer sur deux chiffres : le nombre d’articles générés par jour et le nombre de tokens consommés par article.
Mais si 100 articles sont générés et que seuls 20 peuvent finalement être publiés, cette efficacité n’est peut-être pas très élevée.
Je recommande plutôt d’examiner cet indicateur :
Coût par contenu conforme = coût total de production ÷ nombre d’articles ayant passé la validation
Parmi eux, le coût total de production devrait inclure les appels au modèle, les outils de recherche, les retouches et la révision humaine, et pas seulement le coût de la première génération.
Lors de la mise en œuvre réelle, il est possible de sélectionner d’abord un lot de tâches représentatives pour effectuer des tests à petite échelle, sans les déployer sur l’ensemble du site dès le départ.
Les points clés à consigner :
| Indicateur | Question à laquelle répondre |
|---|---|
| Taux d’erreurs factuelles | Y a-t-il des inventions, des informations obsolètes ou des confusions de versions ? |
| Traçabilité des sources | Est-il possible de retrouver la source originale des conclusions clés ? |
| Taux de validation dès la première revue | Combien de contenus ne nécessitent pas de retouches importantes ? |
| Coût par article conforme | Après inclusion des tâches échouées et du travail humain, combien cela a-t-il réellement coûté ? |
| Délai de livraison | Du début de la recherche jusqu’à la possibilité de publier, combien de temps faut-il ? |
| Effet après publication | Cela génère-t-il du trafic utile, des citations ou des conversions métier ? |
Après les tests, décidez ensuite : quelles tâches doivent être traitées à un niveau inférieur, quels maillons doivent augmenter l’effort de raisonnement, quelles recherches méritent d’être menées en parallèle et quelles étapes doivent impérativement être confiées à des humains.
¶ Conclusion : utiliser l’intelligence là où elle est nécessaire
GPT-6 offre davantage de choix aux équipes de contenu, mais avoir plus de choix ne signifie pas que la configuration la plus puissante doit être utilisée à chaque étape.
La direction qui mérite davantage d’être explorée est :
traiter légèrement les tâches simples, raisonner sérieusement pour les jugements complexes, réutiliser autant que possible les contextes répétés, mener en parallèle de manière appropriée les recherches indépendantes et conserver une validation avant la publication officielle.
Il en va de même pour le GEO.
Aucun modèle ne peut garantir qu’un article sera cité. Ce que nous pouvons faire, c’est lui permettre de répondre à de vraies questions, de fournir des preuves traçables et d’expliquer clairement son champ d’application.
En fin de compte, ce qui mérite vraiment d’être recherché n’est pas « faire écrire davantage l’IA », mais :
faire en sorte que chaque contenu publié soit plus digne d’être lu et résiste mieux à la vérification.
¶ Références
- OpenAI : Guide pratique de GPT-6
- OpenAI : Introducing GPT-6.1 Sol
- Anthropic : How we built our multi-agent research system
- GEO: Generative Engine Optimization(KDD 2024)
- Google Search Central : AI features and your website
Cet article constitue une compilation de ressources et une analyse d’application ; il ne relève pas de tests de performance réalisés par ce site. Les capacités des modèles, les phases de test et les prix peuvent évoluer ; veuillez vous référer à la documentation la plus récente du fournisseur de services.