
Los cambios que trae GPT-6 no consisten solo en que el modelo sea más inteligente, sino en que podemos distribuir las tareas con mayor precisión, controlar la inversión en razonamiento y reutilizar el contexto. Para los equipos que hacen contenido y GEO, lo que realmente vale la pena estudiar no es «qué modelo es el más potente», sino cómo hacer que el proceso de recuperación, redacción, verificación y publicación sea más fiable, al mismo tiempo que se reduce el coste de cada contenido cualificado.
¶ I. Los modelos son cada vez más potentes, ¿por qué el contenido sigue sin ser útil?
Si has usado IA para redactar artículos por lotes, es muy probable que te hayas encontrado con esta situación: a primera vista, la estructura está completa, las frases son fluidas e incluso el resumen parece bastante convincente. Pero al revisarlo detenidamente, descubres que los datos no tienen fuente, que las versiones de los productos no coinciden o que, después de escribir dos mil palabras, sigue sin responder a la pregunta que más le importa al lector.
En ese momento, la solución más fácil de pensar es: cambiar a un modelo más potente.
Pero yo recomendaría preguntar primero: ¿el problema está realmente en la capacidad del modelo o en el flujo de trabajo?
Si no hay materiales fiables, límites claros para la tarea ni una fase de verificación antes de la publicación, cambiar de modelo no necesariamente resolverá el problema de raíz.
La guía de uso de GPT-6 de OpenAI tampoco se desarrolla en realidad únicamente en torno a la «mejora de capacidades», sino que analiza conjuntamente la selección de modelos, los niveles de razonamiento, la caché, la compresión de contexto y la colaboración multiagente. Lo que enfatiza es: hacer que distintas capacidades sirvan a tareas concretas, y medir la tasa de éxito, la latencia y el coste de cada tarea exitosa antes del lanzamiento.
Para los equipos de contenido, esta idea es muy práctica: no pienses solo en hacer que la IA escriba más, primero haz que entregue resultados más estables.
¶ II. ¿Cómo elegir entre Astra, Sol y Luna? Trátalos como puestos diferentes
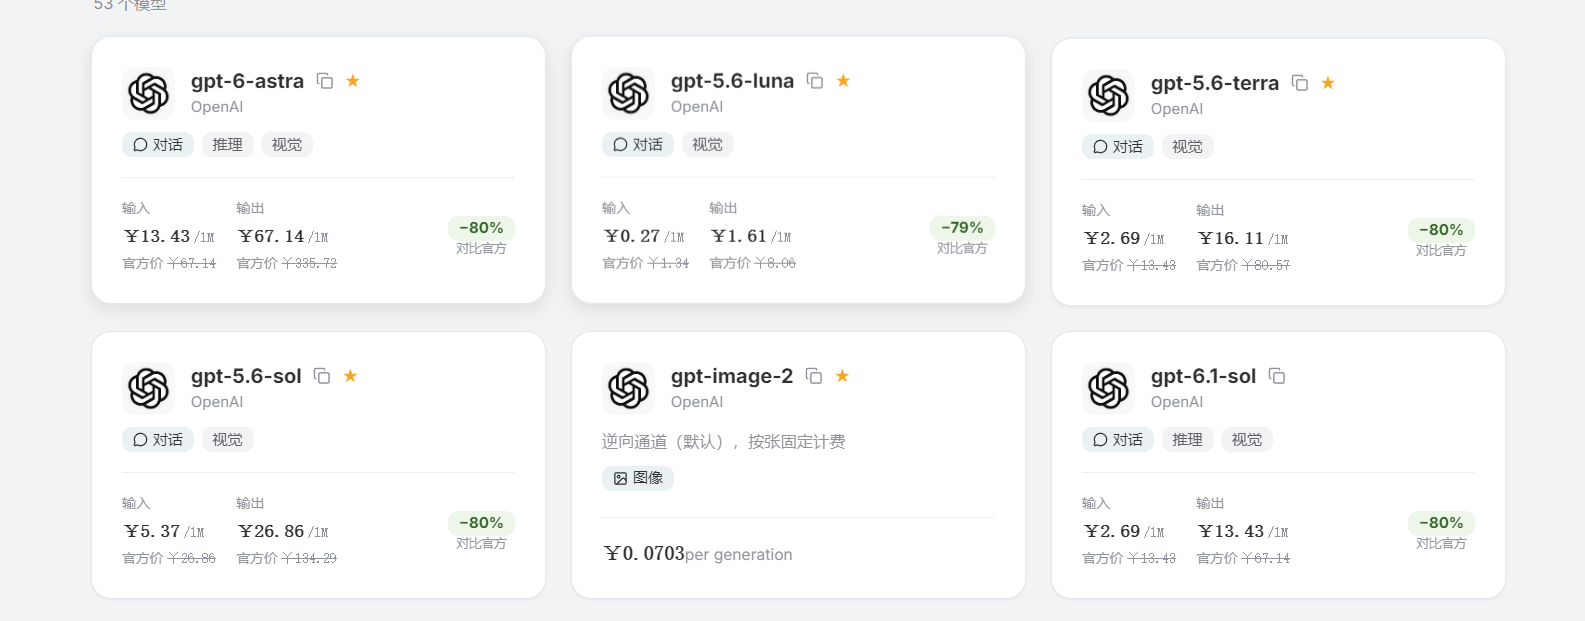
Según la posición de la guía oficial de OpenAI mencionada anteriormente, GPT-6 Astra está orientado al trabajo de razonamiento más difícil; GPT-6.1 Sol está orientado a la programación compleja, la investigación y las operaciones informáticas; mientras que GPT-6 Luna se inclina más hacia tareas repetitivas con objetivos claros y que requieren procesamiento a escala, como la extracción de campos, la clasificación y los resúmenes estructurados.
En lugar de memorizar parámetros, es mejor entenderlos como distintos puestos dentro de un equipo.
La siguiente tabla presenta recomendaciones de selección basadas en el negocio de contenidos, y no es un ranking oficial de rendimiento:
| Etapa de contenido | Modelo que se recomienda evaluar primero | Consideración principal |
|---|---|---|
| Clasificación de artículos, extracción de campos, resúmenes de formato fijo | GPT-6 Luna | La tarea es clara; primero hay que revisar la precisión del formato y el coste unitario |
| Investigación de múltiples fuentes, organización de materiales, integración de artículos | GPT-6.1 Sol | Se requiere juicio entre materiales y ejecución en varios pasos |
| Análisis de controversias, argumentación compleja, revisión de contenido clave | GPT-6 Astra | El coste de los errores es mayor y se requiere un juicio más profundo |
Por ejemplo, estamos preparando un artículo sobre «cómo deben las empresas elegir interfaces de IA». Para extraer los campos de precio y funcionalidades de la documentación de cada proveedor, no es necesario utilizar el modelo más potente desde el principio; en cambio, para analizar las compensaciones entre distintas soluciones en negocios complejos, vale la pena invertir más recursos de razonamiento.
Por supuesto, esto no significa que el contenido del que se encargan los «modelos pequeños» no necesite revisión. Información como precios, unidades de facturación y números de versión, incluso si solo se extrae, también puede contener errores.
Que la tarea sea sencilla solo significa que el método de procesamiento puede ser más ligero; no significa que los criterios de aceptación puedan ser menos estrictos.
¶ III. El nivel de razonamiento no es mejor cuanto más alto: hay que ver si este paso lo merece
Después de elegir el modelo, hay otra variable que se pasa por alto fácilmente: la inversión en razonamiento.
La guía de OpenAI describe los niveles de razonamiento como una compensación entre capacidad y precio: Low corresponde a extracción rutinaria o pequeñas ediciones, Medium se usa para trabajos que requieren juicio, High se usa para análisis profundos y revisiones cuidadosas; los niveles más altos solo deberían utilizarse cuando el modelo los admita y los beneficios adicionales justifiquen el tiempo y el coste.
Dicho de forma más directa:
- Para cambiar un título, no es necesario que el modelo razone repetidamente.
- Para comparar tres soluciones de negocio, se le puede dar más espacio para pensar.
- Para determinar si dos materiales tienen un conflicto sustancial, vale la pena analizarlos detenidamente.
Puedes empezar a probar con el siguiente enfoque:
| Tarea | Punto de partida recomendado | Cuándo subir de nivel |
|---|---|---|
| Clasificación de etiquetas, conversión de formatos | Baja inversión en razonamiento | Aparecen ambigüedades evidentes o conflictos de reglas |
| Esquema de artículos, comparación de soluciones | Inversión media en razonamiento | No se pueden explicar las compensaciones o se omiten condiciones clave |
| Análisis de conflictos de hechos, revisión de conclusiones importantes | Alta inversión en razonamiento | Aún no se resuelven los problemas clave; entonces se prueban niveles más altos |
Aquí hay una diferencia importante: pensar durante más tiempo no equivale a conocer más hechos.
Si la tarea requiere precios recientes o información de productos recién lanzados, lo primero es completar las fuentes, no simplemente aumentar el nivel de razonamiento. Cuando faltan pruebas, la mejor respuesta puede ser «esta información aún no se puede confirmar», y no una conjetura más fluida.
Además, la tabla anterior es una recomendación de flujo de trabajo, no una tabla general de parámetros de API. Los niveles y nombres de parámetros realmente disponibles deben basarse en el modelo específico y en la documentación de integración.
¶ IV. «La caché ahorra un 95 %» resulta muy atractivo, pero no calcules mal las cuentas
La caché puede ser uno de los puntos de optimización más dignos de atención en la producción de contenido por lotes.
Presentaciones de marca, normas de redacción, glosarios fijos, requisitos de revisión... estos materiales aparecen repetidamente en cada solicitud. OpenAI recomienda colocar las instrucciones estables y los materiales de referencia antes de los detalles variables de la tarea, y mantener coherentes las definiciones de herramientas, para poder reutilizar el contexto compartido. La guía oficial menciona que el coste de las entradas en caché puede reducirse hasta un 95 % en comparación con las entradas sin caché, según el modelo.
Pero aquí hay que tenerlo muy claro:
Que las entradas en caché sean un 95 % más baratas no significa que el coste de producción de todo el artículo se reduzca un 95 %. Tomando como ejemplo los precios estándar de la API GPT-6.1 Sol publicados oficialmente: por cada millón de tokens de entrada son 2 dólares, la entrada en caché es 0,10 dólares y la salida es 10 dólares. Aquí se citan los precios estándar oficiales de OpenAI; no representan las cotizaciones reales de este sitio ni de canales de acceso de terceros. Para cambios de precios, consulte la página más reciente del proveedor de servicios.
Hagamos un ejemplo demostrativo, no un resultado de medición real:
Supongamos que una tarea tiene:
- 20.000 tokens de entrada;
- de los cuales 15.000 pueden coincidir con la caché;
- 3.000 tokens de salida.
| Concepto de coste | Toda la entrada sin coincidencia de caché | 15.000 tokens de entrada con coincidencia de caché |
|---|---|---|
| Entrada no almacenada en caché | $0.0400 | $0.0100 |
| Entrada almacenada en caché | $0 | $0.0015 |
| Salida | $0.0300 | $0.0300 |
| Total | $0.0700 | $0.0415 |
Según este supuesto, el coste de tokens disminuye aproximadamente un 40,7%, no un 95%.
Además, esto todavía no incluye llamadas a herramientas, reintentos fallidos, revisión humana ni otros costes que puedan ser aplicables.
Por lo tanto, una forma más fiable es dividir el prompt en dos capas:
Capa estable: normas de marca, estilo de redacción, formato de salida y reglas de revisión.
Capa dinámica: el tema de esta ocasión, los lectores objetivo, los materiales recién recuperados y los requisitos de la tarea actual.
Luego, observe la situación de coincidencia de caché en solicitudes reales, en lugar de incluir directamente en el presupuesto del proyecto el “descuento máximo” apenas lo vea.
¶ V. Los sistemas multiagente son muy adecuados para la investigación, pero no para dividir el trabajo solo por animación
Un artículo de investigación suele incluir varias tareas que pueden avanzarse de forma independiente:
- Consultar documentación oficial;
- Buscar casos reales;
- Recopilar preguntas frecuentes;
- Verificar precios y funciones;
- Organizar las discrepancias entre diferentes fuentes.
Estas tareas tienen cierto grado de independencia y son adecuadas para procesarse en paralelo.
La guía de OpenAI presenta que GPT-6.1 Sol puede asignar tareas independientes a subagentes en la Responses API y luego resumir los resultados; esta capacidad multiagente está etiquetada como beta en la guía.
Sin embargo, los sistemas multiagente no son una mejora de eficiencia gratuita.
Anthropic, en la retrospectiva de ingeniería de su sistema de investigación, menciona que los sistemas multiagente son adecuados para investigaciones que se expanden en múltiples direcciones independientes, pero aumentan significativamente el consumo de tokens; en los datos que observaron, el uso de tokens de los sistemas multiagente fue aproximadamente 15 veces el de un chat normal. Esta cifra corresponde a la experiencia de su sistema específico y no puede aplicarse directamente a todos los productos.
Por lo tanto, recomiendo más bien organizarlo así:
Que varios agentes busquen pruebas por separado, que un editor organice el artículo de manera unificada y que después una persona realice el control final.
No haga que cinco agentes escriban cinco párrafos por separado y luego los unan directamente. Así es muy fácil que aparezcan repeticiones, contradicciones e inconsistencias de estilo.
A continuación se muestra un flujo adecuado para que los equipos de contenido comiencen:
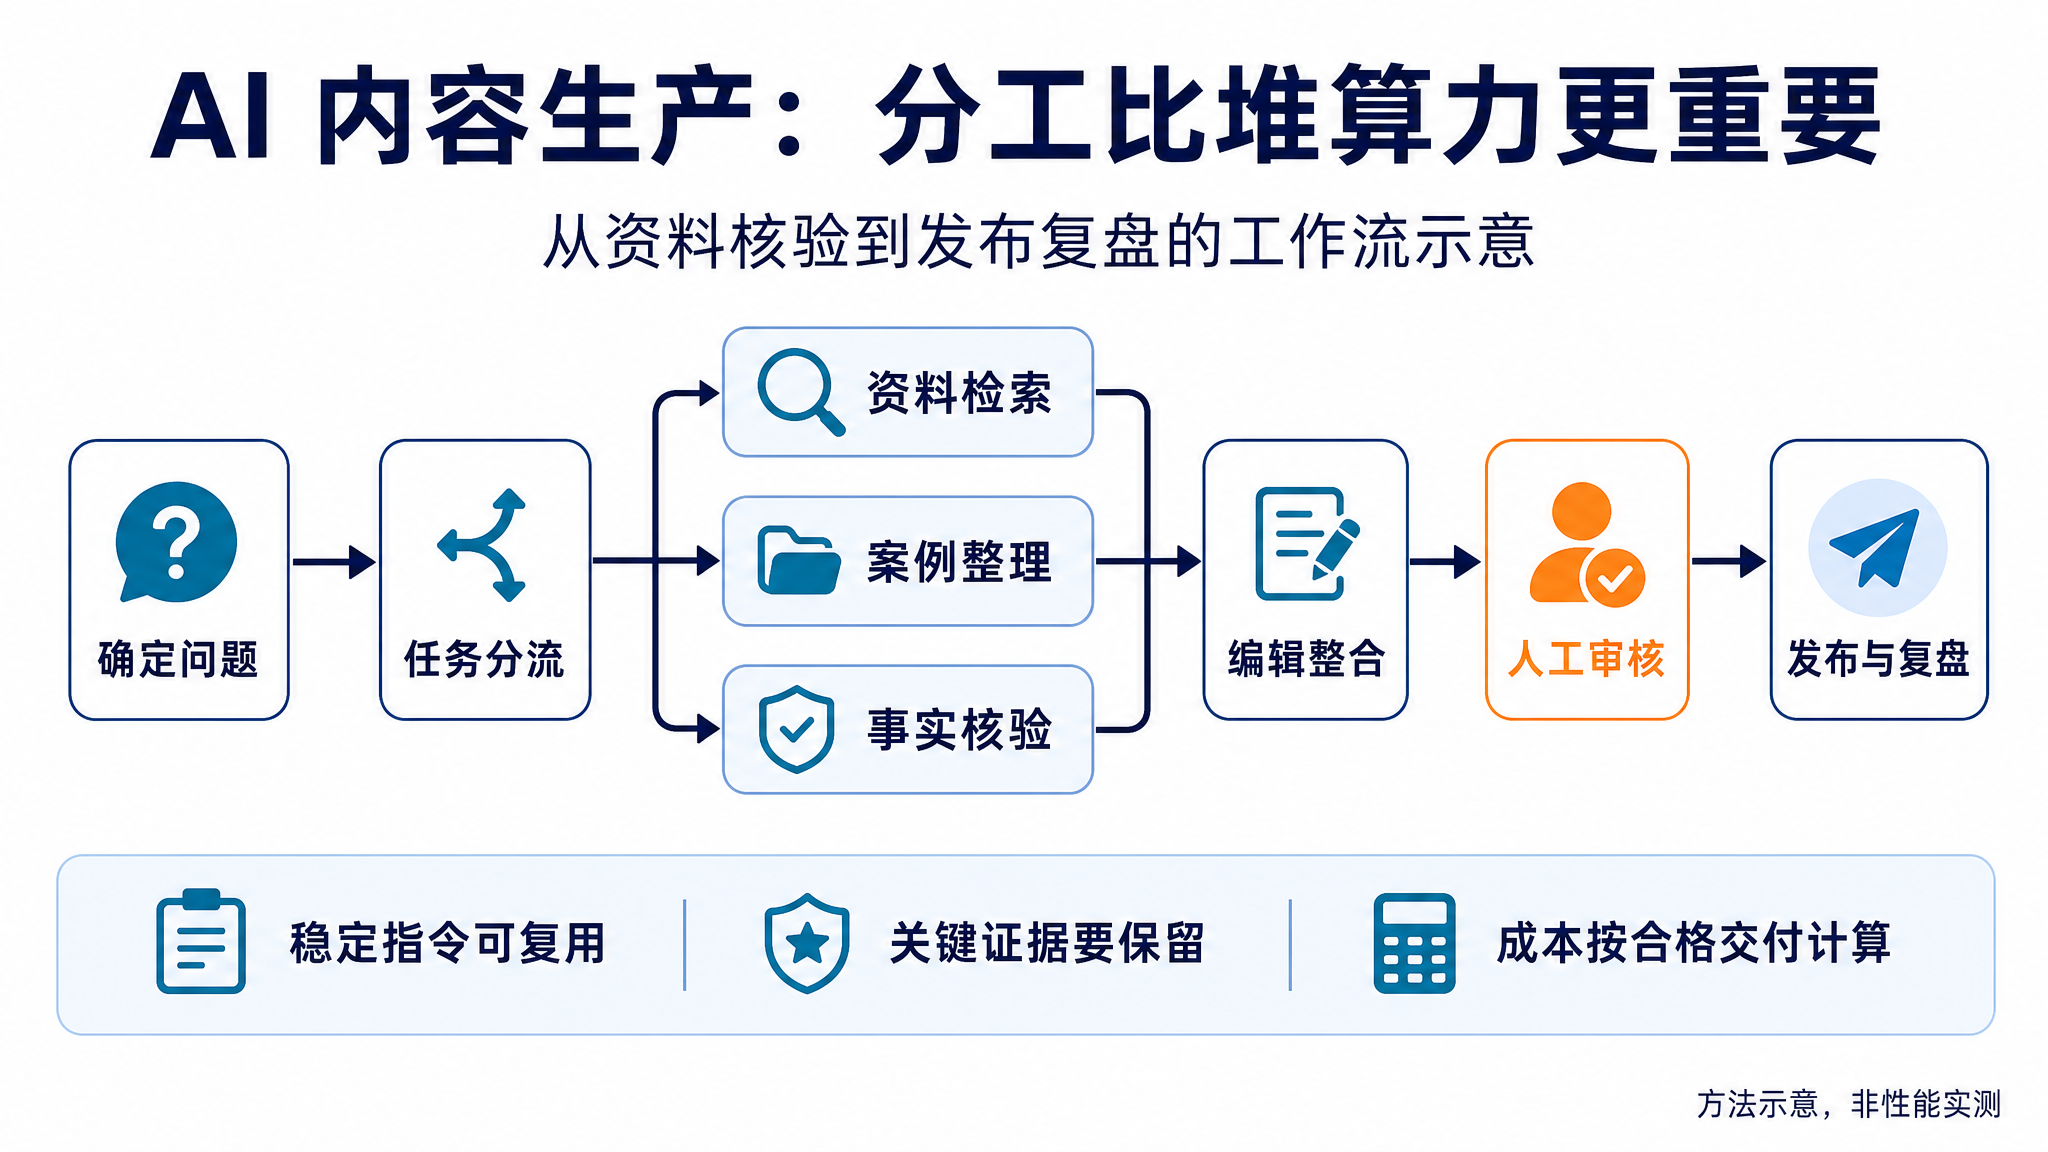
La imagen ilustrativa es un esquema de método generado por GPT Image 2 y no representa mediciones reales de rendimiento.
Para que este flujo sea realmente útil, cada subtarea debería entregar preferiblemente cuatro cosas:
- Conclusión: qué se encontró.
- Fuente: dónde está la evidencia.
- Limitaciones: en qué situaciones no es aplicable.
- Puntos por confirmar: sobre qué todavía no se puede sacar una conclusión.
Preste especial atención: la verificación de hechos no consiste en pedir a otro modelo que “considere que este texto no tiene problemas”, sino en hacer que vuelva a contrastarlo con las fuentes.
Que varios agentes estén de acuerdo no significa que el hecho ya haya sido demostrado.
¶ VI. Las tareas largas deben guardar el estado y las operaciones automáticas deben delimitar los permisos
Para escribir un texto breve, puede bastar con poner los materiales en el contexto. Para realizar una serie temática o mantener continuamente la documentación de un producto, la situación es diferente.
La guía de OpenAI presenta la compresión de contexto, utilizada para reducir el volumen de contexto de conversaciones largas y, al mismo tiempo, conservar el estado necesario para continuar la tarea.
Para el trabajo de contenido, recomiendo que, independientemente del método de compresión utilizado, se mantenga por separado un registro de la tarea:
- Los hechos confirmados y sus fuentes;
- La versión de producto utilizada actualmente;
- Los conflictos de información aún no resueltos;
- Los pasos completados y no completados;
- Las decisiones que deben ser confirmadas por una persona.
No deje solo resúmenes vagos como “ya hemos investigado este problema”. Lo que la redacción posterior realmente necesita son pruebas y límites.
Las operaciones automáticas son iguales. La guía oficial recomienda que, para los pasos que pueden completarse directamente mediante API o herramientas ya conectadas, se prioricen estas formas; cuando sea necesario leer la pantalla, hacer clic o rellenar formularios, considere entonces las capacidades de operación informática.
Para el flujo de un blog, se puede permitir que la IA organice automáticamente los borradores, revise enlaces y genere imágenes ilustrativas, pero deje la publicación formal, la eliminación de artículos y la modificación de configuraciones en línea para después de la confirmación humana.
Poder operar el panel de administración no significa que deba tener permisos ilimitados.
¶ VII. Volvamos al GEO: escribir más rápido no significa que sea más fácil ser citado por la IA
Llegados a este punto, es necesario separar dos cuestiones:
- Utilizar IA para mejorar la eficiencia de producción de contenido;
- Hacer que el contenido sea más fácil de descubrir y citar en respuestas de búsqueda generativa.
La primera es una cuestión de flujo de trabajo; la segunda es el núcleo de atención de GEO.
La investigación temprana sobre GEO se centró en la visibilidad del contenido en motores generativos e informó de una mejora máxima de visibilidad de aproximadamente un 40% en su configuración de evaluación, al tiempo que señalaba que los efectos varían entre distintos ámbitos. Este resultado no puede entenderse directamente como “si se hace así, el tráfico de este sitio aumentará un 40%”.
La explicación oficial de Google es más pragmática: para AI Overviews y AI Mode, no se necesita un conjunto adicional de requisitos especiales de optimización; el SEO básico y el contenido fiable y centrado en las personas siguen siendo importantes. Las páginas deben ser aptas para ser indexadas y mostrar resúmenes antes de tener la oportunidad de aparecer como enlaces de apoyo.
Esto no puede representar las reglas de todos los productos de búsqueda con IA, pero al menos nos recuerda: no se apresure a buscar la llamada “plantilla GEO universal”. Para el blog de este sitio, recomiendo más bien hacer primero las siguientes cosas.
¶ 1. Un artículo resuelve un problema real
“Análisis completo del futuro de la IA” suena muy amplio, pero no necesariamente útil.
“Al generar textos de productos por lotes, cómo determinar si la caché realmente ahorra dinero” es, en cambio, más fácil de explicar con claridad y también más conveniente para que los lectores lo apliquen directamente.
¶ 2. Completar las condiciones aplicables de las cifras
No escribas solo “el coste se redujo un 40 %”.
Hay que explicar qué modelo se utilizó, cómo se calculó, si incluye la salida, las herramientas y los costes de mano de obra, y si esta cifra es un resultado experimental o un ejemplo demostrativo.
¶ 3. No ocultar el contenido clave solo en imágenes
Google recomienda claramente presentar el contenido importante en formato de texto, y los datos estructurados también deben mantenerse coherentes con el contenido visible de la página.
Por lo tanto, los gráficos pueden ayudar a la comprensión, pero el cuerpo del texto debe seguir explicando las conclusiones, los datos y las condiciones.
¶ 4. Separar los hechos, las recomendaciones y las predicciones
“Los documentos oficiales admiten cierta función” es un tipo de información.
“Recomendamos que el equipo de contenido lo use de esta manera” es otro tipo.
“En el futuro podría generar cierto cambio” es un tercer tipo.
Distinguirlos claramente tiene más valor que redactar todas las frases de manera categórica.
¶ 5. Observar los resultados reales, sin creer ciegamente en las puntuaciones de autoevaluación
Se puede establecer un conjunto fijo de preguntas y registrar periódicamente si distintos productos de búsqueda con IA citan este sitio, qué artículo citan y si la cita es precisa, para después combinarlo con el análisis de las visitas y conversiones reales.
Este tipo de seguimiento seguirá estando afectado por diferencias de tiempo, región y producto, pero al menos tendrá más valor de referencia que asignar a un artículo una “puntuación GEO alta” sin una base pública.
¶ VIII. Lo que realmente debe optimizarse es el «coste de cada artículo apto»
Es fácil que los equipos de contenido se centren en dos cifras: cuántos artículos se generan al día y cuántos tokens consume cada artículo.
Pero si se generan 100 artículos y al final solo se pueden publicar 20, esta eficiencia quizá no sea muy alta.
Recomiendo más bien observar este indicador:
Coste por contenido apto = coste total de producción ÷ cantidad de artículos que pasan la revisión
Entre ellos, el coste total de producción debería incluir las llamadas al modelo, las herramientas de recuperación, las revisiones y la revisión humana, y no solo el coste de la primera generación.
Al implementarlo en la práctica, se puede elegir primero un grupo de tareas representativas para realizar pruebas a pequeña escala, sin extenderlo a todo el sitio desde el principio.
Registrar principalmente:
| Indicador | Pregunta que debe responder |
|---|---|
| Tasa de errores factuales | ¿Hay invenciones, información desactualizada o confusión entre versiones? |
| Trazabilidad de las fuentes | ¿Se puede encontrar la base original de las conclusiones clave? |
| Tasa de aprobación en la primera revisión | ¿Cuánto contenido no necesita una revisión importante? |
| Coste por artículo apto | Después de incluir las tareas fallidas y el trabajo humano, ¿cuánto se gastó realmente? |
| Tiempo de entrega | Desde el inicio de la recuperación hasta que se puede publicar, ¿cuánto tiempo se necesita? |
| Efecto posterior a la publicación | ¿Aporta visitas efectivas, citas o conversiones de negocio? |
Después de las pruebas, decidir: qué tareas deben procesarse con una configuración inferior, en qué etapas debe aumentarse la inversión en razonamiento, qué investigaciones vale la pena realizar en paralelo y qué pasos deben entregarse obligatoriamente a personas.
¶ Para terminar: usar la inteligencia donde corresponde
GPT-6 ofrece más opciones a los equipos de contenido, pero que aumenten las opciones no significa que sea necesario usar la configuración más potente en cada paso.
Una dirección más digna de probar es:
procesar las tareas simples de forma ligera, razonar seriamente en las decisiones complejas, reutilizar en la medida de lo posible los contextos repetidos, realizar en paralelo de forma moderada las investigaciones independientes y conservar la revisión antes de la publicación formal.
Para GEO, ocurre lo mismo.
Ningún modelo puede garantizar que un artículo sea citado. Lo que podemos hacer es permitir que responda a problemas reales, proporcione evidencia trazable y explique claramente su ámbito de aplicación.
En última instancia, lo que realmente vale la pena perseguir no es “hacer que la IA escriba un poco más”, sino:
hacer que cada contenido publicado merezca más la pena de leer y resista mejor las verificaciones.
¶ Referencias
- OpenAI: Guía práctica de GPT-6
- OpenAI: Presentación de GPT-6.1 Sol
- Anthropic: Cómo construimos nuestro sistema de investigación multiagente
- GEO: Optimización para motores generativos (KDD 2024)
- Google Search Central: Funciones de IA y tu sitio web
Este artículo es una recopilación de materiales y un análisis de aplicación, y no constituye una prueba de rendimiento de este sitio. Las capacidades de los modelos, las fases de prueba y los precios pueden cambiar; consulta la documentación más reciente del proveedor del servicio.