
Die Veränderungen, die GPT-6 mit sich bringt, bestehen nicht nur darin, dass die Modelle intelligenter werden, sondern darin, dass wir Aufgaben feiner verteilen, den Reasoning-Einsatz steuern und Kontext wiederverwenden können. Für Teams, die Inhalte und GEO erstellen, ist es wirklich untersuchenswert, nicht „welches Modell am stärksten ist“, sondern wie sich der Prozess aus Recherche, Schreiben, Prüfung und Veröffentlichung zuverlässiger gestalten lässt, während gleichzeitig die Kosten pro qualifiziertem Inhalt gesenkt werden.
¶ 1. Die Modelle werden immer stärker – warum sind Inhalte trotzdem nicht gut nutzbar?
Wenn du mit KI schon einmal Artikel in großen Mengen geschrieben hast, bist du mit hoher Wahrscheinlichkeit auf diese Situation gestoßen: Auf den ersten Blick ist die Struktur vollständig, die Sätze sind flüssig, sogar die Zusammenfassung wirkt ziemlich überzeugend. Prüft man aber sorgfältig nach, stellt man fest, dass Daten keine Quellen haben, Produktversionen nicht übereinstimmen oder dass nach zweitausend Wörtern die Frage, die Leser am meisten interessiert, immer noch nicht beantwortet wurde.
In diesem Moment ist die naheliegendste Lösung: zu einem stärkeren Modell wechseln.
Aber ich würde eher empfehlen, zuerst eine Frage zu stellen: Liegt das Problem tatsächlich in den Fähigkeiten des Modells oder im Arbeitsablauf?
Wenn keine zuverlässigen Materialien, keine klaren Aufgabenabgrenzungen und keine Prüfungsphase vor der Veröffentlichung vorhanden sind, kann ein Modellwechsel das grundlegende Problem nicht unbedingt lösen.
Der OpenAI-Leitfaden zur Nutzung von GPT-6 konzentriert sich tatsächlich auch nicht nur auf „Fähigkeitsupgrades“, sondern behandelt Modellauswahl, Reasoning-Stufen, Caching, Kontextkomprimierung und Multi-Agenten-Zusammenarbeit gemeinsam. Hervorgehoben wird: unterschiedliche Fähigkeiten konkreten Aufgaben dienen zu lassen und vor dem Go-live Erfolgsquote, Latenz und Kosten pro erfolgreicher Aufgabe zu messen.
Für Content-Teams ist dieser Ansatz sehr praktisch: Denke nicht nur daran, die KI mehr schreiben zu lassen, sondern sorge zuerst dafür, dass sie zuverlässiger liefert.
¶ 2. Wie wählt man Astra, Sol und Luna aus? Betrachte sie als unterschiedliche Rollen
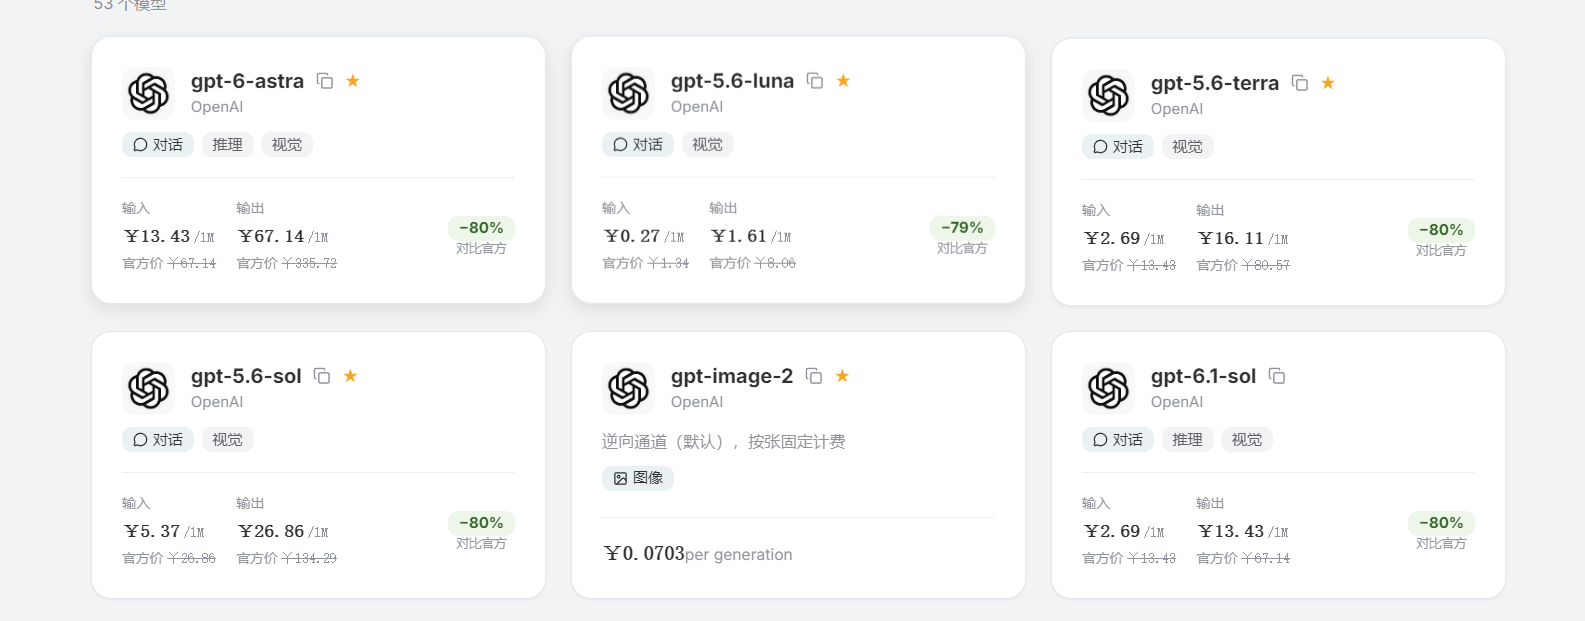
Gemäß der Positionierung im oben genannten offiziellen OpenAI-Leitfaden richtet sich GPT-6 Astra an die schwierigsten Reasoning-Aufgaben; GPT-6.1 Sol richtet sich an komplexes Coding, Recherche und Computeroperationen; GPT-6 Luna hingegen ist eher für klar definierte, skalierbar zu verarbeitende wiederkehrende Aufgaben geeignet, etwa Felderextraktion, Klassifizierung und strukturierte Zusammenfassungen.
Statt Parameter auswendig zu lernen, ist es besser, sie als unterschiedliche Rollen im Team zu verstehen.
Die folgende Tabelle enthält Empfehlungen zur Auswahl für das Content-Geschäft und ist kein offizielles Leistungsranking:
| Content-Schritt | Vorrangig zu bewertendes Modell | Hauptüberlegung |
|---|---|---|
| Artikelklassifizierung, Felderextraktion, Zusammenfassungen im festen Format | GPT-6 Luna | Aufgabe ist klar, zunächst Formatgenauigkeit und Stückkosten betrachten |
| Recherche aus mehreren Quellen, Materialaufbereitung, Artikelintegration | GPT-6.1 Sol | Erfordert quellenübergreifende Beurteilung und mehrstufige Ausführung |
| Kontroversenanalyse, komplexe Argumentation, Prüfung wichtiger Inhalte | GPT-6 Astra | Fehlerkosten sind höher, es wird eine tiefergehende Beurteilung benötigt |
Nehmen wir zum Beispiel an, wir bereiten einen Artikel darüber vor, „wie Unternehmen KI-Schnittstellen auswählen“. Um Preis- und Funktionsfelder aus den Dokumentationen verschiedener Anbieter zu extrahieren, muss nicht von Anfang an das stärkste Modell eingesetzt werden; um die Abwägungen verschiedener Lösungen in komplexen Geschäftsprozessen zu analysieren, lohnt es sich hingegen, mehr Reasoning-Ressourcen zu investieren.
Natürlich bedeutet das nicht, dass Inhalte, für die „kleine Modelle zuständig sind“, nicht geprüft werden müssen. Informationen wie Preise, Abrechnungseinheiten und Versionsnummern können auch bei bloßer Extraktion fehlerhaft sein.
Eine einfache Aufgabe bedeutet nur, dass die Verarbeitungsweise leichter sein kann, nicht dass die Abnahmestandards lockerer sein dürfen.
¶ 3. Die Reasoning-Stufe ist nicht umso besser, je höher sie ist – entscheidend ist, ob sich dieser Schritt lohnt
Nachdem das Modell ausgewählt wurde, gibt es noch eine Variable, die leicht übersehen wird: der Reasoning-Einsatz.
Der OpenAI-Leitfaden beschreibt Reasoning-Stufen als Abwägung zwischen Fähigkeit und Preis: Low entspricht regulärer Extraktion oder kleineren Überarbeitungen, Medium wird für Arbeiten eingesetzt, die Beurteilung erfordern, und High für tiefgehende Analysen und sorgfältige Prüfungen; höhere Stufen sollten erst verwendet werden, wenn sie vom Modell unterstützt werden und der zusätzliche Nutzen Zeit und Kosten rechtfertigt.
Einfach gesagt:
- Für die Änderung einer Überschrift muss das Modell nicht wiederholt Schlussfolgerungen herleiten.
- Beim Vergleich von drei Geschäftsoptionen kann man ihm mehr Denkspielraum geben.
- Um zu beurteilen, ob zwei Materialien in einem wesentlichen Konflikt stehen, lohnt sich eine sorgfältige Analyse.
Du kannst mit folgender Vorgehensweise beginnen zu testen:
| Aufgabe | Empfohlener Ausgangspunkt | Wann hochstufen |
|---|---|---|
| Tag-Kategorisierung, Formatkonvertierung | Niedriger Reasoning-Einsatz | Offensichtliche Mehrdeutigkeiten oder Regelkonflikte treten auf |
| Artikelgliederung, Optionsvergleich | Mittlerer Reasoning-Einsatz | Abwägungen können nicht erklärt werden, wichtige Bedingungen werden ausgelassen |
| Analyse von Faktenkonflikten, Prüfung wichtiger Schlussfolgerungen | Hoher Reasoning-Einsatz | Zentrale Probleme sind weiterhin nicht gelöst, dann höhere Stufen testen |
Hier gibt es einen wichtigen Unterschied: Länger nachzudenken bedeutet nicht, mehr Fakten zu wissen.
Wenn eine Aufgabe aktuelle Preise oder gerade veröffentlichte Produktinformationen benötigt, müssen zuerst die Quellen vervollständigt werden, statt lediglich die Reasoning-Stufe zu erhöhen. Wenn Belege fehlen, kann die beste Ausgabe lauten: „Diese Information lässt sich noch nicht bestätigen“, und nicht eine flüssigere Vermutung.
Außerdem ist die obige Tabelle eine Workflow-Empfehlung und keine allgemeine API-Parametertabelle. Welche Stufen und Parameternamen tatsächlich verfügbar sind, richtet sich nach dem jeweiligen Modell und der Integrationsdokumentation.
¶ 4. „Caching spart 95 %“ ist sehr attraktiv, aber rechne nicht falsch
Caching könnte einer der Optimierungspunkte sein, die bei der Content-Produktion in großen Mengen am meisten Aufmerksamkeit verdienen.
Markenvorstellungen, Schreibrichtlinien, feste Terminologielisten, Prüfanforderungen … diese Materialien erscheinen häufig wiederholt in jeder Anfrage. OpenAI empfiehlt, stabile Anweisungen und Referenzmaterialien vor den sich ändernden Aufgabendetails zu platzieren und Tool-Definitionen konsistent zu halten, damit gemeinsamer Kontext wiederverwendet werden kann. Der offizielle Leitfaden erwähnt, dass die Kosten für gecachte Eingaben im Vergleich zu nicht gecachten Eingaben je nach Modell um bis zu 95 % sinken können.
Aber hier muss unbedingt klar gesehen werden:
Wenn gecachte Eingaben 95 % günstiger sind, bedeutet das nicht, dass die Produktionskosten eines gesamten Artikels um 95 % sinken. Nehmen wir die offiziell veröffentlichten Standard-API-Preise für GPT-6.1 Sol als Beispiel: Pro einer Million Eingabe-Token fallen 2 US-Dollar an, für zwischengespeicherte Eingaben 0,10 US-Dollar und für Ausgaben 10 US-Dollar. Hier werden die offiziellen Standardpreise von OpenAI zitiert; sie stellen nicht die tatsächlichen Angebote dieser Website oder von Drittanbieter-Zugangskanälen dar. Bei Preisänderungen gilt die aktuellste Seite des Dienstanbieters.
Wir machen eine Beispielrechnung, kein Messergebnis:
Angenommen, eine Aufgabe hat:
- 20.000 Eingabe-Token;
- davon können 15.000 den Cache treffen;
- 3.000 Ausgabe-Token.
| Kostenposten | Alle Eingaben treffen den Cache nicht | 15.000 Eingaben treffen den Cache |
|---|---|---|
| Nicht zwischengespeicherte Eingaben | $0.0400 | $0.0100 |
| Zwischengespeicherte Eingaben | $0 | $0.0015 |
| Ausgabe | $0.0300 | $0.0300 |
| Gesamt | $0.0700 | $0.0415 |
Nach dieser Annahme sinken die Token-Kosten um etwa 40,7 %, nicht um 95 %.
Dabei sind Tool-Aufrufe, fehlgeschlagene Wiederholungsversuche, menschliche Prüfung sowie möglicherweise anfallende weitere Kosten noch nicht berücksichtigt.
Daher ist es zuverlässiger, Prompts in zwei Ebenen aufzuteilen:
Stabile Ebene: Markenrichtlinien, Schreibstil, Ausgabeformat, Prüfregeln.
Dynamische Ebene: das aktuelle Thema, die Zielgruppe, neu recherchierte Materialien, die aktuellen Aufgabenanforderungen.
Beobachten Sie dann die Cache-Treffersituation in echten Anfragen, statt „maximale Rabatte“ direkt in das Projektbudget zu schreiben.
¶ V. Multi-Agenten eignen sich gut für Recherche, aber nicht für Arbeitsteilung um der Geschäftigkeit willen
Ein Forschungsartikel umfasst häufig mehrere Aufgaben, die unabhängig vorangetrieben werden können:
- offizielle Dokumentationen prüfen;
- reale Beispiele finden;
- häufige Probleme sammeln;
- Preise und Funktionen abgleichen;
- Unterschiede zwischen verschiedenen Quellen ordnen.
Diese Aufgaben besitzen eine gewisse Unabhängigkeit und eignen sich für parallele Bearbeitung.
Der Leitfaden von OpenAI beschreibt, dass GPT-6.1 Sol in der Responses API unabhängige Aufgaben an Unteragenten delegieren und anschließend die Ergebnisse zusammenführen kann; diese Multi-Agenten-Fähigkeit ist im Leitfaden als Beta gekennzeichnet.
Multi-Agenten sind jedoch keine kostenlose Effizienzsteigerung.
In ihrer technischen Nachbetrachtung zu einem Forschungssystem erwähnt Anthropic, dass Multi-Agenten sich für Forschung eignen, die sich in mehrere unabhängige Richtungen entfaltet, aber den Token-Verbrauch deutlich erhöhen; in den von ihnen beobachteten Daten lag der Token-Verbrauch eines Multi-Agenten-Systems etwa beim 15-Fachen eines normalen Chats. Diese Zahl ist eine Erfahrung aus ihrem spezifischen System und kann nicht direkt auf alle Produkte übertragen werden.
Daher empfehle ich eher diese Organisation:
Mehrere Agenten sollen jeweils Belege finden, ein Redakteur soll den Artikel einheitlich organisieren, und anschließend soll ein Mensch die Prüfung übernehmen.
Lassen Sie nicht fünf Agenten jeweils fünf Abschnitte schreiben und diese dann direkt zusammensetzen. Dadurch entstehen leicht Wiederholungen, Widersprüche und ein uneinheitlicher Schreibstil.
Nachfolgend ist ein Ablaufdiagramm, das sich für den Einstieg eines Content-Teams eignet:
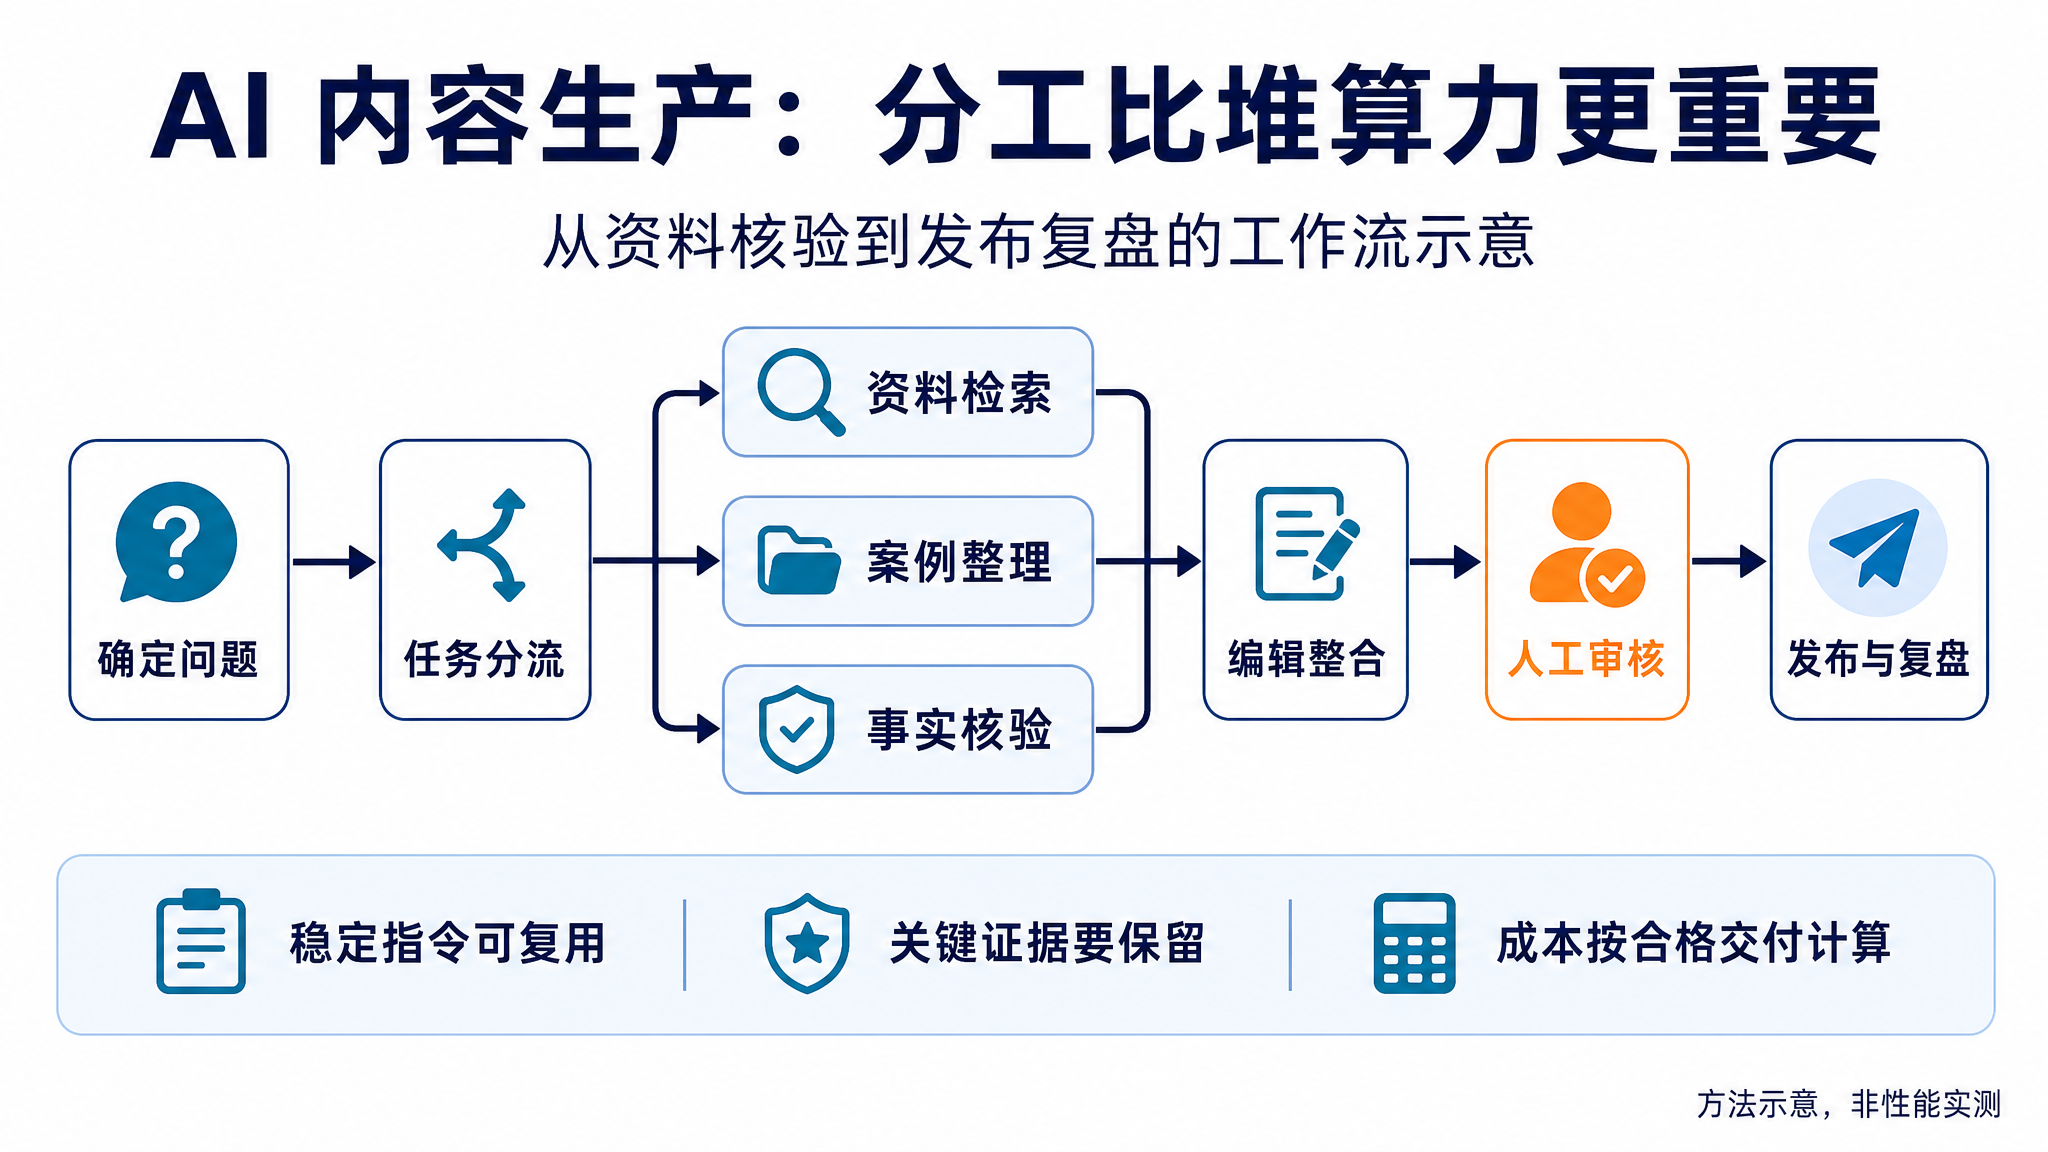
Die Abbildung ist eine mit GPT Image 2 erzeugte Methodendarstellung und stellt keine Leistungsmessung dar.
Damit dieser Ablauf wirklich nützlich ist, sollte jede Teilaufgabe idealerweise vier Dinge liefern:
- Schlussfolgerung: Was wurde festgestellt?
- Quelle: Wo befinden sich die Belege?
- Einschränkungen: Für welche Situationen gilt es nicht?
- Zu bestätigende Punkte: Worüber kann noch keine Schlussfolgerung gezogen werden?
Besonders wichtig: Faktenprüfung bedeutet nicht, dass ein anderes Modell „findet, dass dieser Abschnitt in Ordnung ist“, sondern dass es die Quellen erneut abgleicht.
Dass mehrere Agenten einer Meinung sind, bedeutet nicht, dass eine Tatsache bereits bewiesen ist.
¶ VI. Lange Aufgaben müssen den Status speichern, automatisierte Operationen müssen Befugnisse klar abgrenzen
Für einen kurzen Text kann es ausreichen, die Materialien in den Kontext zu legen. Bei Serien-Specials oder der fortlaufenden Pflege von Produktdokumentationen ist das anders.
Der Leitfaden von OpenAI beschreibt Kontextkomprimierung, um die Kontextgröße langer Gespräche zu verringern und zugleich den für die Fortsetzung der Aufgabe benötigten Status zu bewahren.
Für die Content-Arbeit empfehle ich, unabhängig von der verwendeten Komprimierungsmethode, eine separate Aufgabenaufzeichnung zu führen:
- bestätigte Fakten und ihre Quellen;
- die aktuell verwendete Produktversion;
- noch ungelöste Konflikte zwischen Materialien;
- abgeschlossene und nicht abgeschlossene Schritte;
- Entscheidungen, die zwingend menschlich bestätigt werden müssen.
Lassen Sie nicht nur vage Zusammenfassungen wie „Wir haben dieses Problem bereits untersucht“ zurück. Was für die spätere Schreibarbeit wirklich benötigt wird, sind Belege und Grenzen.
Bei automatisierten Operationen gilt dasselbe. Der offizielle Leitfaden empfiehlt, Schritte, die direkt über APIs oder bereits verbundene Tools erledigt werden können, vorrangig auf diese Weise auszuführen; erst wenn Bildschirm gelesen, geklickt oder Formulare ausgefüllt werden müssen, sollte die Fähigkeit zur Computerbedienung in Betracht gezogen werden.
Für Blog-Abläufe kann KI das Ordnen von Entwürfen, das Prüfen von Links und das Erzeugen von Bildern automatisch übernehmen, während die formelle Veröffentlichung, das Löschen von Artikeln und das Ändern von Online-Konfigurationen erst nach menschlicher Bestätigung erfolgen sollten.
Ein Backend bedienen zu können, bedeutet nicht, dass man unbegrenzte Berechtigungen haben sollte.
¶ VII. Zurück zu GEO: Schneller schreiben bedeutet nicht, leichter von KI zitiert zu werden
An dieser Stelle müssen zwei Fragen getrennt werden:
- KI zur Steigerung der Effizienz der Content-Produktion einsetzen;
- Inhalte in Antworten generativer Suchsysteme leichter auffindbar und zitierbar machen.
Ersteres ist eine Workflow-Frage, letzteres ist der Kern dessen, worauf GEO achtet.
Frühe GEO-Forschung beschäftigte sich mit der Sichtbarkeit von Inhalten in generativen Engines und berichtete unter ihren Evaluierungsbedingungen von einer maximalen Steigerung der Sichtbarkeit um etwa 40 %, wobei sie zugleich auf Unterschiede der Wirkung zwischen verschiedenen Bereichen hinwies. Dieses Ergebnis kann nicht direkt als „Wenn man es so macht, steigt der Traffic dieser Website um 40 %“ verstanden werden.
Die offizielle Erklärung von Google ist dagegen pragmatischer: Für AI Overviews und AI Mode sind keine zusätzlichen speziellen Optimierungsanforderungen nötig; grundlegendes SEO sowie zuverlässige und menschenzentrierte Inhalte bleiben wichtig. Seiten müssen für Indexierung und die Anzeige von Zusammenfassungen geeignet sein, um als unterstützende Links erscheinen zu können.
Das kann nicht die Regeln aller KI-Suchprodukte repräsentieren, erinnert uns aber zumindest daran: Suchen Sie nicht voreilig nach einer sogenannten „universellen GEO-Vorlage“. Für diesen Blog empfehle ich eher, zunächst die folgenden Dinge gut zu erledigen.
¶ 1. Ein Artikel löst ein echtes Problem
„Eine umfassende Analyse der Zukunft von KI“ klingt groß, ist aber nicht unbedingt nützlich.
„Bei der massenhaften Generierung von Produkttexten: Wie beurteilt man, ob Caching wirklich Geld spart?“, lässt sich dagegen leichter klar erklären und von Lesern direkt anwenden.
¶ 2. Zahlen mit ihren Anwendungsbedingungen ergänzen
Schreibe nicht nur „Kosten um 40 % gesunken“.
Es sollte erklärt werden, welches Modell verwendet wurde, wie gerechnet wurde, ob Ausgaben, Tools und Personalkosten enthalten sind und ob diese Zahl ein Testergebnis oder ein Rechenbeispiel zur Veranschaulichung ist.
¶ 3. Wichtige Inhalte nicht nur in Bildern verstecken
Google empfiehlt ausdrücklich, wichtige Inhalte in Textform darzustellen; auch strukturierte Daten sollten mit den sichtbaren Inhalten der Seite übereinstimmen.
Daher können Diagramme beim Verständnis helfen, aber der Fließtext sollte weiterhin Schlussfolgerungen, Daten und Bedingungen darlegen.
¶ 4. Fakten, Empfehlungen und Prognosen voneinander trennen
„Die offizielle Dokumentation unterstützt eine bestimmte Funktion“ ist eine Art von Information.
„Wir empfehlen dem Content-Team, sie so zu verwenden“ ist eine andere Art.
„In Zukunft könnte dies eine bestimmte Veränderung bewirken“ ist wiederum eine dritte Art.
Sie klar voneinander zu unterscheiden, ist wertvoller, als alle Sätze mit absoluter Gewissheit zu formulieren.
¶ 5. Tatsächliche Ergebnisse beobachten, nicht blind an Selbstbewertungsergebnisse glauben
Es kann ein fester Fragenkatalog erstellt werden, um regelmäßig zu dokumentieren, ob unterschiedliche KI-Suchprodukte diese Website zitieren, welchen Artikel sie zitieren und ob die Zitate korrekt sind, und dies anschließend mit tatsächlichen Zugriffs- und Konversionsanalysen zu verbinden.
Eine solche Nachverfolgung wird weiterhin von Zeit-, Regional- und Produktunterschieden beeinflusst, hat aber zumindest mehr Referenzwert, als einem Artikel einen „hohen GEO-Score“ ohne öffentlich zugängliche Grundlage zu geben.
¶ VIII. Wirklich optimiert werden sollten die „Kosten pro geeignetem Artikel“
Content-Teams konzentrieren sich leicht auf zwei Zahlen: wie viele Artikel pro Tag generiert werden und wie viele Token jeder Artikel verbraucht.
Wenn jedoch 100 Artikel generiert werden und letztlich nur 20 veröffentlicht werden können, ist diese Effizienz möglicherweise nicht besonders hoch.
Ich empfehle eher, diesen Indikator zu betrachten:
Kosten pro geeignetem Inhalt = Gesamte Produktionskosten ÷ Anzahl der Artikel, die die Prüfung bestanden haben
Dabei sollten die gesamten Produktionskosten Modellaufrufe, Recherchetools, Nacharbeit und menschliche Prüfung umfassen und nicht nur die Kosten der ersten Generierung.
Bei der tatsächlichen Umsetzung kann zunächst eine Reihe repräsentativer Aufgaben für klein angelegte Tests ausgewählt werden; es sollte nicht gleich zu Beginn die gesamte Website ausgerollt werden.
Wichtig ist, Folgendes zu dokumentieren:
| Kennzahl | Zu beantwortende Frage |
|---|---|
| Fehlerquote bei Fakten | Gibt es Erfindungen, veraltete Informationen oder Versionsverwechslungen? |
| Nachverfolgbarkeit der Quellen | Lassen sich für zentrale Schlussfolgerungen die ursprünglichen Belege finden? |
| Bestehensquote bei der ersten Prüfung | Wie viele Inhalte benötigen keine umfangreiche Nacharbeit? |
| Kosten pro geeignetem Artikel | Wie viel wurde einschließlich fehlgeschlagener Aufgaben und menschlicher Arbeit tatsächlich ausgegeben? |
| Lieferzeit | Wie lange dauert es von Beginn der Recherche bis zur Veröffentlichungsreife? |
| Wirkung nach der Veröffentlichung | Führt es zu wirksamen Zugriffen, Zitierungen oder geschäftlichen Konversionen? |
Erst nach den Tests sollte entschieden werden: Welche Aufgaben werden herabgestuft bearbeitet, bei welchen Schritten wird mehr Aufwand für Schlussfolgerungen investiert, welche Recherchen parallel durchgeführt werden sollten und welche Schritte unbedingt Menschen überlassen werden müssen.
¶ Zum Schluss: Klugheit dort einsetzen, wo sie gebraucht wird
GPT-6 bietet Content-Teams mehr Auswahlmöglichkeiten, doch mehr Auswahl bedeutet nicht, dass bei jedem Schritt die stärkste Konfiguration eingesetzt werden muss.
Eine eher lohnenswerte Richtung ist:
Einfache Aufgaben leichtgewichtig bearbeiten, bei komplexen Beurteilungen sorgfältig Schlussfolgern, wiederholte Kontexte möglichst wiederverwenden, unabhängige Recherchen angemessen parallelisieren und vor der offiziellen Veröffentlichung eine Prüfung beibehalten.
Für GEO gilt dasselbe.
Kein Modell kann für einen Artikel garantieren, zitiert zu werden. Was wir tun können, ist, reale Fragen zu beantworten, nachvollziehbare Belege bereitzustellen und den Anwendungsbereich klar zu erläutern.
Letztlich ist es nicht wirklich erstrebenswert, „die KI etwas mehr schreiben zu lassen“, sondern:
Jeden veröffentlichten Inhalt lesenswerter und zugleich belastbarer gegenüber Prüfungen zu machen.
¶ Referenzmaterialien
- OpenAI: Praxisleitfaden für GPT-6
- OpenAI: Introducing GPT-6.1 Sol
- Anthropic: How we built our multi-agent research system
- GEO: Generative Engine Optimization(KDD 2024)
- Google Search Central: AI features and your website
Dieser Artikel ist eine Zusammenstellung von Materialien und eine Anwendungsanalyse und stellt keinen Leistungstest dieser Website dar. Modellfähigkeiten, Testphasen und Preise können sich ändern; maßgeblich ist die jeweils aktuellste Dokumentation des Dienstanbieters.