
التغييرات التي يجلبها GPT-6 لا تقتصر على أن النموذج أصبح أذكى، بل تشمل قدرتنا على توزيع المهام بدقة أكبر، والتحكم في استثمار الاستدلال، وإعادة استخدام السياق. بالنسبة للفرق التي تعمل في المحتوى وGEO، فإن ما يستحق الدراسة حقًا ليس «أي نموذج هو الأقوى»، بل كيفية جعل مسار البحث والكتابة والتحقق والنشر أكثر موثوقية، مع خفض تكلفة كل محتوى مؤهل.
¶ أولًا، النماذج تزداد قوة، فلماذا لا يزال المحتوى غير عملي؟
إذا كنت قد استخدمت الذكاء الاصطناعي لكتابة المقالات بكميات كبيرة، فمن المرجح أنك واجهت هذا الوضع: للوهلة الأولى، يبدو الهيكل مكتملًا والجمل سلسة، وحتى الملخص يبدو مقنعًا إلى حد ما. لكن عند التحقق بعناية، تكتشف أن البيانات بلا مصادر، أو أن إصدارات المنتجات لا تتطابق، أو أن المقالة كتبت ألفي كلمة وما زالت لم تجب عن السؤال الذي يهم القارئ أكثر من غيره.
في هذه المرحلة، يكون الحل الأسهل الذي يتبادر إلى الذهن هو: استبدال النموذج بآخر أقوى.
لكنني أقترح أن نسأل أولًا: هل تكمن المشكلة فعلًا في قدرات النموذج، أم في سير العمل؟
إذا لم تكن هناك مواد موثوقة، ولا حدود واضحة للمهمة، ولا مرحلة تحقق قبل النشر، فقد لا يحل تغيير النموذج المشكلة الجذرية.
دليل استخدام GPT-6 من OpenAI لا يدور في الواقع حول «ترقية القدرات» وحدها، بل يناقش اختيار النماذج، ومستويات الاستدلال، والتخزين المؤقت، وضغط السياق، وتعاون الوكلاء المتعددين معًا. وما يؤكد عليه هو: جعل القدرات المختلفة تخدم مهام محددة، وقياس معدل النجاح والتأخير وتكلفة كل مهمة ناجحة قبل الإطلاق.
بالنسبة لفرق المحتوى، هذه الفكرة عملية جدًا: لا تفكروا فقط في جعل الذكاء الاصطناعي يكتب أكثر، بل اجعلوه يسلّم نتائج أكثر استقرارًا أولًا.
¶ ثانيًا، كيف نختار بين Astra وSol وLuna؟ اعتبروها وظائف مختلفة
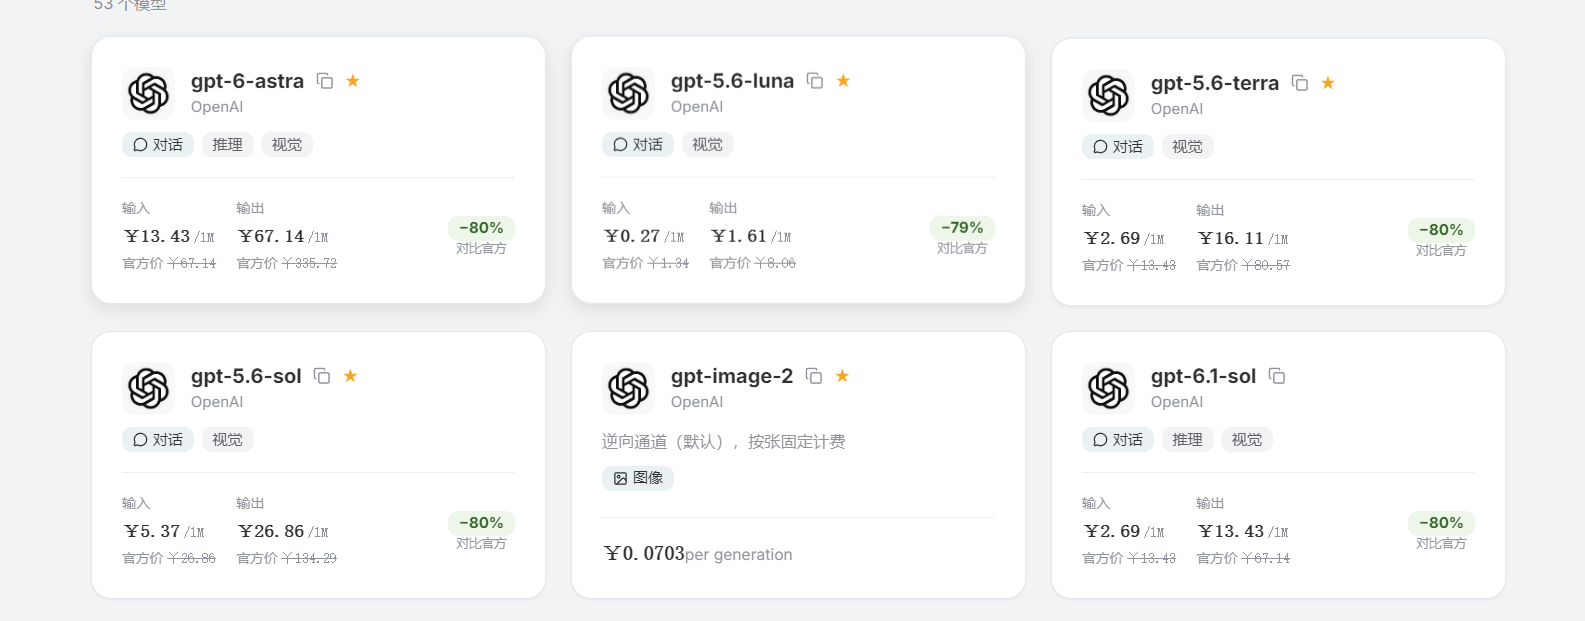
وفقًا لتحديد دليل OpenAI الرسمي المذكور أعلاه، فإن GPT-6 Astra موجه لأصعب أعمال الاستدلال؛ وGPT-6.1 Sol موجه للبرمجة المعقدة والبحث وعمليات الكمبيوتر؛ بينما يميل GPT-6 Luna أكثر إلى المهام المتكررة ذات الأهداف الواضحة والتي تحتاج إلى معالجة على نطاق واسع، مثل استخراج الحقول والتصنيف والملخصات المنظمة.
بدلًا من حفظ المعلمات عن ظهر قلب، من الأفضل فهمها باعتبارها وظائف مختلفة داخل الفريق.
الجدول التالي هو اقتراح لاختيار النماذج مقدم بالاستناد إلى أعمال المحتوى، وليس ترتيبًا رسميًا للأداء:
| مرحلة المحتوى | النموذج المقترح لتقييمه أولًا | الاعتبار الرئيسي |
|---|---|---|
| تصنيف المقالات، استخراج الحقول، ملخصات بصيغة ثابتة | GPT-6 Luna | المهمة واضحة، ابدأ بمراجعة دقة التنسيق وتكلفة الوحدة |
| البحث من مصادر متعددة، تنظيم المواد، دمج المقالات | GPT-6.1 Sol | يتطلب الحكم عبر المواد وتنفيذ خطوات متعددة |
| تحليل الخلافات، الاستدلال المعقد، مراجعة المحتوى المهم | GPT-6 Astra | تكلفة الخطأ أعلى، ويتطلب حكمًا أكثر تعمقًا |
على سبيل المثال، نحن نستعد لكتابة مقالة بعنوان «كيف تختار الشركات واجهة AI». لا حاجة إلى استخدام أقوى نموذج منذ البداية لاستخراج حقول الأسعار والميزات من وثائق الجهات المختلفة؛ أما تحليل المفاضلات بين الحلول المختلفة في الأعمال المعقدة، فيستحق استثمار المزيد من موارد الاستدلال.
بالطبع، هذا لا يعني أن «المحتوى الذي تتولاه النماذج الصغيرة لا يحتاج إلى فحص». فمعلومات مثل الأسعار ووحدات الفوترة وأرقام الإصدارات، حتى لو كانت مجرد عملية استخراج، قد تحتوي على أخطاء.
بساطة المهمة تعني فقط أن طريقة المعالجة يمكن أن تكون أخف، ولا تعني أن معايير القبول يمكن أن تكون أكثر تساهلًا.
¶ ثالثًا، مستوى الاستدلال ليس كلما ارتفع كان أفضل، بل يجب النظر إلى ما إذا كانت هذه الخطوة تستحق ذلك
بعد اختيار النموذج، هناك متغير آخر يسهل تجاهله: استثمار الاستدلال.
يصف دليل OpenAI مستويات الاستدلال بأنها موازنة بين القدرة والسعر: يقابل Low الاستخراج الاعتيادي أو التعديلات البسيطة، ويستخدم Medium للأعمال التي تحتاج إلى حكم، ويستخدم High للتحليل العميق والمراجعة الدقيقة؛ أما المستويات الأعلى، فينبغي استخدامها فقط عندما يدعمها النموذج، وعندما تستحق الفائدة الإضافية الوقت والتكلفة.
وبشكل مباشر:
- لا حاجة إلى أن يجعل النموذج يستنتج مرارًا وتكرارًا من أجل تعديل عنوان.
- عند مقارنة ثلاثة حلول أعمال، يمكن منحه مساحة أكبر قليلًا للتفكير.
- إن الحكم على وجود تعارض جوهري بين مادتين يستحق تحليلًا جادًا.
يمكن البدء بالاختبار وفق الطريقة التالية:
| المهمة | نقطة البداية المقترحة | متى تتم الترقية |
|---|---|---|
| تصنيف العلامات، تحويل التنسيق | استثمار استدلال منخفض | ظهور غموض واضح أو تعارض في القواعد |
| مخطط المقالة، مقارنة الحلول | استثمار استدلال متوسط | عدم القدرة على تفسير المفاضلات، وإغفال الشروط الرئيسية |
| تحليل تعارض الحقائق، مراجعة الاستنتاجات المهمة | استثمار استدلال مرتفع | استمرار عدم حل المشكلات الرئيسية، ثم اختبار مستويات أعلى |
هناك فرق مهم هنا: التفكير لفترة أطول لا يعني معرفة حقائق أكثر.
إذا كانت المهمة تتطلب أحدث الأسعار أو معلومات المنتجات التي أُطلقت للتو، فيجب أولًا استكمال المصادر، بدلًا من رفع مستوى الاستدلال فحسب. عند غياب الأدلة، قد تكون أفضل نتيجة هي «لا تزال هذه المعلومة غير قابلة للتأكيد»، لا فقرة أكثر سلاسة من التخمين.
بالإضافة إلى ذلك، الجدول أعلاه هو اقتراح لسير العمل، وليس جدول معلمات API عامًا. يجب أن تستند المستويات وأسماء المعلمات المتاحة فعليًا إلى النموذج المحدد ووثائق التكامل.
¶ رابعًا، «التخزين المؤقت يوفر 95%» أمر جذاب، لكن لا تخطئ في الحسابات
قد يكون التخزين المؤقت أحد أكثر نقاط التحسين التي تستحق الاهتمام في إنتاج المحتوى بكميات كبيرة.
تعريف العلامة التجارية، وإرشادات الكتابة، وقائمة المصطلحات الثابتة، ومتطلبات المراجعة... هذه المواد تتكرر غالبًا في كل طلب. توصي OpenAI بوضع التعليمات الثابتة والمواد المرجعية قبل تفاصيل المهمة المتغيرة، والحفاظ على اتساق تعريفات الأدوات، من أجل إعادة استخدام السياق المشترك. ويشير الدليل الرسمي إلى أن تكلفة المدخلات المخزنة مؤقتًا يمكن أن تنخفض بنسبة تصل إلى 95% مقارنة بالمدخلات غير المخزنة مؤقتًا، بحسب النموذج.
لكن هنا يجب الانتباه جيدًا:
كون المدخلات المخزنة مؤقتًا أرخص بنسبة 95% لا يعني أن تكلفة إنتاج المقالة كاملة انخفضت بنسبة 95%. على سبيل المثال، وفقًا لـأسعار واجهة برمجة التطبيقات القياسية الرسمية لـ GPT-6.1 Sol: تبلغ تكلفة كل مليون token إدخال 2 دولار، والإدخال المخزّن مؤقتًا 0.10 دولار، والإخراج 10 دولارات. الأسعار المذكورة هنا هي الأسعار القياسية الرسمية لـ OpenAI، ولا تمثل العرض الفعلي لهذا الموقع أو لقنوات الوصول التابعة لجهات خارجية، وبالنسبة لتغيرات الأسعار يُرجى الرجوع إلى أحدث صفحة لمقدّم الخدمة.
لنقم بـمثال توضيحي، وليس نتيجة قياس فعلية:
لنفترض أن مهمة واحدة تحتوي على:
- 20,000 token إدخال؛
- منها 15,000 يمكن أن تصيب التخزين المؤقت؛
- 3,000 token إخراج.
| بند التكلفة | جميع المدخلات لا تصيب التخزين المؤقت | 15,000 إدخال تصيب التخزين المؤقت |
|---|---|---|
| إدخال غير مخزّن مؤقتًا | $0.0400 | $0.0100 |
| إدخال مخزّن مؤقتًا | $0 | $0.0015 |
| الإخراج | $0.0300 | $0.0300 |
| الإجمالي | $0.0700 | $0.0415 |
وفقًا لهذا الافتراض، تنخفض تكلفة token بنحو 40.7%، وليس 95%.
وفوق ذلك، لا يشمل هذا استدعاءات الأدوات، وإعادة المحاولة بعد الفشل، والمراجعة البشرية، وغيرها من الرسوم التي قد تنطبق.
لذلك، تتمثل الطريقة الأكثر موثوقية في تقسيم المطالبة إلى طبقتين:
الطبقة المستقرة: معايير العلامة التجارية، وأسلوب الكتابة، وتنسيق الإخراج، وقواعد المراجعة.
الطبقة الديناميكية: موضوع هذه المرة، والقراء المستهدفون، والمواد التي جرى استرجاعها حديثًا، ومتطلبات المهمة الحالية.
ثم راقب حالات إصابة التخزين المؤقت في الطلبات الفعلية، بدلًا من إدراج «أعلى خصم» مباشرةً في ميزانية المشروع بمجرد رؤيته.
¶ خامسًا، الوكلاء المتعددون مناسبون جدًا للبحث، لكن ليس لتقسيم العمل لمجرد التظاهر بالنشاط
غالبًا ما تتضمن مقالة بحثية عدة مهام يمكن دفعها بشكل مستقل:
- البحث في الوثائق الرسمية؛
- العثور على حالات فعلية؛
- جمع الأسئلة الشائعة؛
- التحقق من الأسعار والميزات؛
- تنظيم الخلافات بين المصادر المختلفة.
تتمتع هذه المهام بدرجة من الاستقلالية، وهي مناسبة للمعالجة المتوازية.
يشرح دليل OpenAI أن GPT-6.1 Sol يمكنه في Responses API إسناد المهام المستقلة إلى وكلاء فرعيين، ثم تجميع النتائج؛ وقد وُسِمت قدرة الوكلاء المتعددين هذه في الدليل بأنها beta.
لكن الوكلاء المتعددين ليسوا تحسينًا مجانيًا للكفاءة.
ذكرت Anthropic في مراجعتها الهندسية لنظامها البحثي أن الوكلاء المتعددين مناسبون للبحوث التي تتوسع في اتجاهات مستقلة متعددة، لكنهم يزيدون استهلاك token بشكل ملحوظ؛ وفي البيانات التي راقبوها، كان استخدام token في نظام الوكلاء المتعددين يعادل نحو 15 ضعفًا للمحادثة العادية. ينتمي هذا الرقم إلى تجربة نظامهم المحدد، ولا يمكن تطبيقه مباشرةً على جميع المنتجات.
لذلك، أوصي أكثر بالترتيب التالي:
دع عدة وكلاء يبحثون عن الأدلة كلٌّ على حدة، ودع محررًا واحدًا ينظم المقالة بشكل موحّد، ثم يتولى البشر التدقيق.
لا تدع خمسة وكلاء يكتبون خمس فقرات كلٌّ على حدة، ثم تجمعها مباشرةً. فمن السهل جدًا أن تظهر بهذه الطريقة التكرارات والتناقضات وعدم اتساق الأسلوب.
فيما يلي مخطط سير عمل مناسب لبدء فريق المحتوى:
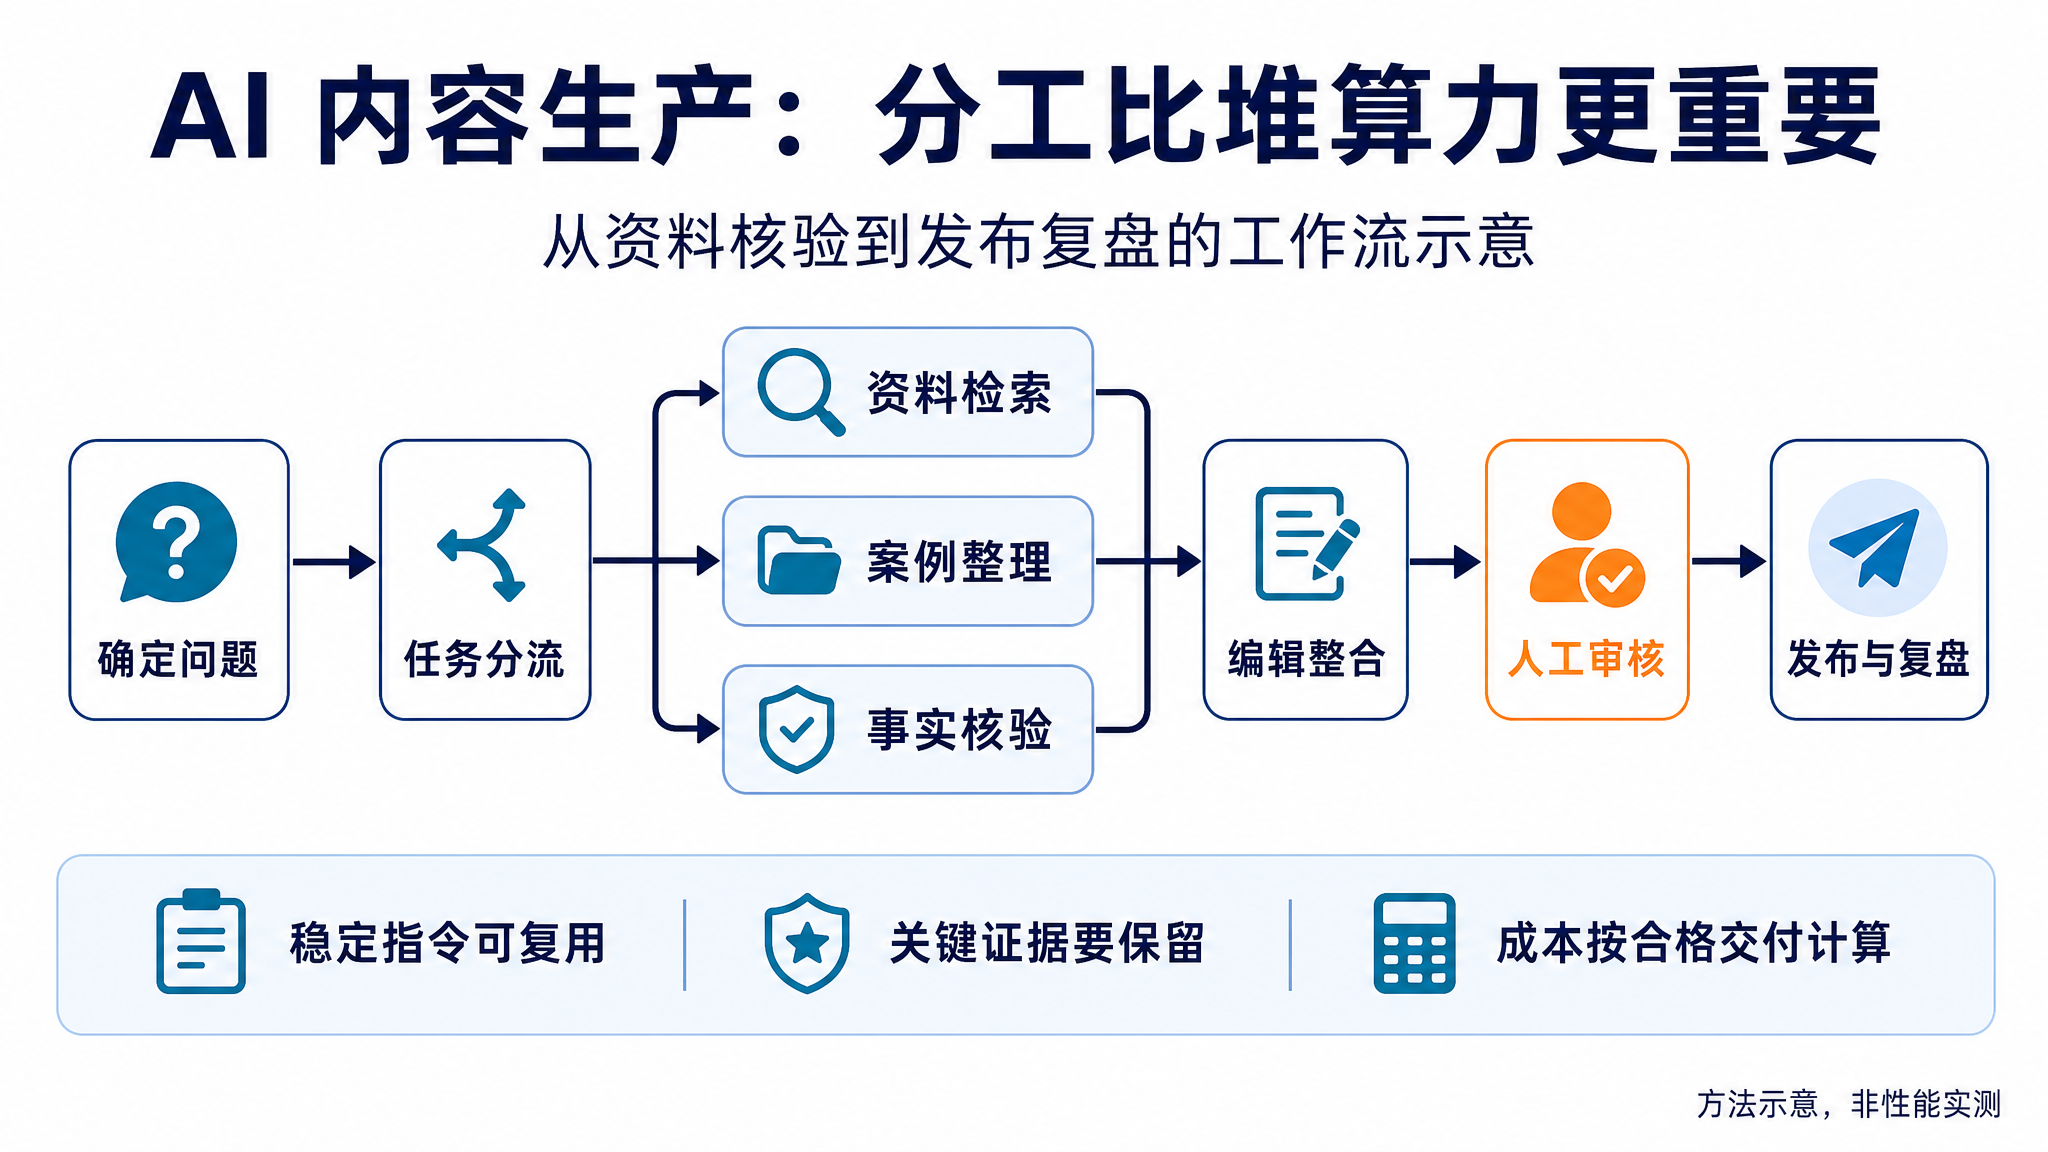
الصورة التوضيحية هي مخطط لطريقة مولّد بواسطة GPT Image 2، ولا تمثل قياسًا فعليًا للأداء.
لكي يكون هذا التدفق مفيدًا حقًا، من الأفضل أن يسلّم كل عمل فرعي أربعة أشياء:
- الاستنتاج: ما الذي تم اكتشافه.
- المصادر: أين توجد الأدلة.
- القيود: ما الحالات التي لا ينطبق عليها.
- المسائل التي تحتاج إلى تأكيد: ما الذي لا يزال لا يمكن الجزم بشأنه.
ينبغي الانتباه بشكل خاص: التحقق من الحقائق لا يعني أن تجعل نموذجًا آخر «يعتقد أن هذه الفقرة لا مشكلة فيها»، بل أن تجعله يقارنها بالمصادر من جديد.
اتفاق عدة وكلاء في الرأي لا يعني أن الحقيقة قد أُثبتت بالفعل.
¶ سادسًا، يجب حفظ الحالة للمهام الطويلة، ويجب تحديد الصلاحيات للعمليات التلقائية بوضوح
عند كتابة مقال قصير، قد يكفي وضع المواد في السياق. أما عند إعداد سلسلة موضوعات خاصة أو صيانة وثائق المنتج باستمرار، فالأمر مختلف.
يشرح دليل OpenAI ضغط السياق، ويُستخدم لتقليل حجم سياق المحادثات الطويلة، مع الاحتفاظ بالحالة اللازمة لمواصلة المهمة.
بالنسبة إلى عمل المحتوى، أوصي، مهما كانت طريقة الضغط المعتمدة، بالحفاظ بشكل منفصل على سجل للمهمة:
- الحقائق المؤكدة ومصادرها؛
- إصدار المنتج المستخدم حاليًا؛
- تعارضات المواد التي لم تُحل بعد؛
- المراحل المكتملة وغير المكتملة؛
- القرارات التي يجب تأكيدها بشريًا.
لا تترك فقط ملخصًا غامضًا مثل «لقد بحثنا هذا السؤال بالفعل». ما تحتاجه الكتابة اللاحقة حقًا هو الأدلة والحدود.
الأمر نفسه ينطبق على العمليات التلقائية. يوصي الدليل الرسمي بإعطاء الأولوية للخطوات التي يمكن إكمالها مباشرةً باستخدام API أو الأدوات المتصلة؛ وعندما يلزم قراءة الشاشة أو النقر أو ملء النماذج، عندها فقط ينبغي التفكير في قدرات تشغيل الحاسوب.
بالنسبة إلى سير عمل المدونة، يمكن السماح للذكاء الاصطناعي بتنظيم المسودات تلقائيًا، وفحص الروابط، وإنشاء الصور التوضيحية، لكن اجعل النشر الرسمي وحذف المقالات وتعديل الإعدادات المنشورة بعد التأكيد البشري.
القدرة على تشغيل لوحة الإدارة لا تعني أنه ينبغي امتلاك صلاحيات غير محدودة.
¶ سابعًا، العودة إلى GEO: الكتابة بسرعة أكبر لا تعني أن الذكاء الاصطناعي سيستشهد بها بسهولة أكبر
عند هذه النقطة، يجب فصل مسألتين:
- استخدام الذكاء الاصطناعي لتحسين كفاءة إنتاج المحتوى؛
- جعل المحتوى أسهل في العثور عليه والاستشهاد به ضمن إجابات البحث التوليدي.
الأولى هي مسألة سير عمل، أما الثانية فهي جوهر اهتمام GEO.
تتناول أبحاث GEO المبكرة قابلية ظهور المحتوى في المحركات التوليدية، وتفيد بأن أعلى تحسن في قابلية الظهور بلغ نحو 40% ضمن إعدادات التقييم الخاصة بها، مع الإشارة إلى وجود اختلافات في التأثير بين المجالات المختلفة. لا يمكن فهم هذه النتيجة مباشرةً على أنها «افعل ذلك، وسوف تزيد زيارات هذا الموقع بنسبة 40%».
أما التوضيح الرسمي من Google فهو أكثر عملية: بالنسبة إلى AI Overviews وAI Mode، لا توجد حاجة إلى مجموعة إضافية من متطلبات التحسين الخاصة؛ فما زال SEO الأساسي والمحتوى الموثوق والمتمحور حول الإنسان مهمين. يجب أن تكون الصفحة مؤهلة للفهرسة وعرض المقتطفات، حتى تتاح لها فرصة الظهور كرابط داعم.
لا يعني هذا أنه يمثل قواعد جميع منتجات البحث بالذكاء الاصطناعي، لكنه يذكّرنا على الأقل: لا تتعجل في البحث عما يسمى «قالب GEO الشامل». بالنسبة لمدونة هذا الموقع، أوصي أكثر بإتقان الأمور التالية أولًا.
¶ 1. أن تحل كل مقالة مشكلة حقيقية واحدة
"تحليل شامل لمستقبل الذكاء الاصطناعي" يبدو كبيرًا، لكنه ليس بالضرورة مفيدًا.
أما "عند إنشاء نصوص المنتجات بالجملة، كيف نحكم إن كانت الذاكرة المؤقتة توفر المال فعلًا"، فمن الأسهل شرحه، كما يسهل على القراء تطبيقه مباشرة.
¶ 2. إضافة شروط الانطباق إلى الأرقام
لا تكتب فقط "انخفضت التكلفة بنسبة 40%".
يجب توضيح النموذج المستخدم، وطريقة الحساب، وما إذا كانت تشمل المخرجات وتكاليف الأدوات والعمل البشري، وما إذا كان هذا الرقم نتيجة تجربة أم مثالًا توضيحيًا.
¶ 3. عدم إخفاء المحتوى الرئيسي داخل الصور فقط
توصي Google بوضوح بعرض المحتوى المهم بصيغة نصية، كما ينبغي أن تظل البيانات المنظمة متسقة مع المحتوى الظاهر في الصفحة.
لذلك، يمكن للرسوم البيانية أن تساعد على الفهم، لكن ينبغي للنص الأساسي أن يوضح الاستنتاجات والبيانات والشروط.
¶ 4. فصل الحقائق والنصائح والتوقعات
"تدعم الوثائق الرسمية ميزة معينة" هو نوع من المعلومات.
"نوصي فريق المحتوى باستخدامها بهذه الطريقة" هو نوع آخر.
"قد يؤدي ذلك إلى نوع معين من التغيير في المستقبل" هو النوع الثالث.
إن التمييز الواضح بينها أكثر قيمة من كتابة جميع الجمل بلهجة قاطعة.
¶ 5. مراقبة النتائج الحقيقية، وعدم الإيمان الأعمى بدرجات التقييم الذاتي
يمكن إنشاء مجموعة ثابتة من الأسئلة، وتسجيل ما إذا كانت منتجات البحث المختلفة بالذكاء الاصطناعي تستشهد بهذا الموقع بانتظام، وأي مقالة تستشهد بها، وما إذا كان الاستشهاد دقيقًا، ثم دمج ذلك مع تحليل الزيارات الفعلية والتحويلات.
سيظل هذا التتبع متأثرًا بالوقت والمنطقة واختلافات المنتجات، لكنه على الأقل أكثر قيمة مرجعية من منح المقالة "درجة GEO مرتفعة" دون أساس معلن.
¶ ثامنًا، ما ينبغي تحسينه حقًا هو "تكلفة كل مقالة مؤهلة"
من السهل أن يركز فريق المحتوى على رقمين: كم مقالة تُنشأ في يوم واحد، وكم token تستهلك كل مقالة.
لكن إذا تم إنشاء 100 مقالة، ولم يكن من الممكن نشر سوى 20 منها في النهاية، فقد لا تكون هذه الكفاءة مرتفعة.
أوصي أكثر بالنظر إلى هذا المؤشر:
تكلفة المحتوى المؤهل لكل مقالة = إجمالي تكلفة الإنتاج ÷ عدد المقالات التي اجتازت المراجعة
ومن بينها، ينبغي أن تشمل إجمالي تكلفة الإنتاج استدعاءات النموذج، وأدوات الاسترجاع، وإعادة العمل والمراجعة البشرية، لا مجرد تكلفة الإنشاء الأولى.
عند التطبيق الفعلي، يمكن أولًا اختيار مجموعة من المهام التمثيلية لإجراء اختبار صغير النطاق، ولا تنشره على مستوى الموقع بأكمله من البداية.
ركّز على تسجيل:
| المؤشر | السؤال الذي يجب الإجابة عنه |
|---|---|
| معدل الأخطاء الواقعية | هل توجد معلومات مختلقة أو قديمة أو خلط بين الإصدارات؟ |
| قابلية تتبع المصادر | هل يمكن العثور على الأساس الأصلي للاستنتاجات الرئيسية؟ |
| معدل اجتياز المراجعة الأولى | كم محتوى لا يحتاج إلى إعادة عمل كبيرة؟ |
| تكلفة كل مقالة مؤهلة | بعد تضمين المهام الفاشلة والعمل البشري، كم تم إنفاقه فعلًا؟ |
| مدة التسليم | من بدء الاسترجاع إلى إمكانية النشر، كم يستغرق ذلك؟ |
| النتائج بعد النشر | هل يجلب زيارات فعالة أو استشهادات أو تحويلات تجارية؟ |
بعد الاختبار، قرر بعد ذلك: أي المهام تُعالج بمستوى أدنى، وأي المراحل تزيد الاستثمار في الاستدلال، وأي الأبحاث تستحق التنفيذ بالتوازي، وأي الخطوات يجب تسليمها إلى البشر.
¶ في الختام: استخدم الذكاء في المكان الذي ينبغي استخدامه فيه
يوفر GPT-6 لفريق المحتوى خيارات أكثر، لكن زيادة الخيارات لا تعني أن كل خطوة تحتاج إلى أقوى إعداد.
الاتجاه الذي يستحق التجربة أكثر هو:
معالجة المهام البسيطة بخفة، والاستدلال الجاد في الأحكام المعقدة، وإعادة استخدام السياقات المتكررة قدر الإمكان، وتنفيذ الأبحاث المستقلة بالتوازي باعتدال، والإبقاء على المراجعة قبل النشر الرسمي.
وينطبق الأمر نفسه على GEO.
لا يوجد نموذج يمكنه أن يضمن الاستشهاد بمقالة ما. ما يمكننا فعله هو جعلها تجيب عن أسئلة حقيقية، وتقدم أدلة قابلة للتتبع، وتوضح نطاق الانطباق بجلاء.
في نهاية المطاف، ما يستحق السعي إليه حقًا ليس "جعل الذكاء الاصطناعي يكتب أكثر"، بل:
جعل كل محتوى يُنشر أكثر جدارة بالقراءة، وأكثر قدرة على الصمود أمام الفحص.
¶ المراجع
- OpenAI: دليل GPT-6 العملي
- OpenAI: Introducing GPT-6.1 Sol
- Anthropic: How we built our multi-agent research system
- GEO: Generative Engine Optimization(KDD 2024)
- Google Search Central: AI features and your website
هذه المقالة عبارة عن تجميع للمراجع وتحليل للتطبيقات، ولا تُعد اختبارًا عمليًا لأداء هذا الموقع. قد تتغير قدرات النموذج ومراحل الاختبار والأسعار، لذا يُرجى الرجوع إلى أحدث وثائق مزود الخدمة.